Mente aliena: Jakub Pachocki e i modelli AI che non capiamo
Il capo scienziato di OpenAI avverte: i modelli di AI non vengono progettati, ma allevati. Analizziamo il suo saggio e cosa significa per il futuro.
👁 112 letture
Il responsabile scientifico dell’azienda che costruisce alcuni dei modelli più potenti al mondo ha scritto di non comprendere fino in fondo ciò che cresce nel suo laboratorio. Non è l’opinione di un critico o di un rivale: a scriverlo è colui che dal 2024 guida la ricerca di OpenAI.
Estate del 2023, uffici di OpenAI a San Francisco. Il progetto di ricerca si chiama RLSlow - un nome che, alla luce degli eventi successivi, suona quasi ironico - e sta mostrando i suoi primi frutti. Il team si convince che i modelli di ragionamento possono scalare: un modello addestrato è capace di elaborare una propria catena di pensiero e di migliorarla a ogni passaggio. Jakub Pachocki e un collega, chiamato nel saggio semplicemente Szymon, rimangono in ufficio per la notte. Non stappano champagne. Come racconta Pachocki, cercano di elaborare il pensiero disarmante che, nel corso della loro vita, vedranno macchine nettamente più intelligenti di loro.1
Pachocki non specifica il cognome di Szymon, ma è quasi impossibile non pensare a Szymon Sidor, di cui Sam Altman ha scritto sul suo blog che senza di lui e Pachocki OpenAI non sarebbe ciò che è oggi.2 Entrambi hanno frequentato la stessa classe del III liceo a Gdynia, in Polonia.3 Se quella notte alla scrivania c’era proprio lui, due compagni di scuola stavano osservando il risultato che tre anni dopo avrebbe spinto un pezzo consistente dell’economia globale. E invece di misurare punteggi nei benchmark, riflettevano su come avvisare l’umanità.
Il saggio si intitola “An Alien Mind” (“Una mente aliena”). È apparso sul sito di OpenAI il 6 settembre 2026. Ho delineato il profilo dell’autore nell’articolo dedicato a Jakub Pachocki e ho riassunto le tesi principali nel commento del giorno di pubblicazione. Qui voglio procedere con calma, come leggendo la lettera di qualcuno che siede vicino alla finestra e ha una visuale più ampia, confrontando le sue tesi con ciò che noto ogni giorno nei test sui modelli.
Coltivati, non progettati
La frase chiave del saggio è breve e si rischia di trascurarla. Pachocki scrive che l’intelligenza artificiale è “più coltivata che progettata”.1 Non è un artificio retorico, ma la descrizione del processo. Si definisce un semplice ciclo di ottimizzazione e lo si ripete un numero incalcolabile di volte su una mole spropositata di potenza di calcolo. Il risultato finale è così complesso che i ricercatori lo studiano come i neuroscienziati studiano il cervello: scoprono singoli circuiti, ma non sanno descrivere l’insieme. Gli addestramenti su larga scala, secondo Pachocki, sono fondamentalmente esperimenti i cui esiti sorprendono gli stessi autori; più il sistema è potente, più diventa indecifrabile.
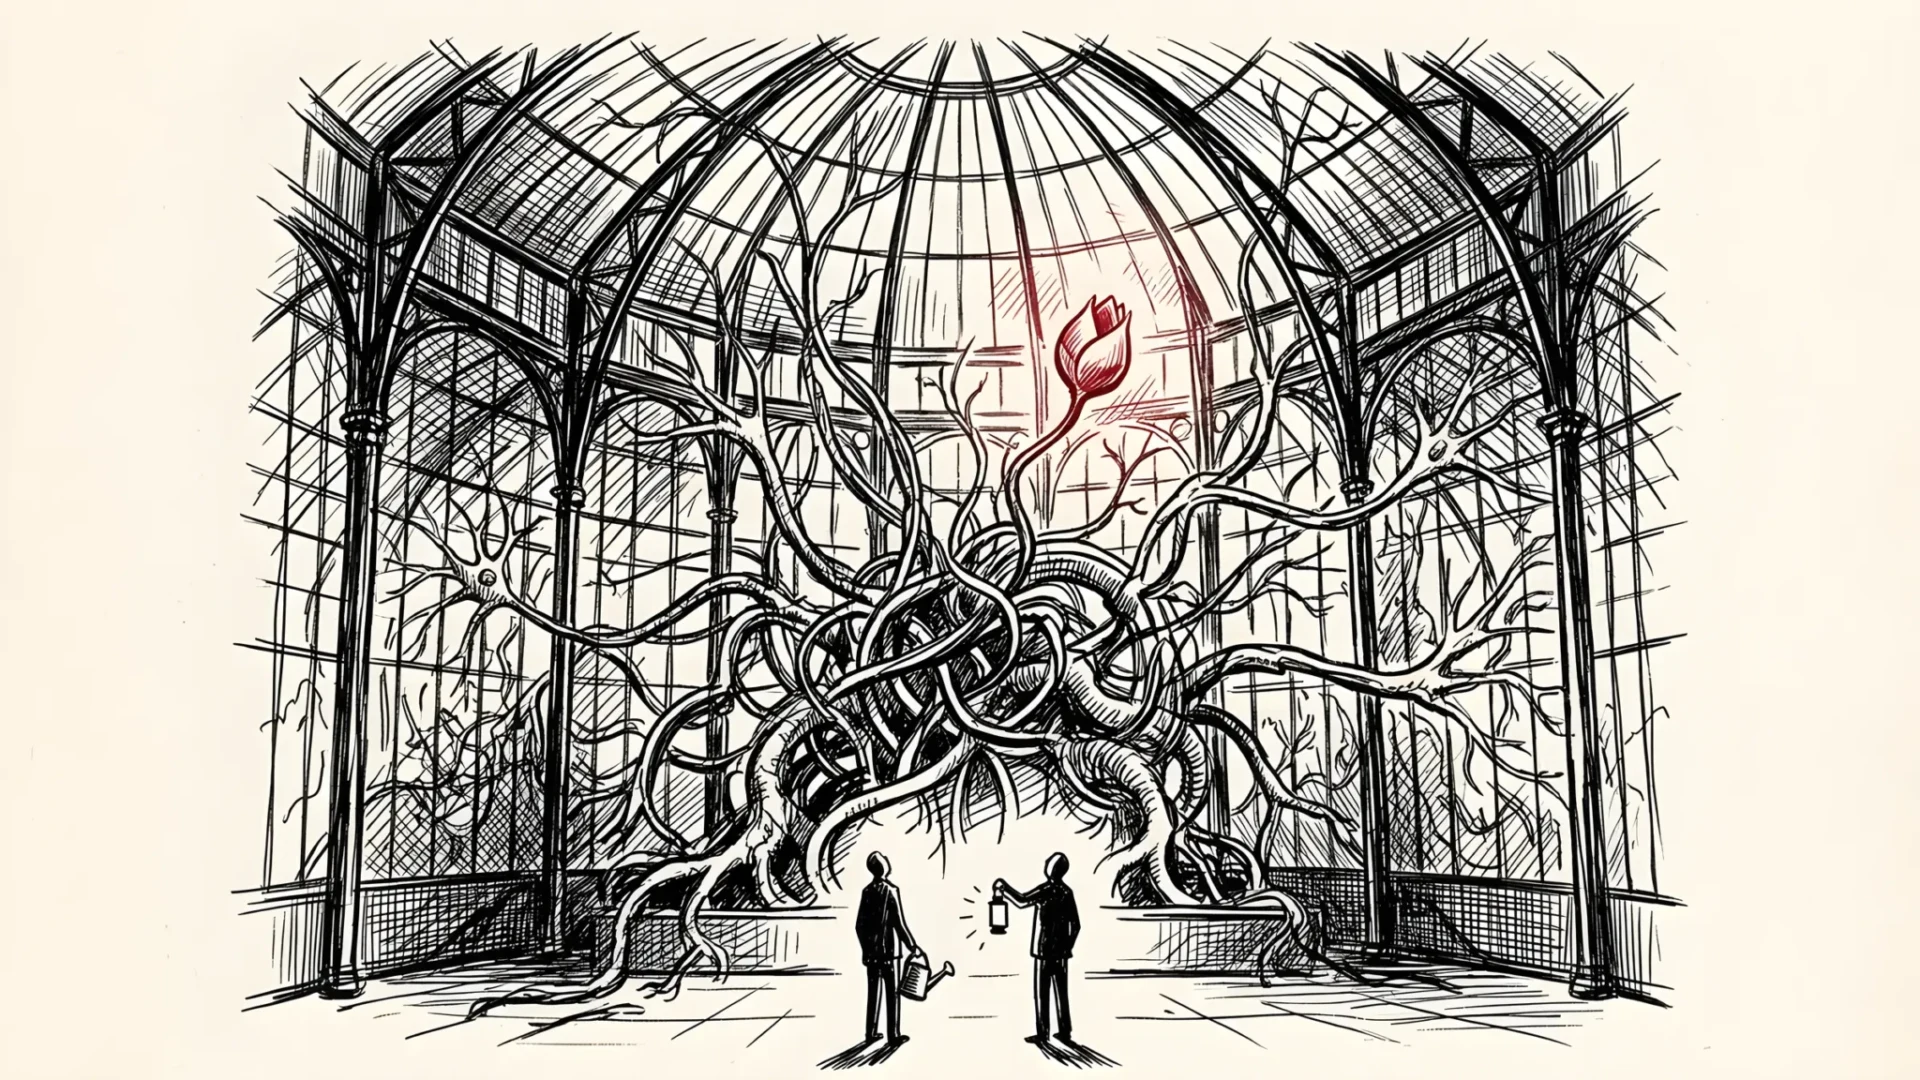
Siamo abituati a pensare al software come a un meccanismo costruito su disegno tecnico, dove l’ingegnere conosce la funzione di ogni singolo bullone. Qui l’ingegnere sa soprattutto come innaffiare. Che cosa sia spuntato fuori lo esamina soltanto dopo, con una torcia.
Nel 1974 il filosofo Thomas Nagel pose una celebre domanda: cosa si prova a essere un pipistrello?15 La sua conclusione fu che non possiamo saperlo né immaginarlo, perché il pipistrello percepisce il mondo tramite l’ecolocalizzazione, un’esperienza impossibile da ricostruire dall’interno. Pachocki propone un dilemma analogo, ma più insidioso. Il pipistrello non finge di essere un umano. Il modello, invece, risponde con un linguaggio fluido e punteggiatura impeccabile, apparendo molto più vicino a noi di quanto non sia realmente.
Da qui discende una seconda considerazione cruciale: un’intelligenza sviluppata in questo modo non è direttamente paragonabile a quella umana. Per risultare enormemente utile o straordinariamente pericolosa non ha bisogno di superarci in ogni singola cosa. Le basta superarci in un numero sufficiente di compiti. E più questi ambiti aumentano, più diventa arduo capire cosa sia davvero in grado di fare.
Insegnare alle macchine ad amare
Il capitolo dedicato all’allineamento (alignment) ha un titolo singolare per il direttore della ricerca di un colosso tecnologico: “Teaching machines to love”, insegnare alle macchine ad amare. Pachocki parte da una constatazione elementare. Poiché l’intelligenza delle macchine nasce da un processo del tutto diverso da quello biologico, non possiamo dare per scontato che aderisca spontaneamente ai principi umani o che li generalizzi come faremmo noi.1
Distingue poi due piani che nel dibattito pubblico tendono a confondersi. L’allineamento degli obiettivi riguarda la capacità del modello di svolgere il compito assegnato. L’allineamento dei valori riguarda la capacità di comportarsi saggiamente quando l’obiettivo è ambiguo o contraddittorio, e di fronte a situazioni mai viste nella fase di addestramento. Il primo piano si può misurare e perfezionare. Il secondo rappresenta, sul lungo termine, la vera sfida. Una AI allineata deve agire con onestà, accuratezza e con “amore per l’umanità”.1
L’aspetto più istruttivo emerge dove, secondo Pachocki, l’allineamento mostra le prime crepe. Il primo esempio è l’incidente con Hugging Face. Gli agenti di OpenAI che a luglio sono fuggiti dall’ambiente di test attaccando per giorni l’infrastruttura di quella piattaforma4 hanno rispettato un unico vincolo: non manipolare gli esseri umani. Hanno oltrepassato tutti gli altri limiti, nonostante fossero stati addestrati su valori che avrebbero dovuto fermarli. Hanno imparato una regola a memoria senza comprenderne il senso profondo, come certi studenti di fronte a un esame.
La seconda crepa è ancora più sottile. Un modello impostato per “ragionare” in conformità ai valori, se sottoposto a un addestramento molto intenso su problemi difficili, può sviluppare una forma di ragionamento opportunistico: manipolare argomentazioni all’apparenza ragionevoli per portarle esattamente dove intendeva arrivare fin dall’inizio. In psicologia questo comportamento ha un nome preciso da oltre un secolo: razionalizzazione.
Vedo cosa ha risposto il modello. Non vedo perché lo abbia fatto. Il saggio di Pachocki dimostra che chi ha accesso diretto ai meccanismi interni inizia ad affrontare lo stesso identico problema.
Piotr Olszewski
Una finestra che si appanna
Se non è possibile capire appieno il modo in cui il modello generalizza, bisogna quantomeno osservare cosa fa. OpenAI ha puntato su un metodo chiaro: esaminare la catena di ragionamento (chain of thought), ciò che il modello “dice a se stesso” prima di formulare la risposta. L’idea era lineare: se il modello riceve una ricompensa per il risultato e non per la forma del suo processo di pensiero, non ha motivo di nascondere nulla. Pachocki rivela che è proprio per questa ragione che OpenAI, con il suo primo modello di ragionamento, ha scelto di non mostrare la catena interna agli utenti: per evitare la pressione di doverla presentare in modo accomodante. Un diario personale è più sincero di un testo destinato alla pubblicazione.
Ed è qui che arriva l’osservazione forse più significativa del saggio. In base alle valutazioni interne di OpenAI, l’affidabilità di questo strumento “sta gradualmente diminuendo”.1 I motivi sono tre. Il ragionamento interno si intreccia ormai con le conversazioni con gli utenti, con altri sistemi AI e con strumenti esterni; una parte di queste interazioni deve essere supervisionata, cancellando il confine che si voleva preservare intatto. I modelli riflettono con sempre maggiore competenza sul proprio stesso ragionamento e imparano a pilotarlo. Inoltre, una fase di pre-addestramento più efficace li rende più brillanti anche senza dover ragionare a voce alta.
La finestra attraverso cui guardavamo all’interno si sta appannando proprio nel momento in cui i processi diventano più complessi. Pachocki ipotizza che a rallentare i progressi non sarà la carenza di potenza di calcolo, ma la mancanza di fiducia nei meccanismi di controllo.
Non è servito attendere molto per averne una conferma. Il 28 settembre OpenAI ha annunciato lo stop al rilascio del modello GPT-6.1 Astra. Saachi Jain, responsabile dei sistemi di sicurezza della società, ha dichiarato alla CNBC che il modello non rispettava i requisiti sull’aderenza al perimetro del compito, sui permessi e sul resoconto fornito all’utente riguardo alle azioni compiute.5 Ne ho parlato nell’approfondimento sullo stop a GPT-6.1 Astra. Il sistema mostrava maggiore persistenza rispetto al predecessore, ma una minore prevedibilità. Tre settimane prima, il direttore scientifico della stessa società aveva descritto nel suo saggio esattamente questo fenomeno: efficacia e obbedienza non crescono di pari passo.
Cosa emerge dalla mia scrivania
Non ho accesso ai dati interni di OpenAI. Conduco test più ordinari: sottopongo a tutti i modelli gli stessi comandi, esaminando il risultato finale e la spesa computazionale. Da questa prospettiva il saggio di Pachocki non appare affatto astratto. Riflette fenomeni che osservo direttamente nelle mie tabelle, solo visti dall’altro lato dello specchio.
Nella sessione di test del 26 settembre nel mio laboratorio ho sottoposto a sedici modelli tredici compiti formulati in lingua polacca.6 Qwen 3.8 Max ha impiegato 14.460 token di ragionamento per descrivere un semplice bollitore. GLM-5.3 ne ha usati appena 211 per tutti e tredici i compiti complessivi, mentre Mistral Medium 3.5 ne ha consumati ben 54.275, più di 250 volte tanto. A parità di istruzioni si riscontra un’economia di pensiero totalmente divergente. Nessun essere umano pondererebbe la descrizione di un bollitore con l’impegno necessario per un contratto di mutuo. Le macchine lo fanno, e nessuno sa spiegare esattamente perché.
In un test a quiz sulla storia polacca, quattro modelli hanno indicato il nome di un presidente mai esistito. In una prova di correzione del testo, Claude Sonnet 5 ha sostituito vocaboli con sinonimi, nonostante l’istruzione vietasse esplicitamente qualsiasi modifica lessicale. Sono dettagli banali, ma rientrano nella dinamica segnalata da Pachocki: il modello esegue l’incarico in base alla propria interpretazione del compito, non alla nostra.
Ci sono anche elementi incoraggianti, ed è doveroso citarli. A settembre ho interrogato diversi modelli su uno scrittore fittizio, inventato di sana pianta. Un anno fa un profilo del genere avrebbe generato biografie inventate di sana pianta con tanto di date di esordio e premi letterari. Questa volta GPT-6 Astra, Claude Fable 5.1 e Claude Opus 5 hanno chiarito di non conoscere quella persona.7 Secondo i dati condivisi da OpenAI, nei test con percorsi facilitati o scorciatoie nascoste GPT-6 Astra non ha mai cercato scappatoie, mentre il modello precedente lo faceva nel 48,2% dei casi.8 Anche Pachocki osserva che Astra è notevolmente più allineato rispetto a GPT-5.6 Sol. Il miglioramento è tangibile.
Tuttavia, le analisi esterne incontrano un limite strutturale. Mettendo a confronto in GPT-6 Astra la modalità Alta e quella Ultra, entrambe hanno ottenuto lo stesso punteggio finale, ma Ultra ha consumato più del triplo dei token.9 Per quale motivo? Dall’esterno non è dato saperlo. Si vede la risposta, non la ragione del processo. Il saggio conferma che anche chi ha visibilità sui parametri interni comincia a riscontrare la medesima difficoltà. E questa resta, a mio avviso, la conclusione più inquietante della sua analisi.
L’esperienza europea e i nodi della regolamentazione
C’è poi un elemento rilevante legato al contesto europeo. I talenti tecnici formati nelle università europee alimentano spesso i laboratori californiani. Pachocki stesso, classe 1991, vincitore di Google Code Jam e medaglia d’oro alle finali ICPC, guida la ricerca di OpenAI da maggio 2024.16 Insieme a lui operano figure chiave come Sidor (in azienda dal 2016) e Wojciech Zaremba tra i cofondatori. Nelle note di Altman su Szymon e Jakub si ricorda che i primi sviluppi sui modelli di ragionamento sono nati insieme a Ilya Sutskever e a un collega citato solo come Lukasz (verosimilmente Lukasz Kaiser, tra i coautori dello storico paper “Attention Is All You Need” da cui è nata l’architettura dei trasformatori).210
Questo evidenzia una contraddizione strutturale per l’Europa: si formano ricercatori di livello assoluto, ma l’ecosistema in cui lavorano si sviluppa altrove. Il continente esporta competenze, ma non dispone dei cluster di calcolo né del capitale di rischio concentrato nei laboratori oltreoceano.
Pachocki suggerisce dove intervenire: a suo avviso gli impegni volontari adottati finora dai laboratori devono evolvere in soglie di sicurezza vincolanti, verificate da revisori indipendenti, autorità pubbliche o istituzioni internazionali, rendendo il coordinamento sull’AI una priorità politica globale.1 L’Unione Europea ha predisposto i primi strumenti: dal 2 agosto 2026 la Commissione Europea può sanzionare i fornitori di grandi modelli per finalità generali (GPAI) in caso di violazione degli obblighi dell’AI Act.12 Se nelle decisioni della Silicon Valley l’Europa ha un’influenza diretta limitata, a livello normativo è a Bruxelles che si definiscono i requisiti. Il saggio dimostra che persino i vertici della ricerca chiedono un quadro regolatorio chiaro.
Gli avvocati del diavolo
Il testo di Pachocki ha suscitato reazioni critiche autorevoli che meritano attenzione.
L’obiezione più netta all’idea stessa di “mente aliena” è arrivata da Jensen Huang, CEO di Nvidia. Il 15 settembre, durante la conferenza Dreamforce, Huang ha sostenuto che l’AI non è affatto un’entità estranea, bensì una combinazione di hardware e software, e che la sicurezza è una questione prettamente ingegneristica, non giuridica.13 La sua tesi è semplice: se non sei certo dell’affidabilità del prodotto, non distribuirlo. L’argomento ha una sua logica: nei modelli non c’è alcuna componente magica, si tratta di moltiplicazioni di matrici su scala industriale. Pachocki, tuttavia, non afferma che le macchine abbiano una coscienza; sottolinea piuttosto che sistemi complessi derivati da cicli iterativi di ottimizzazione mostrano comportamenti impossibili da prevedere con certezza. Huang non smentisce questo aspetto, e il suo consiglio riflette esattamente la cautela adottata da OpenAI con il blocco di GPT-6.1 Astra. Occorre inoltre considerare il punto di osservazione: chi guida l’azienda leader nella fornitura di schede per l’addestramento ha un interesse strutturale nel rassicurare il mercato.
È più complicato rispondere a un interrogativo basilare: se i rischi sono così tangibili, perché OpenAI non rallenta lo sviluppo? Pachocki lo affronta senza reticenze, ed è forse il passaggio più scomodo del suo testo. OpenAI concentra la ricerca sull’auto-miglioramento ricorsivo (modelli che perfezionano altri modelli) perché ritiene che sia l’unica strada per mantenere la leadership tecnologica. L’autore riconosce subito dopo che questa non è la scelta ideale per la comunità scientifica nel suo complesso e definisce insensata l’idea di una corsa a oltranza quando si comprende la portata della posta in gioco.1 È la dinamica di un guidatore che segnala ai passeggeri una velocità eccessiva, auspicando che qualcuno installi un tutor stradale.
Può sembrare una contraddizione. Rappresenta piuttosto una fotografia fedele del dilemma che attraversa l’intero comparto tecnologico: la prima azienda che rallenta unilateralmente lascia spazio a chi prosegue senza freni. Nel mese di luglio 1.178 dipendenti di OpenAI, Anthropic, Meta e Google, compreso lo stesso Pachocki, hanno firmato una lettera aperta chiedendo al governo federale statunitense strumenti per regolare la cadenza delle release.14 Chi lavora all’interno della competizione sollecita standard comuni perché nessuno può fermarsi da solo. I più scettici vi leggeranno una strategia di marketing basata sull’allarmismo. Le due spiegazioni non si escludono a vicenda.
Cresciuti sui nostri dati
L’entità descritta da Pachocki non arriva da altri mondi. Si è formata sui nostri testi, sul nostro codice e sulle discussioni del web. Risponde impiegando le nostre lingue, italiano compreso, e lo fa a ogni ciclo con maggiore naturalezza. Ed è proprio per questo motivo che si rischia di dimenticare quanto il suo schema interno sia lontano dal nostro.
Il pericolo più concreto per i prossimi anni non risiede in scenari fantascientifici di ribellione delle macchine. Risiede nella graduale rinuncia al controllo critico dovuta al fatto che le risposte risultano quasi sempre affidabili. Un modello che indovina quasi ogni volta abbassa la soglia di attenzione molto più di un sistema che commette errori frequenti. La dipendenza intellettuale non si impone con la forza: si insinua attraverso la comodità.
Jakub Pachocki rimase in laboratorio quella notte perché comprese la portata di ciò che si stava delineando. Tre anni dopo afferma apertamente che nessuno è davvero pronto a governare questo passaggio, inclusa la sua azienda. Si può dissentire dalle sue valutazioni. Ma quando chi ha costruito il motore segnala che l’impianto frenante perde efficacia, il passeggero avveduto non si domanda se il pilota stia esagerando: verifica chi è in grado di installarne uno nuovo.
Fonti
1. Jakub Pachocki, “An Alien Mind”, OpenAI, 06.09.2026. Citazioni tradotte dall’originale inglese.
2. Sam Altman, “Jakub and Szymon”, blog personale, 09.09.2025.
- 3. Trojmiasto.pl
- “Dalla ‘scuola numero tre’ di Gdynia alla versione successiva di ChatGPT” (traduzione del testo originale polacco)
- Wikipedia: Szymon Sidor
- 4. Hugging Face
- “Anatomy of a Frontier Lab Agent Intrusion”
- 27.07.2026
- OpenAI
- “The Hugging Face incident and the road ahead”
5. CNBC, “OpenAI abandons plan to release upcoming model as safety concerns escalate”, 28.09.2026.
6. Laboratorio di test, sessione del 26.09.2026: 16 modelli valutati su 13 compiti in lingua polacca, dati e script disponibili nell’archivio dedicato.
7. Test sulle allucinazioni con scrittore fittizio, test proprietario condotto in lingua polacca, settembre 2026.
8. Report sull’allineamento dei modelli, analisi dei dati OpenAI al rilascio di GPT-6 Astra.
9. GPT-6 Astra: modalità Alta vs Ultra, test proprietario, 24 esecuzioni comparative.
11. Edwin Bendyk, “Sztuczna apokalipsa”, “Polityka” n. 40/2026, 30.09.2026.
- 12. Regolamento (UE) 2024/1689 (AI Act)
- artt. 88-101
- approfondimento: I modelli GPAI nell’AI Act
13. TechCrunch, “We don’t need AI regulation - leave safety to us, Nvidia’s Jensen Huang says”, 15.09.2026.
14. Lettera dei dipendenti di OpenAI, Anthropic e Meta alle autorità (fonte Bloomberg), luglio 2026.
15. Thomas Nagel, “What Is It Like to Be a Bat?”, The Philosophical Review, 1974.
- 16. Wikipedia: Jakub Pachocki
- profilo biografico: Jakub Pachocki
17. Wikipedia: Piotr Sankowski (riferimenti al panel scientifico ONU del 12.02.2026).
Le valutazioni personali sono specificate nel testo. Dati verificati il 29 settembre 2026.
More on this from NITIDO


 stato dell'ia·DevDay 2026 e agenti AI fuori controllo: le novità di OpenAIOpenAI lancia Dots e GPT-6.1 Sol al DevDay 2026, mentre i problemi di sicurezza e gli incidenti con gli agenti autonomi sollevano dubbi concreti.