Muse Wonder di Meta: prezzo, benchmark e test
Prezzi API e piani Muse Code, benchmark e test: Muse Wonder ha ottenuto 87 punti scrivendo in polacco. Ecco cosa mostrano i risultati.
👁 115 letture
Prezzi e condizioni verificati il 9.11.2026.
In breve: Muse Wonder è un modello di ragionamento di Meta Superintelligence Labs. Nell’API costa circa 3,567 € per milione di token in ingresso (4 USD) e 17,835 € per milione in uscita (20 USD; prezzi verificati il 9.11.2026). Nel mio test di scrittura in polacco ha ottenuto 87,0 punti, classificandosi secondo dietro a Claude Opus 5.5. L’accesso dalla Polonia è disponibile tramite OpenRouter o Meta Model API; la variante Full è inclusa solo nei piani Muse Code.
Muse Wonder nell’API costa circa 3,567 € per milione di token in ingresso (4 USD) e 17,835 € per milione in uscita (20 USD). Muse Wonder Full si ottiene in modo diverso: è incluso nei piani a pagamento Muse Code. Non considero il prezzo del Wonder standard come il prezzo API della variante Full.
| Piano | Prezzo mensile | Prezzo annuale | Cosa include | Limiti |
|---|---|---|---|---|
| Muse Code Everyday Usage | circa 4,46 € (5 USD) | Non confermato | Muse Spark, Muse Wonder e Muse Image | 10-50 prompt ogni 5 ore |
| Muse Code High Usage | circa 13,38 € (15 USD) | Non confermato | Muse Spark, Muse Wonder e Muse Image | 5 volte la quota Everyday |
| Muse Code Power Usage | circa 44,59 € (50 USD) | Non confermato | Muse Spark, Muse Wonder e Muse Image | 20 volte la quota Everyday; Wonder Full |
| Muse Code Maximum Usage | circa 178,35 € (200 USD) | Non confermato | Muse Spark, Muse Wonder e Muse Image | 80 volte la quota Everyday; Wonder Full |
Fonti per prezzi e condizioni: Muse Code - piani; verificati il 9.11.2026. Le conversioni in euro sono stime, non prezzi locali di acquisto. Tasso di riferimento BCE del 10.11.2026: 1 EUR = 1,1214 USD; fonte: BCE.
Un importo non confermato non significa che il prezzo sia zero. I prezzi in USD descrivono i mercati o i canali indicati e non sono prezzi locali convertiti. Il prezzo annuale indica un anno intero, salvo che sia specificato un equivalente mensile.
Prezzi API per milione di token
| Modello | Ingresso | Uscita | Lettura cache | Condizioni |
|---|---|---|---|---|
| Muse Wonder 1.0 | circa 3,567 € (4 USD) | circa 17,835 € (20 USD) | circa 0,1783 € (0,2 USD) | Standard, per 1 milione di token |
Fonti per prezzi e condizioni: Meta Model API - prezzi; verificati il 9.11.2026. Le conversioni sono stime, non prezzi locali di acquisto. Tasso di riferimento BCE del 10.11.2026: 1 EUR = 1,1214 USD; fonte: BCE.
Non ho trovato un listino separato in euro per questi token. Gli strumenti e le operazioni aggiuntive possono essere addebitati a parte. Un abbonamento all’app non equivale al prezzo di un milione di token API.
Che cosa è cambiato
9.11.2026: ho verificato i prezzi API di Wonder e i quattro piani Muse Code. Ho distinto l’assenza di un listino API pubblico confermato per Wonder Full dal prezzo del piano che lo include.
Fonti per prezzi e condizioni: Muse Code - piani, Meta Model API - prezzi; verificati il 9.11.2026.
API e modalità Contributor
Meta Model API non offre la modalità Contributor per Wonder. La lettura della cache costa circa 0,1783 € per milione di token (0,20 USD). La ricerca web_search aggiunge circa 2,23 € ogni 1.000 query (2,50 USD). Gli abbonamenti Muse Code hanno regole Contributor proprie: le verifico prima di condividere codice.
Fonti per prezzi e condizioni: Muse Code - piani, Meta Model API - prezzi; verificati il 9.11.2026.
Che cos’è Muse Wonder
È una famiglia di modelli di ragionamento di Meta Superintelligence Labs, il gruppo creato da zero nell’ambito della riorganizzazione della divisione AI di Meta nell’estate del 2025. La prima famiglia di modelli del gruppo è stata Muse Spark (aprile 2026, versione 1.3 a settembre). Mark Zuckerberg ha definito Wonder «una classe di modelli molto più grande e avanzata», pensata per portare Meta tra i leader del settore. I modelli sono stati addestrati nel centro dati Prometheus, con capacità di un gigawatt.
Meta mette in evidenza due caratteristiche:
- Active Memory: il modello dovrebbe ricordare informazioni importanti sull’utente tra una conversazione e l’altra e richiamarle autonomamente quando sono utili;
- Active Focus: di fronte a un compito difficile dovrebbe provare approcci alternativi e fare domande prima dei passaggi importanti, anziché fermarsi e aspettare l’intervento di una persona.
La scheda del modello indica input di testo, immagini, video e audio e output solo testuale. Non è disponibile un elenco delle lingue supportate e Meta avverte che il modello «non è stato valutato in tutte le lingue». Ho quindi verificato personalmente il polacco.
Il mio test in polacco: 87,0 punti e secondo posto
Di seguito riporto il test precedente e il relativo contesto. I costi indicati sono quelli storici di quella misurazione: non rappresentano l’offerta attuale né garantiscono il costo di un test futuro. Fonte: versione precedente di questo articolo, conservata prima dell’aggiornamento del 9.11.2026; la data del test è indicata nella descrizione. I prezzi aggiornati sono riportati sopra.
Muse Wonder ha affrontato gli stessi 13 compiti assegnati a oltre 20 modelli nella mia classifica delle AI per scrivere in polacco: 9 esercizi di scrittura, due correzioni e due quiz sulla Polonia. Le impostazioni erano uguali per tutti: OpenRouter, effort=low e gli stessi limiti di token. Due valutatori di aziende diverse, Claude Opus 5.5 e GPT-6 Sol, hanno giudicato i testi alla cieca. Nello stesso gruppo c’erano quattro modelli di riferimento del primo round. Hanno mantenuto l’ordine, ma la scala è slittata di 2,45 punti: ho corretto il risultato di conseguenza.
| Modello | Punteggio | Valutatori 1-10 | Naturalità | Regole |
|---|---|---|---|---|
| Claude Opus 5.5 | 90,1 | 8,70 | 8,00 | 25/26 |
| Muse Wonder | 87,0 | 8,15 | 7,22 | 26/26 |
| GPT-6 Sol | 86,4 | - | - | - |
| GPT-6 Astra | 85,3 | - | - | - |
| Claude Fable 5.1 | 83,9 | - | - | - |
| GPT-6 Luna | 82,8 | 7,63 | 6,67 | 24/26 |
| Muse Spark 1.3 | 75,3 | 6,78 | 5,63 | 25/26 |
I voti dei valutatori per Opus 5.5 e Luna provengono dallo stesso gruppo di Muse Wonder (12.10.2026); quelli per Muse Spark dal suo gruppo del 27.09. Wonder ha rispettato tutte le 26 regole dei prompt (limiti di parole, numero di punti, parole chiave), cosa che non hanno fatto né Opus né Luna. Ha ottenuto 29/30 nella correzione difficile e il punteggio pieno in entrambi i quiz sulla Polonia. Le 13 risposte sono costate circa 0,4013 € (0,45 USD; Opus 5.5 nello stesso test: circa 0,3299 €, 0,37 USD).
Ecco cosa emerge dai risultati:
- Riassunto e traduzione sono riusciti meglio. GPT-6 Sol, nel ruolo di valutatore, ha scritto che il riassunto «riporta in modo conciso tutti i fatti importanti» e che la traduzione della newsletter restituisce il tono dell’originale.
- La descrizione di prodotto è debole (5,33). In un paragrafo il modello ha ripetuto due volte gli stessi dati sul bollitore: regolazione della temperatura, mantenimento per 30 minuti e filtro. Entrambi i valutatori hanno segnalato le ripetizioni e l’elenco di caratteristiche al posto dei vantaggi.
- Piccoli inciampi:l’hashtag «testo corrotto nel test originale in polacco» nel post LinkedIn (errore di genere grammaticale), «ci scusiamo sentitamente» (traduzione dall’originale polacco) nell’email di scuse e l’assunzione che il cliente fosse un uomo.
Nello stesso test Muse Spark 1.3 aveva ottenuto 75,3 punti: la nuova famiglia scrive quindi nettamente meglio in polacco. Mostro alcuni estratti nell’articolo Muse Wonder in polacco e confronto i risultati con altri modelli nell’Arena dei modelli AI in polacco.
Confronto: 23 compiti, 5 modelli
Di seguito riporto il test precedente e il relativo contesto. I costi indicati sono quelli storici di quella misurazione: non rappresentano l’offerta attuale né garantiscono il costo di un test futuro. Fonte: versione precedente di questo articolo, conservata prima dell’aggiornamento del 9.11.2026; la data del test è indicata nella descrizione. I prezzi aggiornati sono riportati sopra.
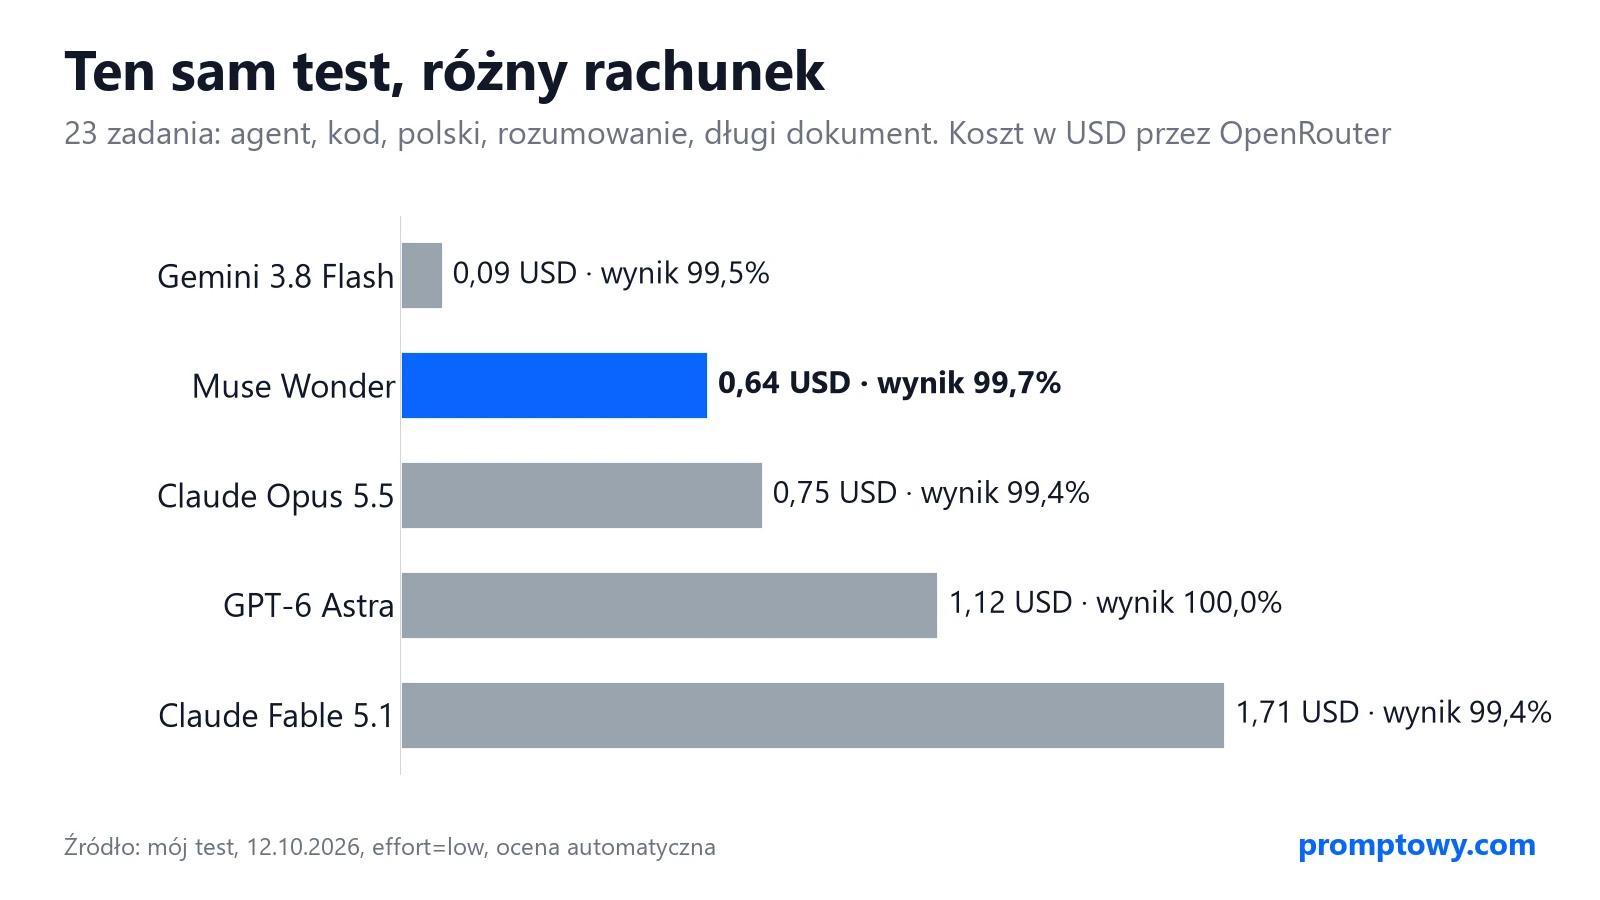
Muse Wonder, Opus 5.5, Fable 5.1, GPT-6 Astra e Gemini 3.8 Flash hanno ricevuto gli stessi 23 compiti con valutazione automatica: un agente con strumenti, codice verificato con test, documenti polacchi, ragionamento e un documento lungo. Tutti hanno ottenuto il 99-100%; le differenze sono emerse in costo e tempo:
- Muse Wonder:99,7%, circa 0,5707 € (0,64 USD), 165 s. Un errore: testo corrotto nel test originale in polacco nell’importo scritto in lettere.
- Claude Opus 5.5: 99,4%, circa 0,6688 € (0,75 USD), 222 s. Lo stesso prezzo per token, ma il tokenizer di Claude conteggia il testo polacco a un costo quasi doppio: 87.675 token contro 46.929 per Wonder sullo stesso documento.
- GPT-6 Astra: 100%, circa 0,9988 € (1,12 USD), 200 s.
- Claude Fable 5.1: 99,4%, circa 1,5240 € (1,71 USD), 263 s.
- Gemini 3.8 Flash: 99,5%, circa 0,0803 € (0,09 USD), 139 s; nel test sulle fonti scientifiche, però, solo 7 pubblicazioni su 16 erano vere. Muse Wonder ne aveva trovate 16 su 16.
Il giorno dopo Gemini 4 Argon ha completato lo stesso set: 99,5% per circa 0,1962 € (0,22 USD), cioè tre volte meno di Wonder. Tutti i risultati e gli errori sono nell’articolo Muse Wonder vs Opus 5.5 vs GPT-6 Astra: il mio test su 23 compiti.
Esame AI: 215 su 220
Di seguito riporto il test precedente e il relativo contesto. I costi indicati sono quelli storici di quella misurazione: non rappresentano l’offerta attuale né garantiscono il costo di un test futuro. Fonte: versione precedente di questo articolo, conservata prima dell’aggiornamento del 9.11.2026; la data del test è indicata nella descrizione. I prezzi aggiornati sono riportati sopra.
| Materia | Muse Wonder | Claude Opus 5.5 | GPT-6.1 Sol | Claude Haiku 5.5 |
|---|---|---|---|---|
| Matematica di base | 50/50 | 50/50 | 50/50 | 50/50 |
| Matematica avanzata | 49/50 | 50/50 | 50/50 | 50/50 |
| Polacco di base | 56/60 | 60/60 | 60/60 | 56/60 |
| Inglese di base | 60/60 | 60/60 | 60/60 | 59/60 |
| Totale | 215/220 | 220/220 | 220/220 | 215/220 |
| Costo | circa 1,3736 € (1,54 USD) | circa 1,0077 € (1,13 USD) | circa 0,2854 € (0,32 USD) | circa 0,0357 € (0,04 USD) |
Avrebbe superato l’esame senza difficoltà, ma non è il migliore e, tra i modelli confrontati, è stato il più costoso. Tutti e 4 i punti persi in polacco riguardano una nota di sintesi: invece di confrontare le posizioni di due autori, Wonder ha elencato vantaggi e svantaggi dei supporti. Secondo i criteri CKE vale 0 punti, come è successo ad altri 7 modelli. La tabella completa è nell’Esame AI.
I benchmark secondo Meta
Di seguito riporto il test precedente e il relativo contesto. I costi indicati sono quelli storici di quella misurazione: non rappresentano l’offerta attuale né garantiscono il costo di un test futuro. Fonte: versione precedente di questo articolo, conservata prima dell’aggiornamento del 9.11.2026; la data del test è indicata nella descrizione. I prezzi aggiornati sono riportati sopra.
Meta ha confrontato entrambi i modelli con Claude Fable 5.1, GPT-6 Astra e Claude Opus 5.5, tutti al livello max. Alcuni risultati provengono da aziende indipendenti (Artificial Analysis, Vals AI, Surge, Datacurve, Abundant AI), altri dai test interni di Meta.
| Test (secondo Meta) | Wonder Full | Wonder | Fable 5.1 | Astra | Opus 5.5 |
|---|---|---|---|---|---|
| Personal Superintelligence Index (interno) | 59,1 | 54,3 | 49,9 | 54,5 | 55,2 |
| Harvey LAB-AA (diritto) | 13,1 | 10,0 | 6,4 | 8,6 | 4,2 |
| Vals Finance Agent V2 | 59,1 | 56,6 | 58,9 | 53,5 | 58,6 |
| HealthBench Pro | 62,3 | 60,5 | 62,1 | 65,3 | 65,6 |
| AutomationBench-AA | 45,4 | 39,1 | 32,1 | 41,6 | 41,2 |
| GDP.pdf (documenti) | 33,2 | 30,8 | 27,6 | 34,2 | 30,6 |
| JobBench (compiti professionali) | 75,3 | 70,5 | 73,1 | 66,1 | 75,4 |
| OSWorld V2.1 (uso del computer) | 78,4 | 72,6 | 80,7 | 75,8 | 81,8 |
| MemoryBench (interno) | 85,5 | 85,6 | 79,0 | 81,4 | 81,5 |
| Terminal-Bench 4.0-AA | 57,1 | 52,0 | 52,0 | 59,1 | 59,6 |
| DeepSWE 1.1 | 79,0 | 78,8 | 67,4 | 74,1 | 74,2 |
| SWE-Marathon | 57,5* | 53,1 | 45,6 | 42,5 | 46,3 |
| ProgramBench (programma creato da zero) | 59,0 | 50,0 | 55,5 | 52,5 | 70,5 |
* Full al livello xhigh. Fonte: tabella del post di Meta del 12.10.2026.
Leggo la tabella tenendo presenti quattro riserve:
- Personal Superintelligence Index e MemoryBench sono test di Meta. Vincere un test progettato dal produttore dice meno che vincere un test indipendente.
- SWE-Marathon non mette i modelli a confronto in condizioni equivalenti. Meta stessa lo riconosce nella scheda: i risultati di Astra e Fable provengono da Codex e Claude Code, mentre Full è stato valutato a livello xhigh.
- In ProgramBench Opus 5.5 è avanti di 11,5 punti; in Terminal-Bench e HealthBench Pro Meta è dietro a Opus e Astra. L’annuncio non mette in evidenza questi risultati.
- Meta ha calcolato in parte i risultati dei concorrenti e precisa che prompt e strumenti «potrebbero non essere ottimizzati» per i modelli di altre aziende.
Spiego in modo semplice tutti e 14 i test nell’articolo I benchmark di Muse Wonder spiegati.
Risultati indipendenti: Artificial Analysis
Di seguito riporto il test precedente e il relativo contesto. I costi indicati sono quelli storici di quella misurazione: non rappresentano l’offerta attuale né garantiscono il costo di un test futuro. Fonte: versione precedente di questo articolo, conservata prima dell’aggiornamento del 9.11.2026; la data del test è indicata nella descrizione. I prezzi aggiornati sono riportati sopra.
Artificial Analysis esegue autonomamente una serie di test e li combina in un unico indice. Il giorno del lancio, con la versione 4.3, Wonder Full aveva 56 punti, Wonder standard 52 e Claude Opus 5.5 58. Oggi AA calcola l’indice con la versione 5.0, che usa una scala diversa: non si possono confrontare direttamente i vecchi e i nuovi punteggi.
| Modello | Indice AA v5.0 (29.10.2026) |
|---|---|
| Gemini 4 Carbon | 59 |
| Claude Opus 5.5 | 58 |
| Muse Wonder Full | 50 |
| Gemini 4 Argon | 50 |
| Muse Wonder | 43 |
Nel nuovo indice Wonder standard è solo 23° su 54 modelli classificati, mentre la mediana dei modelli comparabili è 40. Muse Wonder è anche prolisso: nel calcolo dell’indice versione 4.3 ha generato 130 milioni di token in uscita, contro una mediana di 88 milioni. Con un prezzo di 17,835 € per milione di token in uscita (20 USD), la differenza si vede sul conto.
Come usare Muse Wonder dalla Polonia
La via più semplice è OpenRouter. È il servizio che ho usato per i test:
- Crea un account su openrouter.ai e aggiungi credito con una carta. Per i modelli Meta OpenRouter potrebbe chiedere di confermare nelle impostazioni che hai almeno 18 anni; è successo con Muse Spark.
- Crea una chiave API nella scheda Keys.
- Nella chat OpenRouter scegli «Meta: Muse Wonder» oppure, nel codice, indica
meta/muse-wonder. - Puoi impostare il livello di ragionamento con il parametro
reasoning.effort. Da medium in su le risposte diventano più lunghe e costose.
import os, requests
r = requests.post("https://openrouter.ai/api/v1/chat/completions",
    headers={"Authorization": "Bearer " + os.environ["OPENROUTER_API_KEY"]},
    json={"model": "meta/muse-wonder",
          "reasoning": {"effort": "low"},
          "messages": [{"role": "user",
                        "content": "Scrivi una breve email di scuse per il ritardo nella consegna."}]})
print(r.json()["choices"][0]["message"]["content"])
La seconda possibilità è Meta Model API (dev.meta.ai), con l’identificativo muse-wonder-1.0. La politica geografica di Meta del 12 ottobre non esclude l’Europa, ma l’azienda non pubblica un elenco dei Paesi e decide caso per caso. Meta non ha annunciato un accordo sul trattamento dei dati con elaborazione nell’UE. La terza possibilità è Muse Code: solo lì è disponibile Wonder Full. Ho descritto la procedura passo passo, con uno script pronto, nell’articolo Come usare Muse Wonder in Polonia; per sapere quali altri prodotti Meta funzionano nel Paese, consulta Meta AI in Polonia.
Sicurezza
Nella scheda del modello Meta scrive che, senza misure di sicurezza, non si può escludere il superamento della soglia di rischio elevato nell’ambito delle armi chimiche e biologiche. Per questo ha aggiunto addestramento alla sicurezza e classificatori. Dopo le misure di protezione, valuta il rischio come «moderato o inferiore». Nel test Agentic Misalignment (che verifica se un agente danneggia qualcuno per evitare di essere spento), Full ha ottenuto 0%; nel test di onestà MASK ha raggiunto l’87,3%. Meta ha già affrontato casi controversi legati ai prodotti Muse: ho scritto di quando un agente Muse ha fornito l’indirizzo di casa di un utente e di quando l’assistente di Meta ha rivelato dati privati.
Il modello più piccolo: Muse Glimmer 30B
Muse Glimmer 30B è un modello open più piccolo di Meta, presentato ad agosto e descritto dall’azienda il 19 ottobre come modello agentico da eseguire sul dispositivo. In una rilevazione storica di OpenRouter costava circa 0,2675 € per milione di token in ingresso (0,30 USD) e 1,0700 € per milione in uscita (1,20 USD; rilevazione del 23.10.2026). Il 23 ottobre gli ho assegnato 10 compiti brevi in polacco, dal riassunto al codice verificato su 5 numeri PESEL. Li ha completati tutti e 10 per circa 0,0058 € (0,0065 USD), ma ha preceduto ogni risposta con il ragionamento: l’intero set ha richiesto 73 s. MiniMax M3.1 Flash ne ha completati 9 su 10 in 24 s; Nemotron 3.5 Bolt, eseguito localmente su RTX 4090, ne ha completati 8 su 10 in 4,6 s. È un metodo più breve e diverso dal test di Wonder, quindi i risultati non sono direttamente comparabili. Ho scritto del modello al lancio nell’articolo Zuckerberg pubblica un manifesto sull’AI e annuncia un nuovo modello open.
A chi è adatto Muse Wonder
- Sviluppatori e aziende che creano agenti: vale la pena confrontarlo con Opus 5.5, se i risultati di Meta sui compiti lunghi (DeepSWE, SWE-Marathon, AutomationBench) trovano conferma nell’uso pratico.
- Scrittura in polacco tramite API: sì. Ha ottenuto 87 punti nel mio test ed è costato meno di Fable 5.1 e Astra, con un risultato migliore.
- Utenti comuni in Polonia: per ora no. Non è disponibile in Meta AI su WhatsApp né nell’app Muse. Trovi i dettagli nell’articolo Muse Wonder su WhatsApp e Instagram? La situazione in Polonia.
- Se vuoi contenere ogni costo: probabilmente no. Claude Sonnet 5.5 e Gemini 4 Argon costano nell’API la metà di Wonder.
FAQ: prezzi e piani
Quanto costa Muse Wonder?
Con l’API Standard, circa 3,567 € per milione di token in ingresso (4 USD), 17,835 € per milione in uscita (20 USD) e 0,1783 € per la lettura della cache (0,20 USD). Le conversioni sono stime, non prezzi locali di acquisto. Tasso BCE del 10.11.2026: 1 EUR = 1,1214 USD; fonte: BCE.
Quanto costa accedere a Muse Wonder Full?
Muse Code include Full nel piano Power Usage, a circa 44,59 € al mese (50 USD), e nel piano Maximum Usage, a circa 178,35 € al mese (200 USD). Non ho trovato un prezzo API pubblico separato e confermato per Full. Le conversioni sono stime, non prezzi locali; tasso BCE del 10.11.2026: 1 EUR = 1,1214 USD, fonte: BCE.
Quali sono i piani Muse Code?
Everyday Usage costa circa 4,46 € al mese (5 USD), High Usage 13,38 € (15 USD), Power Usage 44,59 € (50 USD) e Maximum Usage 178,35 € (200 USD). Non ho verificato tariffe annuali o prezzi specifici per la Polonia. Le conversioni sono stime, non prezzi locali; tasso BCE del 10.11.2026: 1 EUR = 1,1214 USD, fonte: BCE.
Contributor è semplicemente uno sconto senza altre condizioni?
No. È legato alle regole sull’uso dei contenuti per migliorare i modelli. Le condizioni di Muse Code e Meta Model API vanno verificate separatamente; Contributor non è disponibile per Wonder nell’API.
Fonti per prezzi e condizioni: Muse Code - piani, Meta Model API - prezzi; verificati il 9.11.2026.
Fonti sui prezzi
- Muse Code - piani, verificati il 9.11.2026.
- Meta Model API - prezzi, verificati il 9.11.2026.
Fonti dei test e delle descrizioni precedenti
Meta
- Meta AI Research: Muse Wonder (12.10.2026)
- Scheda del modello Muse Wonder (PDF)
- Prezzi e limiti di Meta Model API (29.10.2026)
- Piani Muse Code (29.10.2026)
- Meta: Muse Glimmer 30B, pubblicazione del 19.10.2026
- Mark Zuckerberg su X: annuncio (12.10.2026)
Fonti indipendenti
- Artificial Analysis: Muse Wonder, indice v5.0 (29.10.2026)
- Artificial Analysis: Muse Wonder Full, indice v5.0 (29.10.2026)
- The Decoder: indice AA v5 per Gemini 4 (28.10.2026)
- OpenRouter: meta/muse-wonder
- Notebookcheck: l’app Muse non è disponibile in Europa
- CNBC: Muse Wonder e gli abbonamenti (12.10.2026)
Le mie misurazioni
- Test di 13 compiti in polacco tramite OpenRouter, 12.10.2026 (metodologia: Laboratorio dei prompt)
- Confronto su 23 compiti ed Esame AI, 12.10.2026
- Muse Glimmer 30B: 10 compiti in polacco tramite OpenRouter, 23.10.2026
Verificato: 29.10.2026.
More on this from NITIDO