Qwen-Image-2.1 contro i modelli chiusi: 4 test su RTX 4090
Qwen-Image-2.1 testato in locale su RTX 4090 contro Ideogram 4.5 e FLUX 3: resa del testo, layout con bounding box, dettaglio e 10 modifiche consecutive.
👁 112 letture
Qwen-Image-2.1 è oggi il modello open-weights più quotato nella classifica di Artificial Analysis, quindi l’ho sottoposto alle stesse quattro prove a cui avevo sottoposto Ideogram 4.5 e FLUX 3. Ha girato in locale sulla mia RTX 4090, mentre i concorrenti sono stati interrogati via API. Il responso è duplice: una singola immagine ha una resa estetica eccellente e richiede solo 6-20 secondi a costo quasi zero. Tuttavia, con il testo complesso, con il rispetto dei layout geometrici vincolati e nelle modifiche consecutive, i modelli proprietari chiusi rimangono nettamente superiori.
La classifica di Artificial Analysis si basa sulle preferenze umane espresse scegliendo l’immagine visivamente più gradevole tra due opzioni. È un ottimo indicatore estetico, ma non dimostra se un modello sia in grado di scrivere parole complesse senza errori, posizionare una tazza esattamente in un angolo o reggere la decima modifica a catena. Per questo eseguo verifiche separate con gli stessi script e le medesime istruzioni impiegate per la concorrenza.
Come ho svolto i test
- Hardware: RTX 4090 (24 GB), ComfyUI, Qwen-Image-2.1 in quantizzazione int8 (16,6 GB di file), 25 passaggi, sampler euler, cfg 1,0 - parametri derivati dal template ufficiale.
- Concorrenti: le medesime istruzioni inviate via API fal.ai, come documentato nelle prove su Ideogram 4.5 e FLUX 3 del 1 ottobre 2026.
- Un solo tentativo per ciascun prompt, seed fisso, senza cherry-picking dei risultati.
- Data di rilevazione: 2 ottobre 2026.
Riepilogo dei risultati
| Test | Qwen-Image-2.1 (in locale) | Miglior risultato del confronto |
|---|---|---|
| Scritte con caratteri speciali (13 da riprodurre, test in polacco) | 6/13 | 13/13 - GPT Image 2.5, Nano Banana Pro, Nano Banana 2, Grok |
| Oggetti in posizioni vincolate (16) | 2/16, IoU 0,17 | 16/16, IoU 0,89 - FLUX 3 con coordinate JSON |
| Dettaglio su inquadratura ampia | 2752 × 1536, effettivi 3,1 Mpx | 16,8 Mpx - FLUX 3 in 4K |
| Insegne minuscole leggibili (8) | 2/8 | 8/8 - GPT Image 2.5, Grok, Seedream |
| 10 modifiche consecutive (SSIM dopo il 10° passaggio) | 0,11 | 0,95 - Ideogram 4.5 |
| Tempo per un’immagine 1024 × 1024 | circa 6 s | concorrenti via API: 20-60 s |
| Costo per immagine | energia elettrica, frazione di centesimo | circa 0,021-0,20 EUR (0,024-0,22 USD) via API (conversione basata sul tasso BCE del 12/10/2026 da ecb.europa.eu) |
Test 1: scritte complesse con caratteri speciali
Il test è stato condotto in polacco su quattro contesti distinti: un poster di saldi stagionali, il menu di una tavola calda, la copertina del volume letterario (traduzione dal titolo originale polacco: “Filo d’erba e bile”) e la confezione di ravioli tipici. In totale 13 scritte da trascrivere lettera per lettera. Ho verificato manualmente ogni singola lettura ottica sui file generati, correggendo nel menu un falso positivo (traduzione dall’originale polacco: “MENU DEL GIORNO” è risultato privo di sbavature).
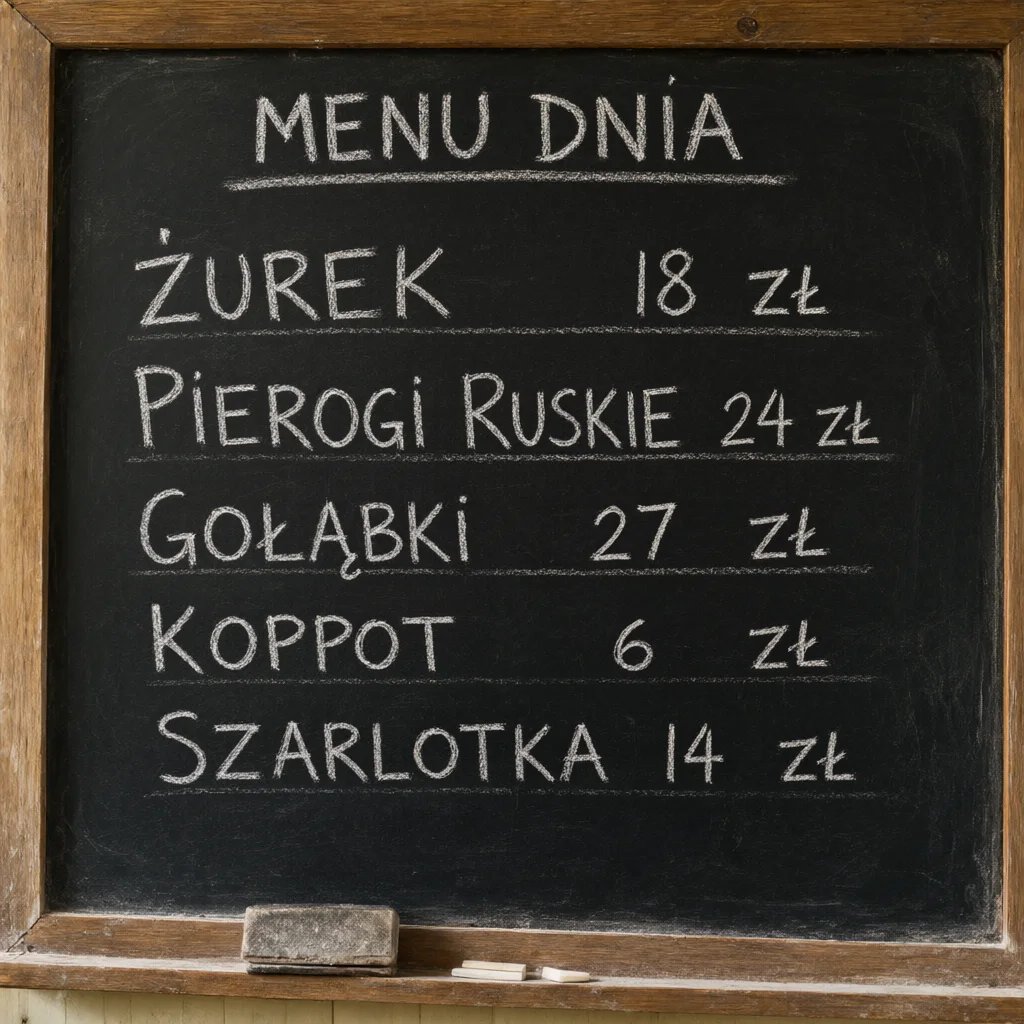
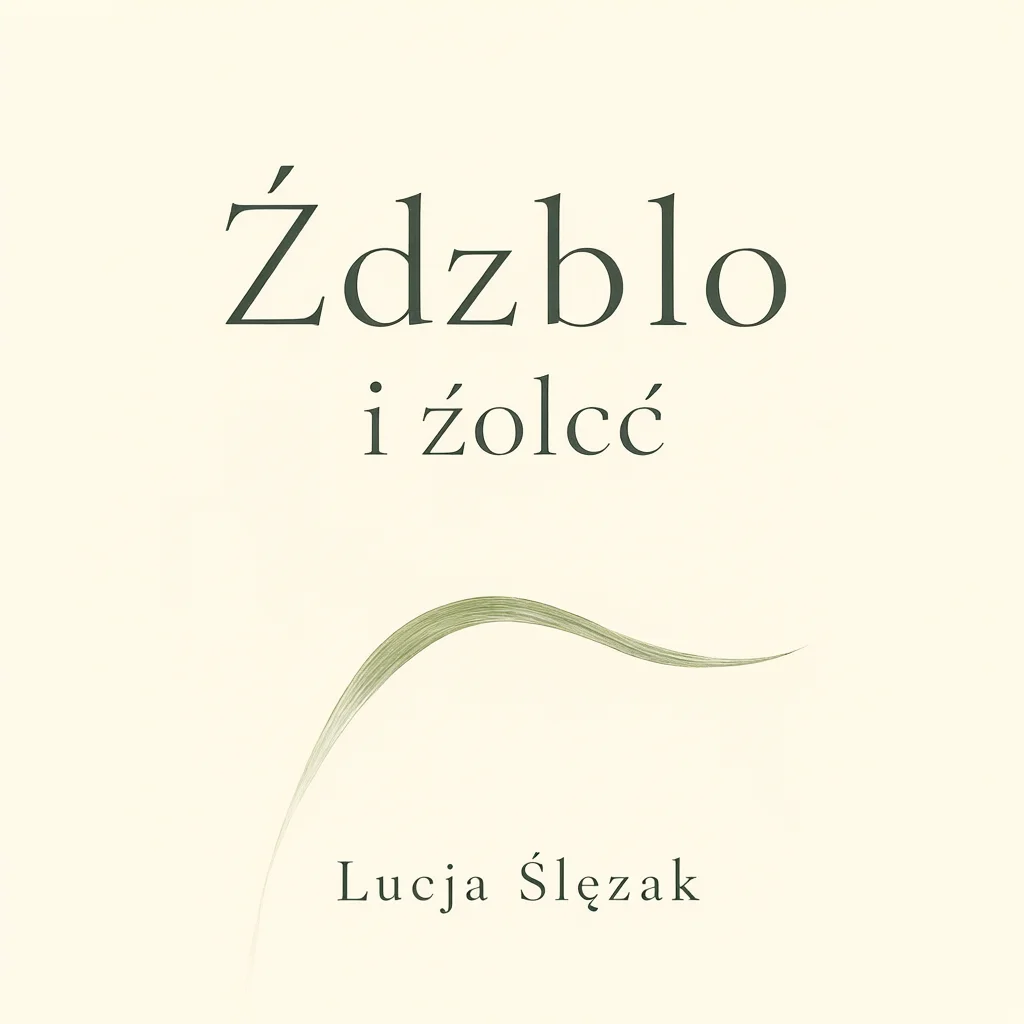
I termini in evidenza e a caratteri cubitali con segni diacritici isolati vengono riprodotti adeguatamente. I difetti emergono quando si affrontano combinazioni insolite o font minuscoli: sulla scatola compaiono refusi e sulla locandina la parola stagionale degenera in una serie incomprensibile. Per grafiche che richiedono un testo impeccabile senza ritocchi manuali, il modello non offre sufficiente affidabilità.
Test 2: oggetti in posizioni vincolate
Quattro scenari composti da quattro elementi ciascuno, con coordinate spaziali indicate con esattezza in percentuale rispetto ad altezza e larghezza del quadro. Qwen-Image-2.1 non dispone di un parser nativo per bounding box geometriche, quindi ha ricevuto le specifiche espresse in linguaggio naturale, esattamente come Nano Banana Pro, GPT Image 2.5 e Seedream. Un modello di visione ha successivamente individuato la posizione effettiva degli oggetti e ho calcolato l’intersezione sull’unione (IoU) rispetto alle coordinate richieste.
| Modello | IoU medio | Elementi posizionati correttamente |
|---|---|---|
| FLUX 3 Image (coordinate JSON) | 0,89 | 16/16 |
| Seedream 5.0 Pro | 0,79 | 15/16 |
| GPT Image 2.5 Sunburst | 0,54 | 11/16 |
| Nano Banana Pro | 0,48 | 7/16 |
| Ideogram 4.5 | 0,37 | 7/16 |
| Qwen Image 3 (API) | 0,35 | 6/16 |
| Qwen-Image-2.1 (in locale) | 0,17 | 2/16 |
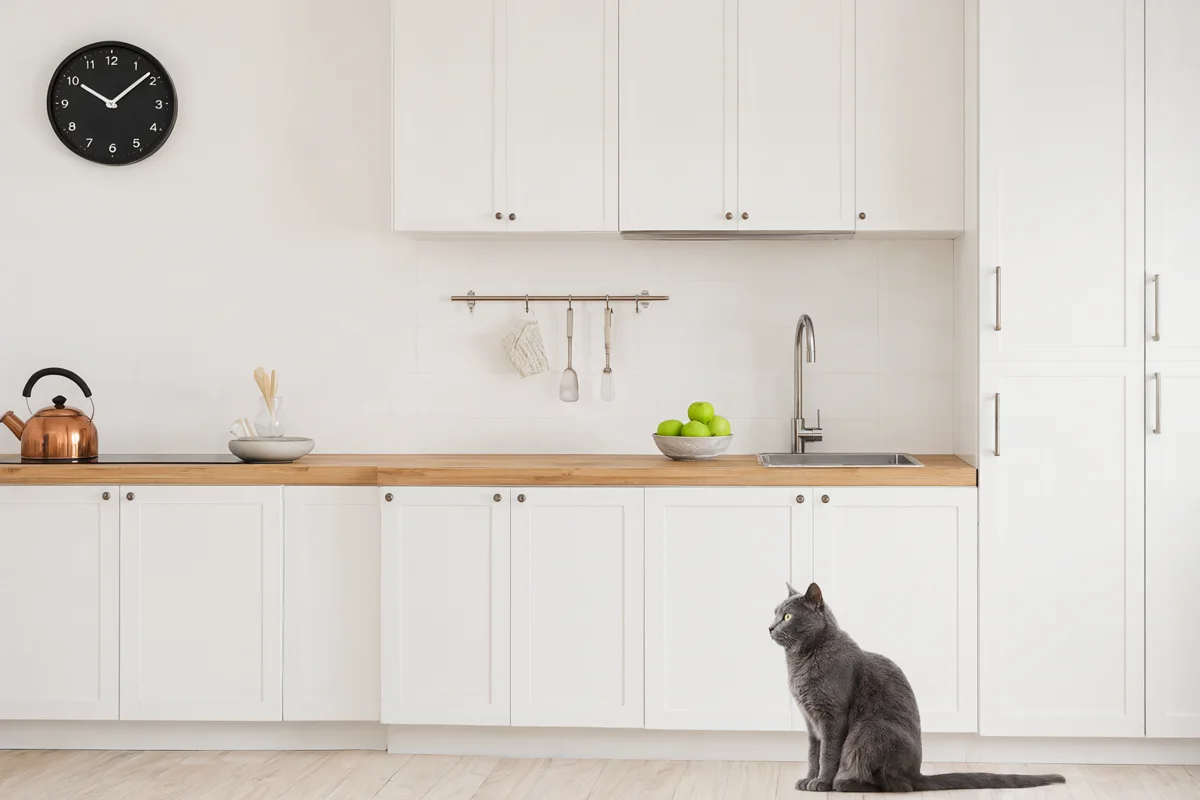
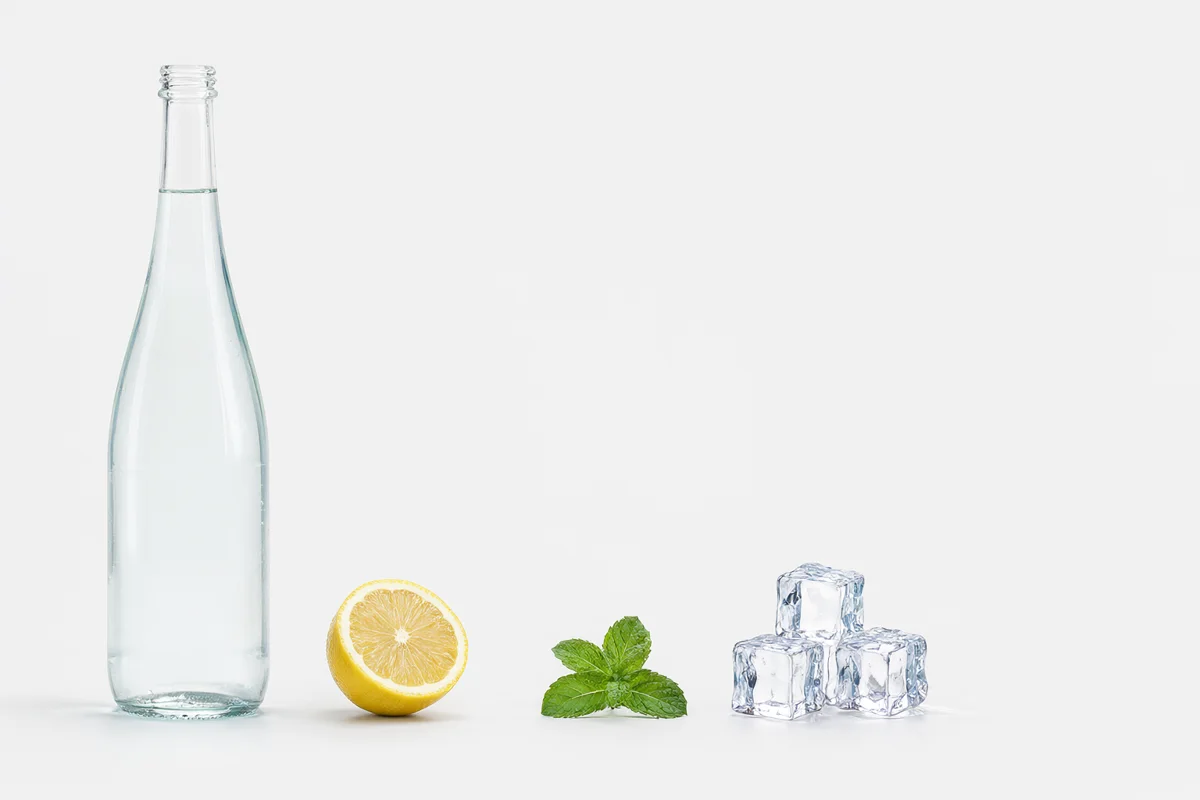
Le immagini risultano armoniose e contengono tutti i soggetti richiesti. Il motore tende tuttavia a comporre la scena secondo logiche proprie, interpretando i vincoli percentuali come semplici consigli di massima. Se un progetto impone spazi liberi precisi per un logo o per del copy promozionale, è preferibile orientarsi su FLUX 3 tramite bounding box o su Seedream.
Test 3: resa del dettaglio su inquadratura ampia
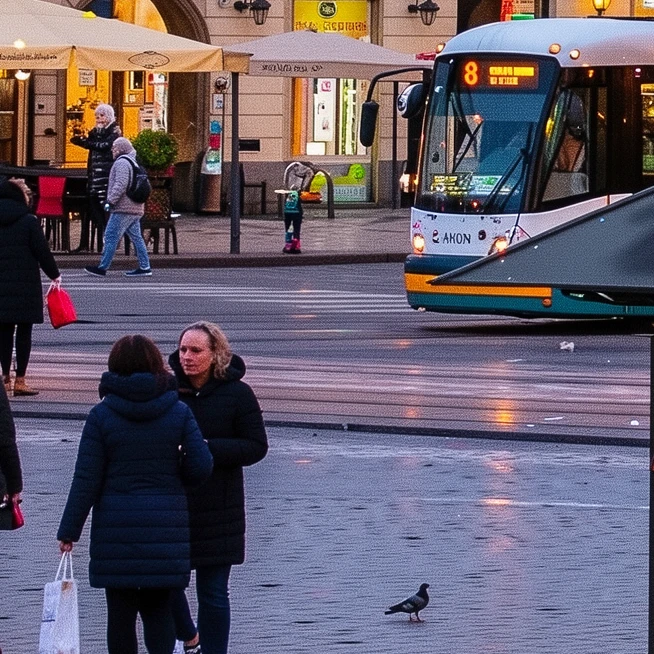
È stata riprodotta la piazza centrale di Cracovia con sei insegne, un’edicola e un tram. Qwen-Image-2.1 ha generato l’inquadratura alla risoluzione 16:9 massima supportata, pari a 2752 × 1536 pixel, impiegando 49 secondi. Il livello di dettaglio reale riscontrato è pari a circa 3,1 Mpx effettivi, un valore in linea con Grok Imagine 2 (3,3 Mpx). Delle 8 scritte presenti solo 2 sono risultate decifrabili (la parola “KWIATY” e il titolo principale esposto nel chiosco). Le scritte secondarie sono collassate in agglomerati sfocati.
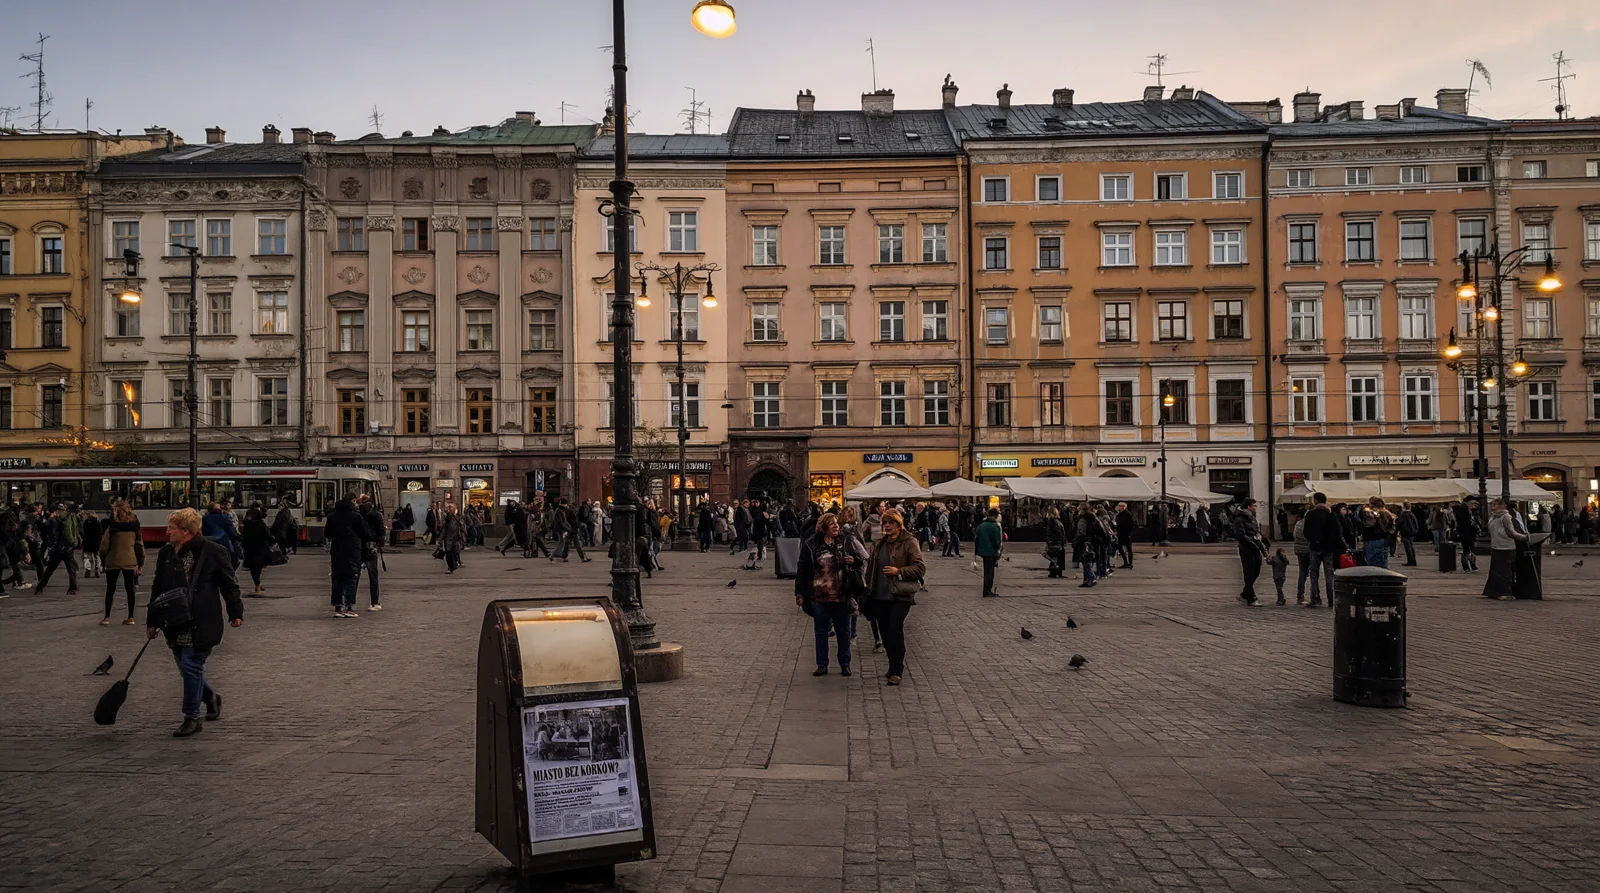
Test 4: 10 modifiche consecutive a catena
Partendo dallo scatto di una panetteria, ho applicato 10 interventi in sequenza: colorazione del portone, inserimento di un adesivo, sostituzione di una bicicletta con un monopattino, rimozione di un veicolo, rifacimento dell’insegna, aggiunta di lavanda, cambio d’abito, introduzione di un gatto, indicazione del prezzo ed eliminazione di un cestino. Ogni passaggio ha preso come input il frame del passaggio precedente. Ho quantificato la conservazione delle aree che dovevano restare inalterate tramite l’indice SSIM (1 = perfetta corrispondenza).
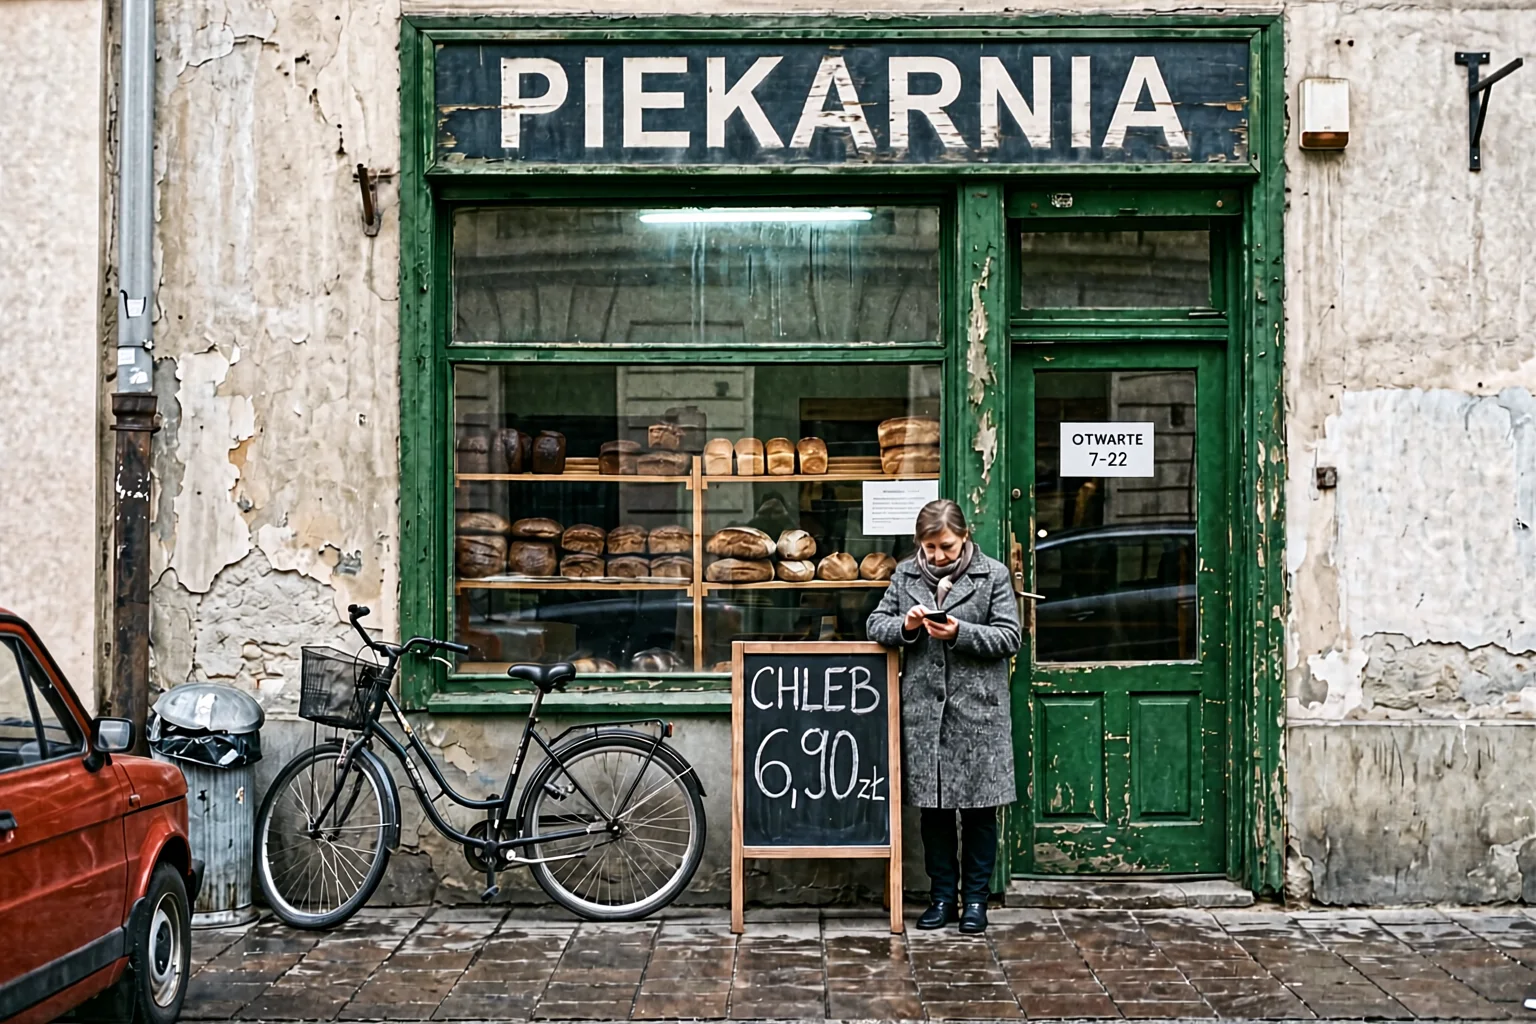
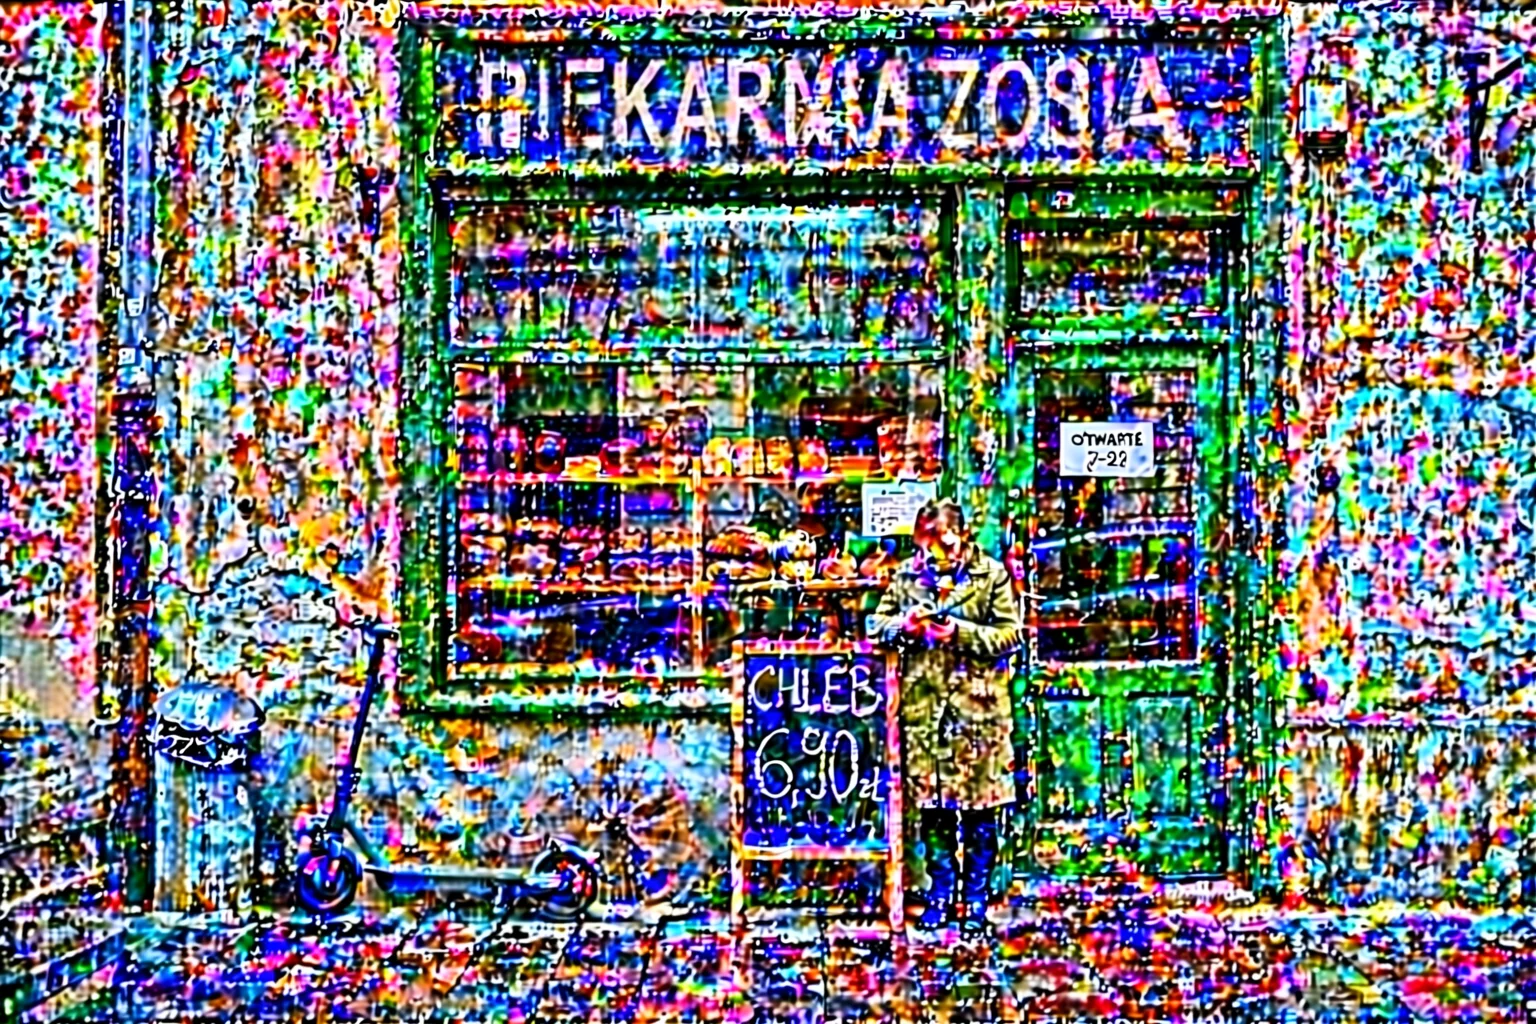
L’esecuzione delle singole modifiche in sé è corretta: la porta è diventata verde, la bici è stata sostituita, l’auto è scomparsa e l’insegna ha ricevuto il testo richiesto. Il problema è che ogni rigenerazione accumula grana e ipersatura i colori. Dal terzo step i difetti sono evidenti e dopo il sesto l’immagine è degradata. Una modifica singola funziona molto bene, il che collima con la diciottesima posizione ottenuta dal modello nel benchmark di editing di Artificial Analysis; quel benchmark misura però un solo passaggio, non una sequenza reiterata.
Va precisato che la prova è stata eseguita con la versione quantizzata int8 su ComfyUI. Nella configurazione iniziale con immagine di riferimento a 1024 px e canvas di output a 2048 px il degrado è stato ancora più rapido (SSIM 0,08). Uniformando le due risoluzioni la tenuta è migliorata, ma l’accumulo di artefatti è rimasto evidente. Una quantizzazione in bf16 integrale o un diverso campionatore potrebbero offrire un comportamento più pulito, ma la versione bf16 supera la memoria di 24 GB se caricata assieme al text encoder.
Indicazione operativa: se devi applicare svariate modifiche a un’immagine, intervieni sempre sul file originale includendo tutte le variazioni all’interno di un unico prompt, anziché operare modifiche a cascata.
Conclusioni pratiche
- Per immagini ad alto impatto senza scritte complesse: Qwen-Image-2.1 è formidabile, con tempi di 6 secondi per fotogrammi 1K, nessun costo di chiamata API e ottimi voti nelle votazioni cieche.
- Per elaborati con testi intricati o segni diacritici: meglio affidarsi a GPT Image 2.5 o Nano Banana Pro.
- Per progetti vincolati a layout millimetrici: la soluzione migliore resta FLUX 3 tramite le coordinate JSON.
- Per flussi di lavoro con editing seriale: Ideogram 4.5 o FLUX 3 garantiscono una preservazione nettamente superiore dei dettagli immutati.
- Attenzione ai termini di licenza: la licenza Qwen Research autorizza esclusivamente scopi di ricerca e valutazione. L’impiego per finalità commerciali richiede un accordo dedicato con Alibaba; trovi i dettagli nell’articolo sulla licenza d’uso.
Per una panoramica completa sui modelli open source consulta la nostra classifica dei modelli aperti per immagini, mentre per il piazzamento ufficiale del modello rimandiamo all’approfondimento su Qwen-Image-2.1 su Artificial Analysis.
Leggi anche: Qwen-Image-2.1: test su dieci immagini diverse.
Google · Le tue fontiPiù in alto su Google con un solo clicAggiungi alle fonti preferite →Domande frequenti
Qwen-Image-2.1 è superiore a Nano Banana Pro?
Nelle valutazioni alla cieca di Artificial Analysis no: Nano Banana Pro registra 1101 punti contro i 1034 di Qwen-Image-2.1. Nei nostri test Nano Banana Pro si è imposto in modo netto nella precisione del testo (13 a 6) e nel posizionamento degli elementi. Qwen risulta vantaggioso per l’assenza di costi di servizio e la possibilità di girare offline.
Quanto impiega a produrre un’immagine su una RTX 4090?
Nelle nostre misurazioni sono necessari circa 6 secondi a 1024 × 1024, 10 secondi a 1536 × 1024, 44 secondi a 2048 × 2048 e 49 secondi a 2752 × 1536. Una singola modifica a 1536 × 1024 ha richiesto indicativamente 20 secondi. La prima inferenza subito dopo il caricamento in memoria richiede più tempo.
Perché le modifiche seriali degradano l’immagine?
Ogni iterazione applica una ricodifica e una decodifica dell’intero fotogramma attraverso il VAE, causando un accumulo progressivo di distorsioni. Strumenti come Ideogram 4.5 e FLUX 3 dispongono di logiche mirate a ripristinare i pixel originali delle aree non toccate, una funzionalità non presente nel workflow standard di Qwen-Image-2.1 su ComfyUI.
Posso impiegare Qwen-Image-2.1 all’interno della mia azienda?
Non senza stipulare una licenza commerciale con Alibaba. I vincoli della Qwen Research License circoscrivono l’uso ai contesti di ricerca e benchmarking.
- Artificial Analysis - Classifica Text-to-Image
- Artificial Analysis - Classifica Image Editing
- Hugging Face - Repository Qwen-Image-2.1
- Test condotti dall’autore l’1 e 2 ottobre 2026: script, benchmark visivi e rilevazioni (OCR, IoU, SSIM, risoluzione effettiva)
More on this from NITIDO