Wan 3.0: test e recensione del modello video AI di Alibaba
Wan 3.0 di Alibaba genera fino a 30 secondi di video con audio e vince i benchmark. Abbiamo messo alla prova testo, fisica e video da PDF.
👁 116 letture
Wan 3.0 di Alibaba è in cima alla classifica video di Artificial Analysis: 1335 punti Elo nella categoria text-to-video, davanti a Gemini Omni Flash e MiniMax H3. Genera fino a 30 secondi di video in un unico passaggio, con audio sincronizzato, ed è in grado di creare un filmato partendo da un documento. Abbiamo speso 7,10 dollari per metterlo alla prova: cinque clip, tra cui dialoghi doppiati, scritte al neon complesse, un piano sequenza da 30 secondi e un video ricavato da un file PDF. Ecco tutto quello che ha funzionato - e cosa invece è andato storto.
Gli importi in EUR sono conversioni indicative dei prezzi pubblicati in USD, calcolate al cambio di riferimento BCE del 2026-10-12: 1 EUR = 1.1181 USD. Non sono prezzi locali confermati né importi finali comprensivi di imposte. Il fornitore e la banca possono applicare altri cambi o commissioni. ECB.
Il verdetto in sintesi
Wan 3.0 sa parlare e sa scrivere con precisione. Nel nostro test abbiamo provato una lingua complessa e ricca di accenti come il polacco: la battuta „Nie wyjadę bez ciebie. Słyszysz? Nie wyjadę.” (“Non me ne andrò senza di te. Mi senti? Non me ne andrò.”) è stata pronunciata parola per parola, e l’insegna al neon „ŻÓŁTA GĘŚ” (“Oca gialla”) ha mantenuto tutti i caratteri speciali. L’inquadratura continua di 30 secondi senza stacchi ha preservato la coerenza del personaggio e la sequenza delle azioni dall’inizio alla fine. I punti deboli: il testo di piccole dimensioni si corrompe, la generazione richiede tra i 3 e i 14 minuti, il filtro di sicurezza ha bloccato inspiegabilmente una scena innocua al mercato e la funzione “video da URL web” è fallita in entrambi i tentativi. Il video generato da file PDF, invece, ha funzionato molto bene.
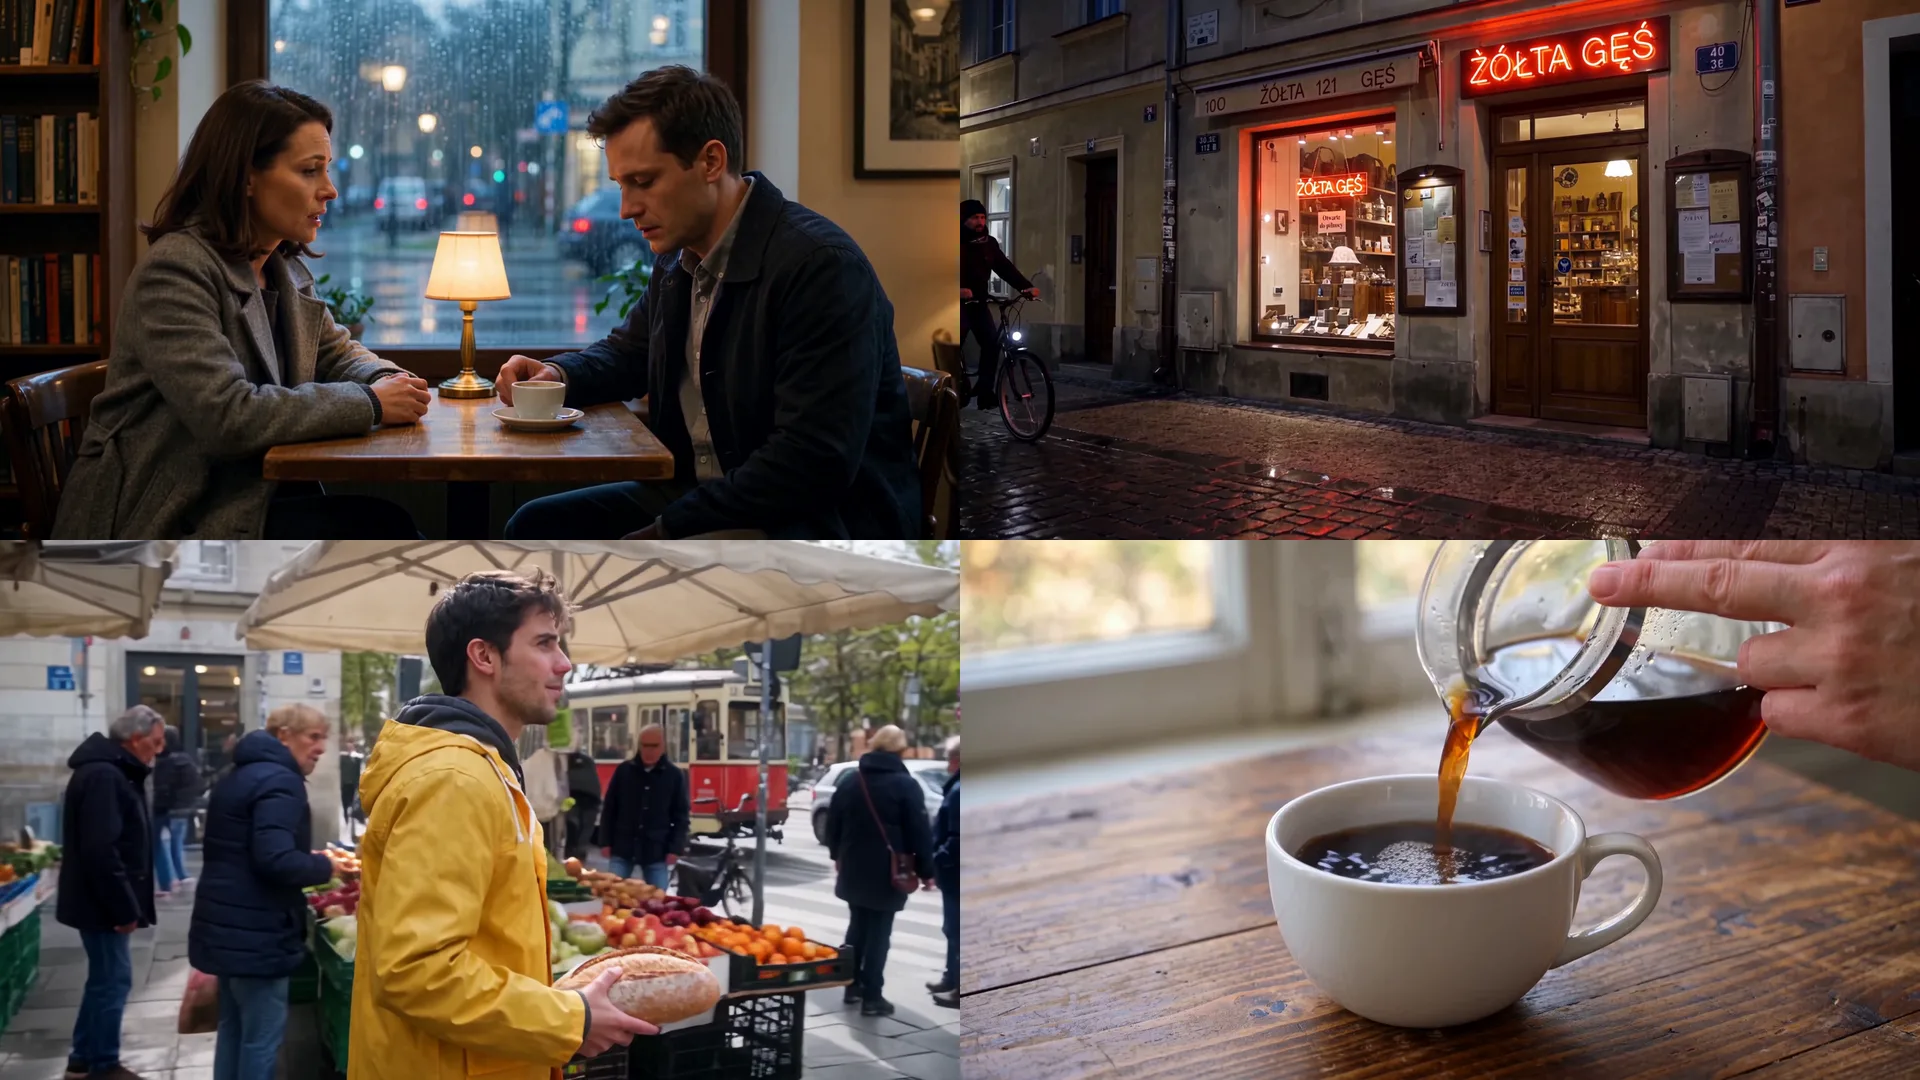
Quattro fotogrammi dai nostri test di Wan 3.0: dialogo, neon, sequenza da 30 secondi e versamento del caffè. 720p, senza ritocchi.
Le specifiche tecniche di Wan 3.0
| Parametro | Wan 3.0 |
|---|---|
| Produttore | Alibaba (Alibaba Cloud) |
| Data di annuncio | 13 agosto 2026 |
| Durata massima | 30 secondi in un solo passaggio |
| Risoluzione | 480p, 720p, 1080p |
| Input supportati | testo, immagini, audio, video e documenti: PDF, DOC, XLS, PPT, TXT, MD, Keynote, Pages, Numbers - 1 file fino a 100 MB e 50 pagine |
| Audio | generato contestualmente al video |
| Prezzo su Alibaba Cloud Model Studio | 0,05 / 0,10 / 0,1789 EUR (0,20 USD) al secondo (480p / 720p / 1080p) |
| 30 secondi in 1080p | 5,37 EUR (6 USD) |
| Pesi aperti (open weights) | No - disponibile solo tramite API |
| Classifica Artificial Analysis (Text-to-Video) | 1° posto, 1335 Elo |
La stessa tariffa è attiva su fal.ai, la piattaforma che abbiamo utilizzato per eseguire i benchmark. È disponibile anche la variante Wan 3.0 Prime, più veloce, al costo di 0,1252 EUR (0,14 USD) al secondo a 720p.
Benchmark: primo posto per un soffio
| Posizione | Modello | Sviluppatore | Punteggio Elo |
|---|---|---|---|
| 1 | Wan 3.0 | Alibaba | 1335 |
| 2 | Gemini Omni Flash | 1332 | |
| 3 | MiniMax H3 | MiniMax | 1302 |
| 4 | HappyHorse-1.0 | Alibaba (ATH) | 1286 |
Tre punti di distacco rispetto a Gemini Omni Flash rappresentano praticamente un pareggio in una classifica basata sulle valutazioni umane alla cieca. Curiosità: anche il quarto classificato, HappyHorse, appartiene ad Alibaba ma fa capo a un’altra divisione interna (ATH). Ci sono quindi due team distinti dello stesso colosso tecnologico nella top 4 globale.
Test 1: parlato e sincronizzazione labiale
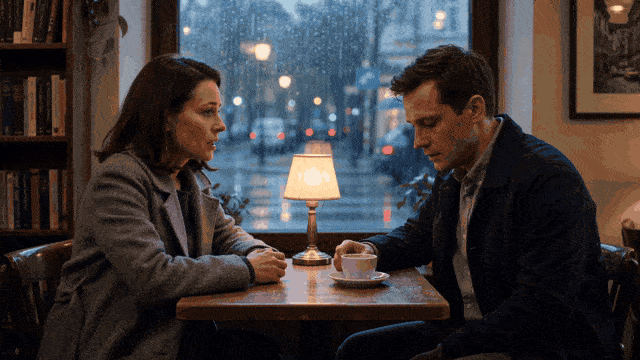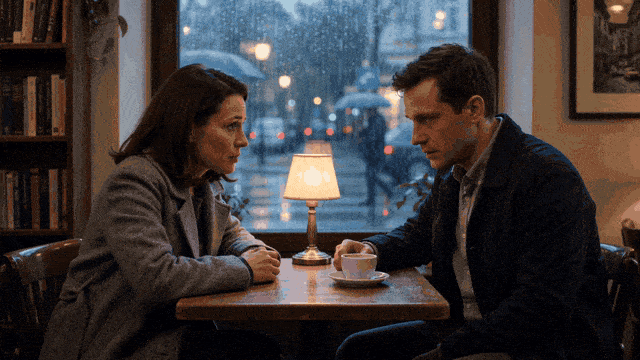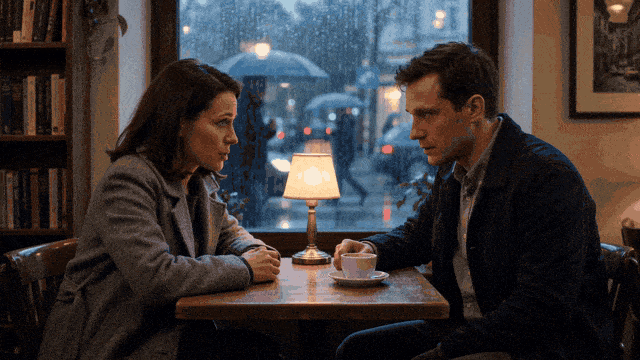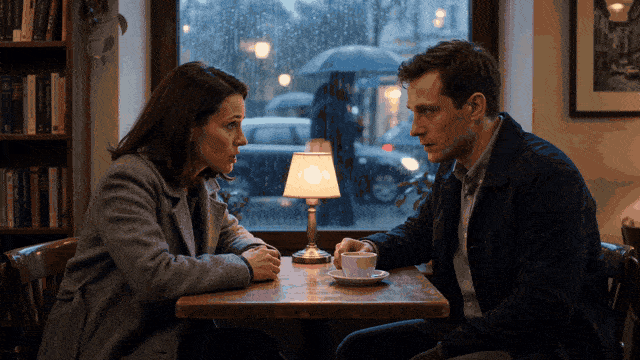
Abbiamo testato la resa vocale inserendo nel prompt una scena ambientata in un bar durante una sera di pioggia con un dialogo in lingua polacca (un ottimo banco di prova per via di fonemi complessi e consonanti articolate): una donna dice „Nie wyjadę bez ciebie. Słyszysz? Nie wyjadę.” (“Non me ne andrò senza di te. Mi senti? Non me ne andrò.”), e l’uomo replica „Wiem.” (“Lo so.”).
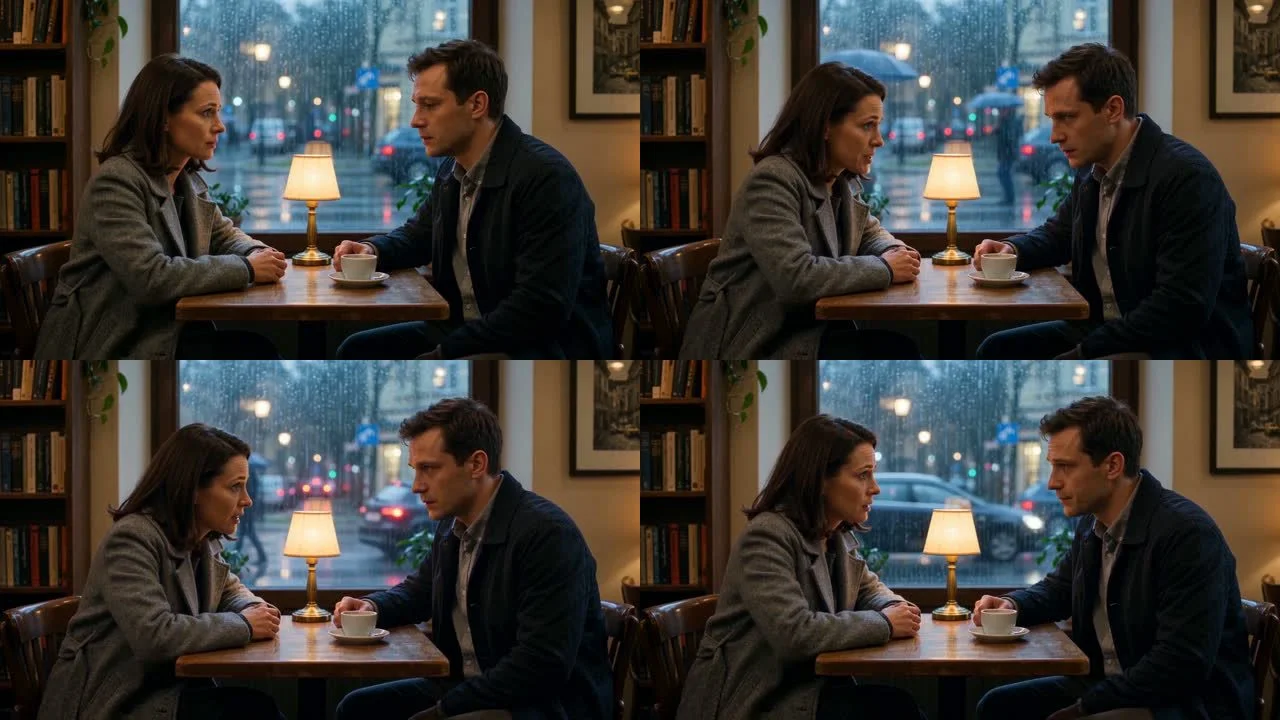
Quattro fotogrammi da una clip di 8 secondi. Personaggi, tavolo, lampada e pioggia fuori dalla finestra restano coerenti per tutta la sequenza.
Abbiamo analizzato la traccia audio con il sistema di trascrizione Whisper. Risultato: il testo è stato riprodotto alla perfezione, parola per parola, con un livello di confidenza del 99%. Le battute rispettano i tempi del prompt: la prima frase si colloca tra i secondi 0 e 4, la risposta al quinto secondo. Si tratta di un netto passo avanti: nei nostri test precedenti con Seedance, la generazione di dialoghi in lingue diverse dall’inglese era del tutto impraticabile.
Costo del test: 0,80 USD. Tempo di generazione: 3 minuti e 38 secondi.
Test 2: testo e caratteri speciali nel video
Strada notturna nel centro storico: un’insegna al neon rossa con la scritta „ŻÓŁTA GĘŚ” (“Oca gialla”) e un cartello sulla vetrina con scritto „Otwarte do północy” (“Aperto fino a mezzanotte”). Una sfida impegnativa che raggruppa numerosi caratteri diacritici complessi contemporaneamente: Ż, Ó, Ł, Ę, Ś.
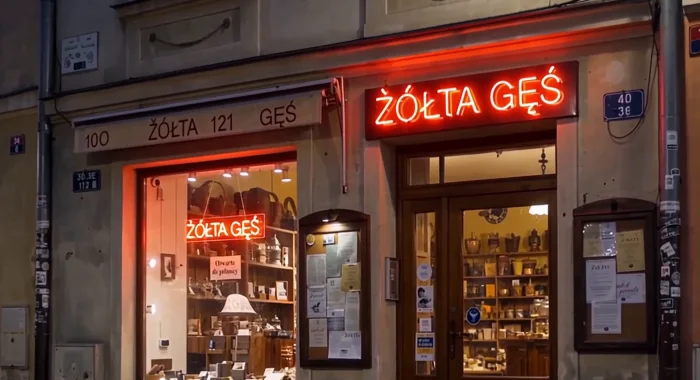
Insegna al neon con i caratteri speciali corretti, ripetuta due volte perché il modello ha inserito autonomamente una seconda insegna nella vetrina. La targa sopra la finestra mostra numeri non richiesti nel prompt.
L’insegna principale è impeccabile: tutti gli accenti e i segni grafici sono al posto giusto, e compaiono addirittura due volte poiché il modello ha duplicato l’insegna all’interno del locale. Ha anche aggiunto una targa con la scritta „100 ŻÓŁTA 121 GĘŚ”: l’ortografia è esatta, ma i numeri sono un’invenzione spontanea del modello.
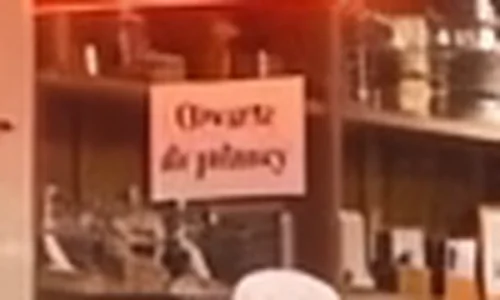
Il cartello nella vetrina ingrandito: la parola „Otwarte” è comprensibile, mentre la parte successiva è distorta.
Il cartello evidenzia i limiti attuali: la parola „Otwarte” è leggibile, mentre „do północy” appare illeggibile e impastata. A 720p, quando i caratteri misurano solo una dozzina di pixel di altezza, l’architettura non riesce a mantenere la definizione tipografica. La stessa Alibaba ha dichiarato che l’accuratezza del testo su schermo è ancora un’area di sviluppo attivo. In sintesi: ottima resa per cartelli grandi e insegne al neon, scarsa affidabilità per scritte piccole o etichette.
Test 3: fisica del movimento e mani
Inquadratura ravvicinata e fissa: un paio di mani versa del caffè da una caraffa di vetro, il flusso si assottiglia fino a interrompersi, una mano solleva la tazzina mentre l’altra vi immerge una zolletta di zucchero.
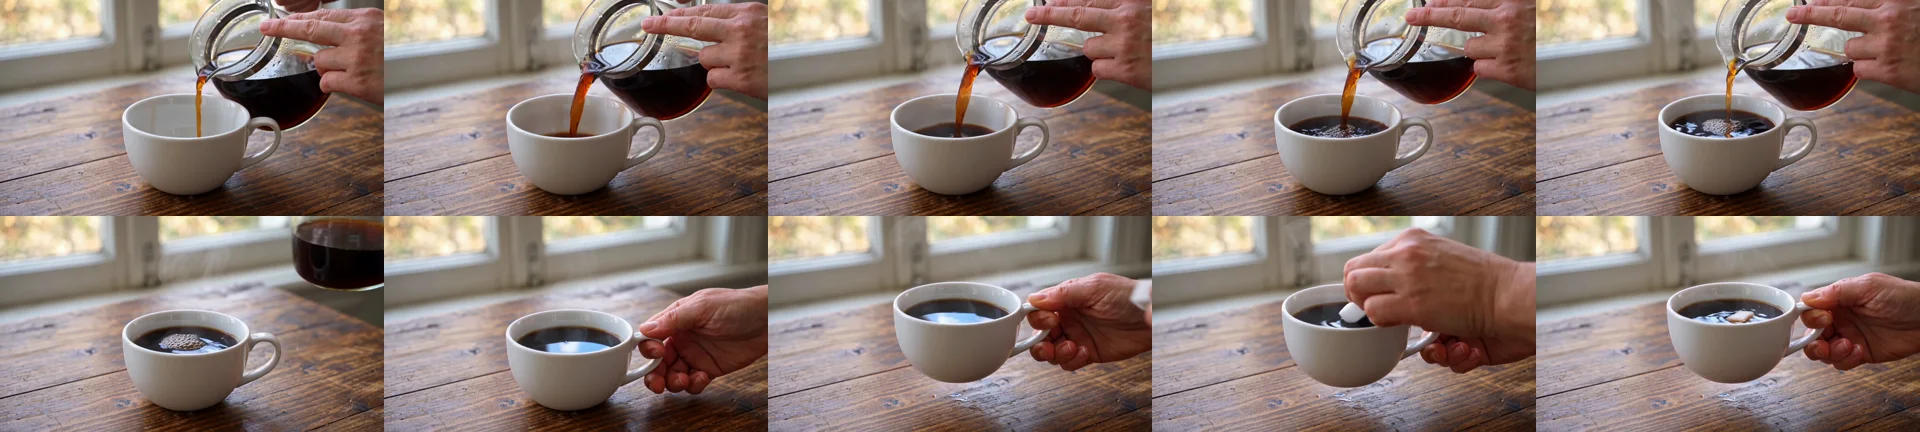
Dieci fotogrammi catturati a intervalli di un secondo. Il getto di liquido si interrompe verso il sesto secondo, la mano alza la tazzina e la zolletta entra al nono secondo.
Il comportamento dei fluidi, la tensione superficiale, il vapore e il movimento delle dita risultano credibili e rispettano esattamente l’ordine temporale descritto nel prompt. Esaminando i fotogrammi a intervalli di un secondo, l’anatomia delle mani non presenta artefatti evidenti o dita di troppo. Costo: 0,8944 EUR (1,00 USD); tempo di elaborazione: 4 minuti.
Test 4: piano sequenza di 30 secondi
Il test più probante: una ripresa continua a mano libera lunga 30 secondi. Un ragazzo con una giacca a vento gialla cammina tra i banchi di un mercato, supera le cassette di mele e i banchi del pesce, acquista una pagnotta di pane, paga il venditore, fa un cenno di saluto e prosegue verso la strada principale mentre passa un tram.
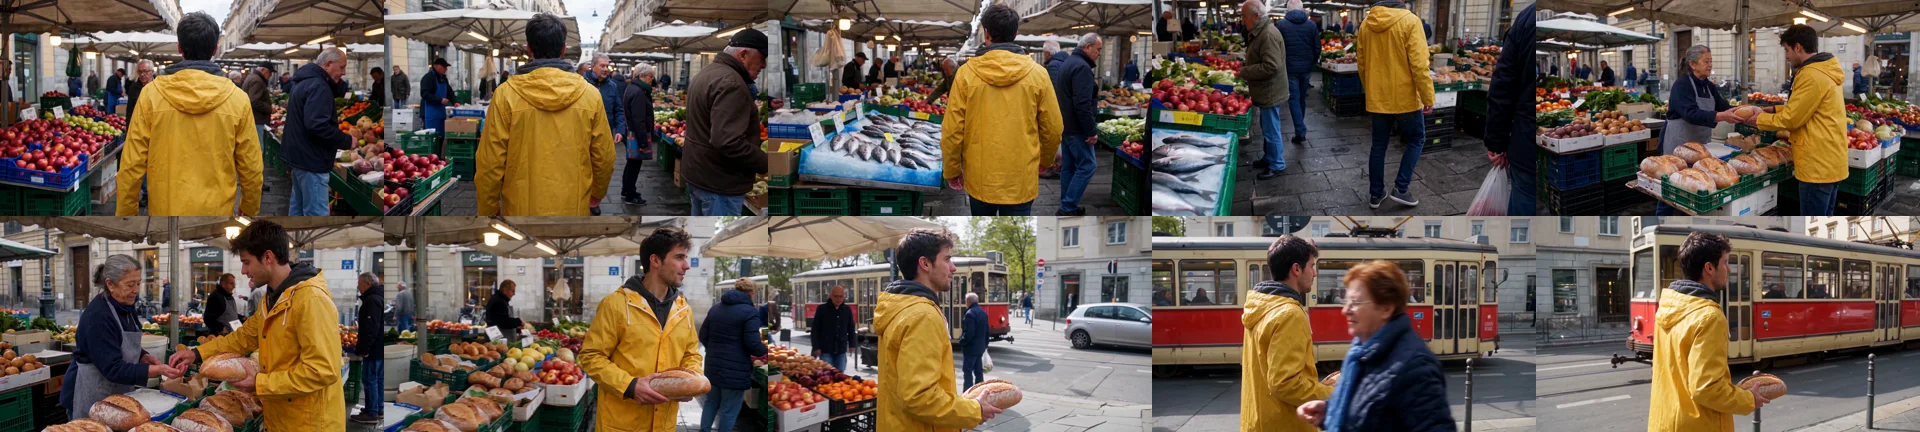
Dieci fotogrammi campionati ogni 3 secondi da un’unica inquadratura di 30 secondi. Le fasi dell’azione si succedono nell’ordine corretto.
Tutti i passaggi richiesti avvengono nella sequenza specificata e l’identità del protagonista resta costante per l’intera durata: lineamenti del volto, giacca e pane in mano non cambiano. Il rilevatore di cambio scena di ffmpeg ha rilevato una variazione solo tra il secondo 20 e 22, ma analizzando i frame a quarti di secondo si nota che si tratta semplicemente di una panoramica rapida alle spalle del soggetto, non di un taglio di montaggio. Unica discrepanza: il cielo risulta nuvoloso anziché soleggiato come indicato.
Questo test nasconde però un imprevisto. Al primo tentativo il filtro di moderazione di fal.ai ha bloccato l’output segnalando una violazione delle policy sui contenuti, nonostante la scena descrivesse un banale mercato rionale. Un secondo tentativo con il prompt identico è andato a buon fine senza problemi. Questo dimostra che i filtri di sicurezza sono non deterministici e generano falsi allarmi - con la beffa di scoprirlo solo dopo aver atteso un quarto d’ora. La generazione valida ha richiesto 13 minuti e 35 secondi per un costo di 3 USD.
Test 5: generare un video da un documento PDF
È la novità principale annunciata da Alibaba: inserire un file o un URL web per fargli creare automaticamente un video esplicativo. Abbiamo sperimentato entrambe le strade.
| Tentativo | Esito |
|---|---|
| URL di un articolo da nitidezza.it | Errore: “impossibile leggere la pagina” - comparso dopo circa 20 minuti |
| URL della voce “Żubr” (bisonte europeo) su Wikipedia | Errore lato provider |
| URL di un file PDF su Wikipedia privo di estensione .pdf finale | Rifiutato all’istante: il link deve terminare con l’estensione del file |
| Stesso PDF caricato direttamente sullo storage di fal.ai | Riuscito - clip da 15 s, 10,5 minuti di calcolo, 1,34 EUR (1,50 USD) |
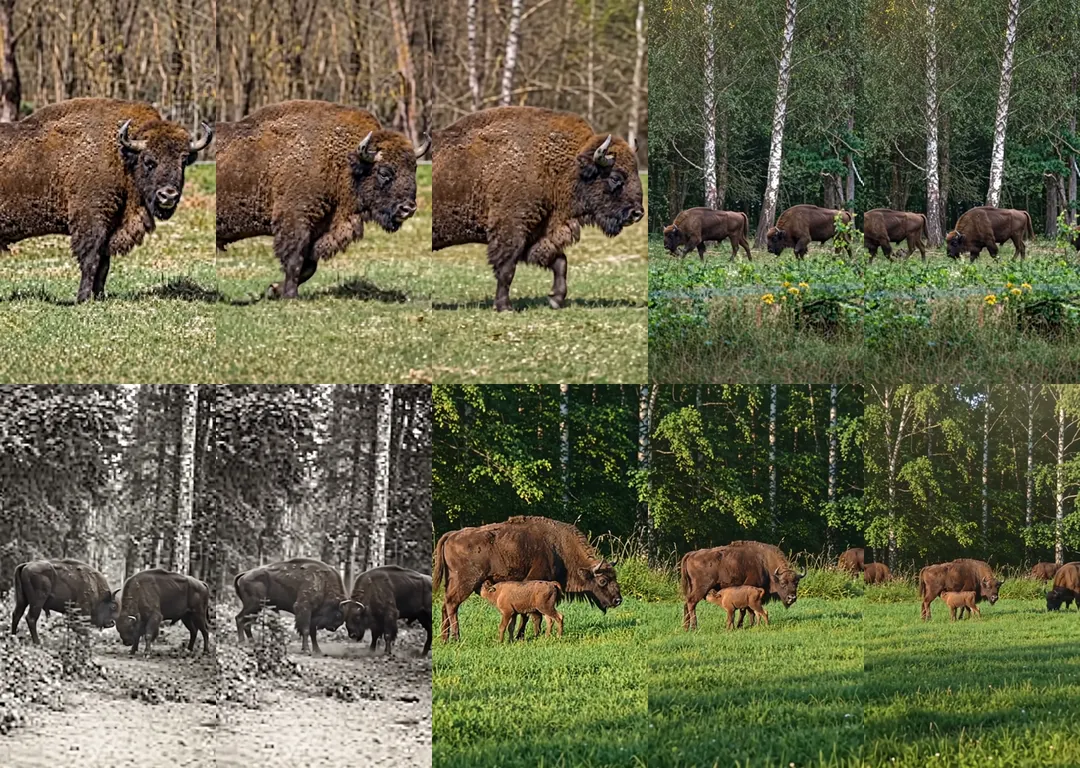
Fotogrammi del filmato di 15 secondi basato sulla voce PDF relativa al bisonte europeo. Quattro scene, con un frammento d’archivio in bianco e nero.
La clip ottenuta dal PDF è il risultato più sorprendente del test. Il sistema ha montato da solo quattro inquadrature distinte (l’algoritmo ffmpeg ha individuato tre stacchi ai secondi 2.8, 8.2 e 10.2): primo piano del bisonte, la mandria nella foresta di betulle, un fotogramma in bianco e nero in stile filmato storico e una madre con il cucciolo. Ha aggiunto una voce narrante: „Meet the European bison, Europe’s largest land mammal. Once nearly extinct, they now roam these primeval forests.”, coerente con le informazioni del documento. Lo speaker ha parlato in inglese perché il nostro prompt di istruzioni era in inglese, benché il PDF sorgente fosse redatto in un’altra lingua. Per ottenere un commento in italiano o in altre lingue, è opportuno richiederlo esplicitamente nel prompt.
La nostra conclusione: la conversione da documento a video funziona, ma solo fornendo direttamente il file caricato. L’elaborazione a partire da URL web non ha funzionato in nessun tentativo tramite fal.ai.
Quanto costa generare video con Wan 3.0
| Clip | Durata | Costo | Tempo di generazione |
|---|---|---|---|
| Dialogo parlato | 8 s | 0,7155 EUR (0,80 USD) | 3 min 38 s |
| Versamento del caffè | 10 s | 0,8944 EUR (1,00 USD) | 4 min 04 s |
| Insegna al neon | 8 s | 0,7155 EUR (0,80 USD) | 3 min 17 s |
| Piano sequenza senza tagli | 30 s | 2,68 EUR (3,00 USD) | 13 min 35 s |
| Video da documento PDF | 15 s | 1,34 EUR (1,50 USD) | 10 min 27 s |
| Totale complessivo | 71 s | 6,35 EUR (7,10 USD) |
I costi fanno riferimento alla tariffa base di 0,0894 EUR (0,10 USD) al secondo a 720p. Il tempo medio di attesa è stato di circa 25 secondi di elaborazione per ogni secondo di video generato. Un ritmo proibitivo per i flussi di lavoro in tempo reale, ma sostenibile per la produzione di contenuti social, spot e materiali promozionali.
A chi serve davvero Wan 3.0
- A chi crea contenuti multilingue: la capacità di riprodurre battute parlate sincronizzate e grandi scritte in lingue diverse dall’inglese è un punto di forza raro nei modelli video attuali.
- A chi deve convertire materiali di lavoro in video: trasformare presentazioni o documenti PDF in brevi clip illustrative fa risparmiare ore di montaggio.
- Non è adatto a chi ha fretta: tra i 3 e i 14 minuti per clip e il rischio di incorrere in falsi positivi del filtro di moderazione.
- Sconsigliato per testi minuscoli: etichette, scritte su foglietti di carta o cartellini dei prezzi risultano illeggibili o artefatti.
Approfondisci il quadro economico dei modelli generativi nella nostra guida su quanto costa un secondo di video con l’AI, oppure scopri il nostro confronto dedicato a cinque modelli linguistici alternativi.
Leggi anche: AI in locale: modelli di testo, immagini e video sul proprio computer · test di 7 modelli da eseguire in locale
Leggi anche: Wan AI: tutte le versioni, prezzi e test con video · Confronto diretto: Wan 3.0 contro Wan 2.2 sugli stessi prompt
Domande frequenti (FAQ)
Wan 3.0 supporta i dialoghi in altre lingue oltre all’inglese?
Sì. Nei nostri test ha pronunciato frasi complesse parola per parola, come confermato dalle analisi fonetiche di Whisper con un livello di confidenza del 99%.
Quanto costa utilizzare Wan 3.0?
Le tariffe API ufficiali sono di 0,0447 EUR (0,05 USD) al secondo a 480p, 0,0894 EUR (0,10 USD) a 720p e 0,1789 EUR (0,20 USD) a 1080p. Una clip completa da 30 secondi a 1080p costa 6 USD.
Wan 3.0 è open source?
No. A differenza di alcune release precedenti della serie Wan, la versione 3.0 non offre pesi aperti scaricabili: l’accesso avviene esclusivamente via API tramite Alibaba Cloud Model Studio o piattaforme terze come fal.ai.
Qual è la durata massima di un video generato?
Arriva fino a 30 secondi in un singolo ciclo di generazione. Il nostro piano sequenza continuo di 30 secondi ha richiesto circa 13 minuti e mezzo di rendering.
Wan 3.0 riesce a creare un video partendo da un PDF?
Sì: nel nostro benchmark ha sintetizzato un documento PDF in un filmato di 15 secondi articolato su quattro inquadrature coerenti con voce narrante. È necessario caricare il file direttamente: l’acquisizione tramite indirizzo web non ha funzionato.
Fonti e data della verifica
Data di rilascio, limiti di durata, risoluzioni, tipologie di file supportati e considerazioni sul rendering tipografico sono tratti dal comunicato ufficiale sul blog di Alibaba Cloud. I prezzi di Wan 3.0 Prime e i parametri di chiamata API provengono dalla documentazione tecnica di fal.ai. Il benchmark text-to-video è basato sui dati aggregati di Artificial Analysis. Tutte le informazioni sono state verificate il 24 settembre 2026. Tutte le clip sono state generate direttamente dal nostro team il 24 settembre 2026 tramite fal.ai a 720p con traccia audio abilitata, registrando il primo tentativo riuscito per ciascun test. Trascrizioni vocali effettuate con Whisper (modello small). I fotogrammi inclusi nell’articolo sono estratti non ritoccati dei file generati; i cambi di scena sono stati analizzati con il filtro scdet di ffmpeg e convalidati manualmente fotogramma per fotogramma.
More on this from NITIDO

 benchmark·Migliori AI per creare video 2026: classifica e testAbbiamo testato 10 modelli video AI su scene complesse e parlato in italiano. Ecco risultati, costi per clip da 5 secondi e tempi di generazione a confronto.