Modelli decisionali AI: classifica e Decision Index
Cosa sono i modelli decisionali AI: Cloudflare Clef, AWS Strands Decider 2B, prezzi, requisiti e un test su RTX 4090 con 30 ticket di supporto.
👁 124 letture
Un modello decisionale è un’intelligenza artificiale che non scrive testo: seleziona direttamente una risposta da una lista predefinita che gli fornisci tu e indica il proprio livello di confidenza. Invece di ottenere una frase come “sembra che questo ticket riguardi i pagamenti”, ricevi un chiaro pagamenti: 0,97, lasciando che sia il tuo codice a stabilire l’azione successiva. Il 1° ottobre 2026, Cloudflare ha rilasciato i modelli aperti Clef e Clef-flash, mentre AWS ha lanciato lo stesso giorno Strands Decider 2B. Ho testato entrambi sulla mia scheda RTX 4090 analizzando 30 ticket di assistenza clienti formulati in polacco.
Artificial Analysis Decision Index: la prima classifica indipendente di modelli decisionali (13 ottobre 2026)
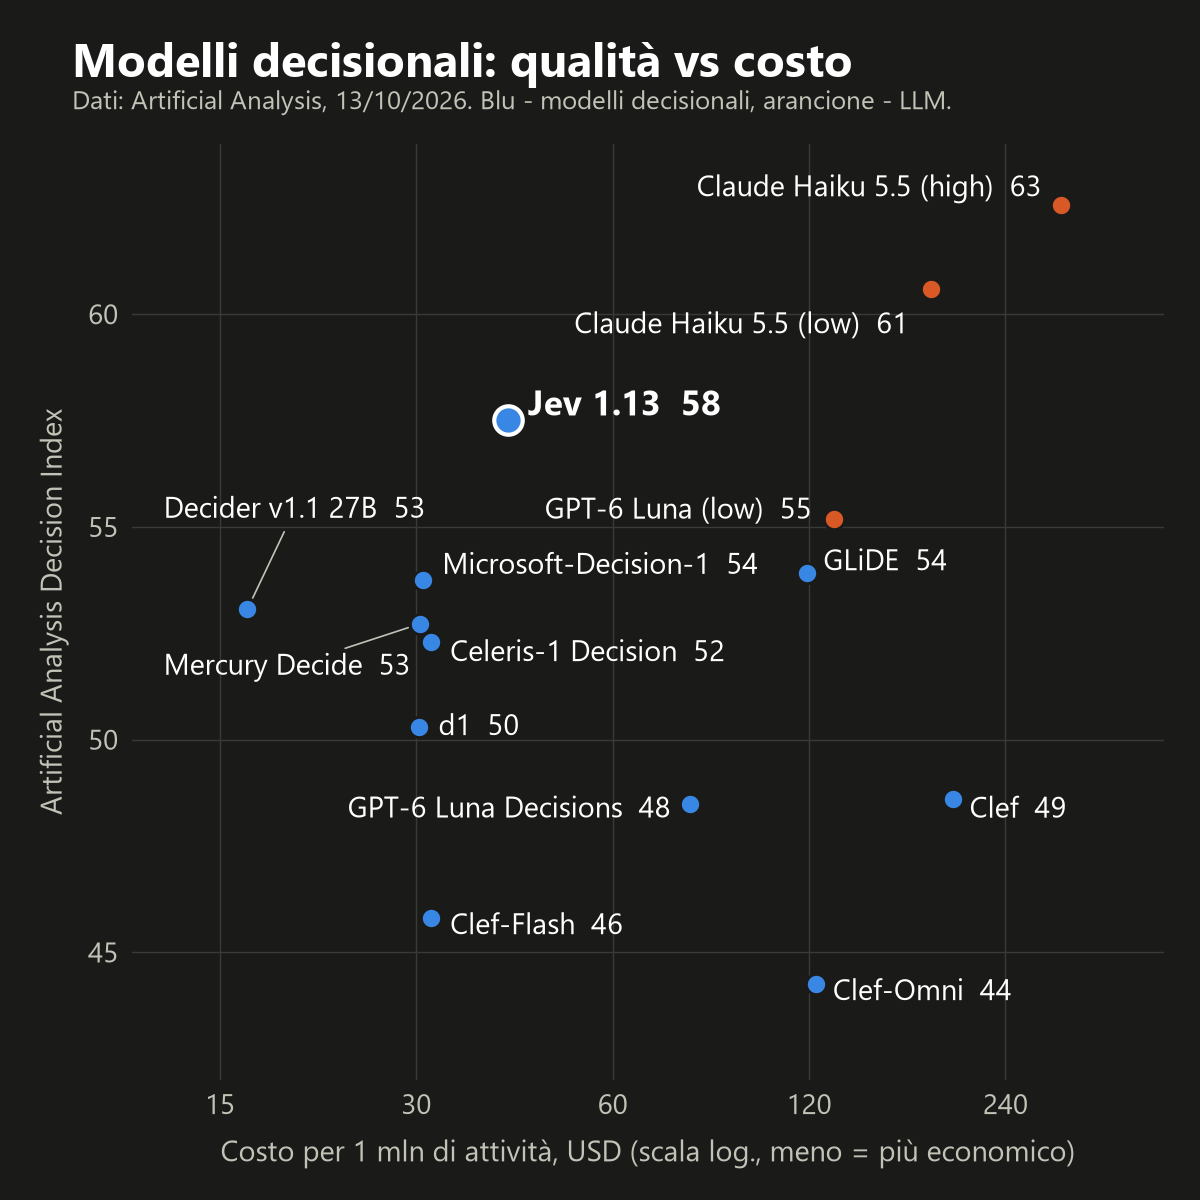
Un modello decisionale non genera testo. Riceve una domanda strutturata - scegliere un’opzione, sì o no, un punteggio - e restituisce una probabilità per ogni opzione consentita in un’unica chiamata. Il 13 ottobre 2026 Artificial Analysis (AA) ha pubblicato il Decision Index v1.0, che confronta 11 modelli di questo tipo tra loro e con i normali LLM che rispondono agli stessi task tramite output strutturati. Tutte le cifre seguenti provengono dalla classifica di AA al 13 ottobre 2026; la tabella online può subire variazioni.
Classifica degli 11 modelli decisionali
| Modello (società) | Indice | Costo per 1M di task | Tempo mediano |
|---|---|---|---|
| Jev 1.13 (TypeSafe) | 57,5 | $41,5 | 127 ms |
| GLiDE (Fastino Labs) | 53,9 | $119,0 | 217 ms |
| Microsoft-Decision-1 (Microsoft) | 53,8 | $30,7 | 207 ms |
| Decider v1.1 27B (Perplexity) | 53,1 | $16,5 | 170 ms |
| Mercury Decide (Inception) | 52.7 | $30,4 | 500 ms |
| Celeris-1 Decision (Celeris) | 52,3 | $31,6 | 63 ms |
| d1 (Liquid AI) | 50,3 | $30,3 | 299 ms |
| Clef (Cloudflare) | 48,6 | $199,4 | 309 ms |
| GPT-6 Luna Decisions (OpenAI) | 48,5 | $78,9 | 168 ms |
| Clef-Flash (Cloudflare) | 45,8 | $31,6 | 298 ms |
| Clef-Omni (Cloudflare) | 44,3 | $123,1 | 172 ms |
A titolo di confronto, gli LLM sugli stessi task: Claude Haiku 5.5 (low reasoning) 60,6 a $184 per 1M di task e 1.434 ms, GPT-6 Luna (low) 55,2 a $131 e 1.500 ms, Claude Opus 5.5 (max) 79,0 a $51.295 e 3.571 ms.
Cosa misurano i quattro test
Ciascun test pesa per il 25% dell’indice:
- AA-Omniscience-Decision - 500 domande su conoscenza privata con 5 opzioni (4 risposte più “Non so”); per metà accuratezza, per metà tasso di non-allucinazione, ovvero quanto spesso un modello che non conosce la risposta sceglie “Non so”.
- HLE-MultiChoice - 513 domande a risposta multipla solo testo tratte da Humanity’s Last Exam (ragionamento complesso).
- When2Call (NVIDIA) - rispondere direttamente, chiamare uno strumento, chiedere ulteriori informazioni o dichiarare di non poter aiutare.
- WildGuardTest (Ai2) - la richiesta è dannosa, è un rifiuto, la risposta è dannosa (F1 medio).
Per i modelli decisionali AA considera l’opzione con la probabilità più alta (per sì/no: sì quando p è pari a 0,5 o superiore). Gli LLM ricevono un prompt di sistema fisso e rispondono in JSON. I modelli decisionali vengono fatturati solo per l’input, gli LLM per input e output.
Punti di forza e di debolezza per test
- La conoscenza è il punto debole di tutti i modelli decisionali: 28-41% di accuratezza contro il 52% di Claude Haiku 5.5 (low) e il 66% di GPT-6 Luna (low). Jev 1.13 ottiene il 34,6%, Microsoft-Decision-1 il 28,2%, il migliore è d1 con il 41,0% - ma d1 non risponde quasi mai “Non so” (1,7).
- Rispondere “Non so”: Microsoft-Decision-1 39,8, Jev 1.13 35,2, Mercury Decide 32,0; nessun altro modello decisionale supera 17, Celeris-1 ottiene 0.
- Ragionamento (HLE-MultiChoice): Jev 1.13 20,9, tutti gli altri modelli decisionali 15,4 o meno.
- Chiamata di strumenti (When2Call): GLiDE e Celeris-1 83,7 - superiori a Claude Haiku 5.5 low (72,6) e GPT-6 Luna low (77,0).
- Classificazione di sicurezza (WildGuardTest): GLiDE 95,1, il miglior risultato dell’intera tabella compresi gli LLM; Decider 93,8, Jev 93,6, Claude Haiku 5.5 low 92,6. Il più debole: GPT-6 Luna Decisions 82,8.
- Secondo AA tutti i modelli decisionali mostrano un eccesso di confidenza, soprattutto su conoscenza e ragionamento; la calibrazione su When2Call e WildGuardTest è relativamente buona.
Costo rispetto alla qualità
- Sulla frontiera di Pareto costo-qualità AA posiziona tre modelli: Decider v1.1 27B ($16,5 per 1M di task), Microsoft-Decision-1 ($30,7) e Jev 1.13 ($41,5).
- Claude Haiku 5.5 (low) ottiene 3 punti in più rispetto a Jev 1.13, ma secondo AA è 11 volte più lento e 4,4 volte più costoso.
- Solo classificazione (WildGuardTest, per 1M di task): Decider $12,1, Microsoft-Decision-1 $12,5, Mercury Decide $12,6, Celeris-1 $16,0, Jev $22,8, GLiDE $84,3 - contro $91,5 per Claude Haiku 5.5 (low) e $3.774 per Claude Opus 5.5 (low).
Prezzi (USD per 1M di token di input, output gratuito, verificati il 13 ottobre 2026)
| Modello | Produttore | OpenRouter |
|---|---|---|
| Jev 1.13 | 0,042 | 0,042 |
| GLiDE | 0,15 (tutti i passaggi interni fatturati) | - |
| Microsoft-Decision-1 | 0,042 (Microsoft Foundry) | 0,042 |
| Decider v1.1 27B | 0,02 | 0,02 |
| Mercury Decide | 0,04 (promo 0,02) | 0,02 |
| Celeris-1 Decision | 0,04 | - |
| d1 | 0,04 | 0,04 |
| Clef | 0,24 (Workers AI) | da 0,042 |
| Clef-Flash | 0,038 | da 0,021 |
| Clef-Omni | 0,15 | 0,15 |
| GPT-6 Luna Decisions | 0,10 (+10% per elaborazione UE/SEE) | 0,10 |
Quando ha senso un modello decisionale al posto di un LLM
- La risposta appartiene a un insieme fisso di opzioni: instradamento dei ticket verso un reparto, flag sì/no, moderazione, scelta se invocare uno strumento. Questo è ciò che misurano tre dei quattro test di AA, e dove i modelli decisionali si avvicinano o superano i piccoli LLM.
- Il volume e la latenza contano: i modelli decisionali rispondono indicativamente in 60-500 ms (mediana AA) e costano decine di dollari per 1M di task, gli LLM sugli stessi compiti impiegano 1,4-3,6 s e costano a partire da circa $130 per 1M di task.
- Serve una probabilità, non solo un’etichetta - per esempio per inviare i casi a bassa confidenza a una persona o a un modello più avanzato.
- Un LLM resta la scelta preferibile per le domande di conoscenza (i modelli decisionali raggiungono il 28-41% nel test di conoscenza di AA) e per qualsiasi operazione che richieda la generazione di testo.
Il nostro test su 50 ticket di supporto in una lingua diversa dall’inglese
Il 13 ottobre 2026 abbiamo eseguito 9 modelli decisionali tramite OpenRouter e due LLM (Claude Haiku 5.5 e GPT-6 Luna, reasoning low) su 50 ticket di supporto e-commerce scritti in polacco (reparto tra 7 opzioni più un flag di urgenza) e 10 conversazioni in stile When2Call. Le risposte corrette sono state stabilite prima dell’esecuzione. Campione ridotto - considerare i risultati come indicativi.
- Reparto su 47 ticket non ambigui: modelli decisionali 41-44 corretti, entrambi gli LLM 45. Jev 1.13 ha ottenuto il risultato più basso (41); Microsoft-Decision-1, Decider, Mercury Decide e Clef 44.
- Urgenza: Decider e GPT-6 Luna Decisions 48 su 50; Microsoft-Decision-1 42 su 50 (8 falsi allarmi con soglia a 0,5).
- Decisione sullo strumento: 7 modelli decisionali ed entrambi gli LLM 10 su 10, Mercury Decide 9, Clef-Flash e Clef-Omni 6.
- Latenza mediana misurata dall’Europa via OpenRouter: modelli decisionali 310-619 ms, Claude Haiku 5.5 1.689 ms, GPT-6 Luna 1.371 ms.
- Costo misurato per 1M di questi task: Mercury Decide $4,4 (prezzo promozionale), Decider $7,8, Microsoft-Decision-1 $11,5, Jev 1.13 $26,8 (ha utilizzato circa 640 token di input per task su questo testo rispetto a circa 275 per Microsoft-Decision-1), Claude Haiku 5.5 $96,7.
- La confidenza funziona come filtro: con confidenza pari o superiore a 0,9 Jev ha risposto correttamente su 37 ticket su 39, Decider su 39 su 41. Un sistema a cascata - prima Microsoft-Decision-1, Claude Haiku 5.5 solo al di sotto di 0,8 di confidenza - ha raggiunto 45 su 47, lo stesso risultato di Haiku da solo, a circa $18 anziché circa $101 per 1M di classificazioni.
Come accedervi
OpenRouter distribuisce 9 degli 11 modelli in classifica tramite un endpoint dedicato, POST https://openrouter.ai/api/alpha/decisions (campi state e questions) - i modelli decisionali non funzionano tramite /chat/completions. GLiDE e Celeris-1 Decision sono disponibili solo tramite le API dei rispettivi produttori. Decider v1.1 27B (Apache-2.0, circa 49 GiB di memoria GPU), d1-3B (LFM Open License, gratuito sotto i 10 milioni di USD di fatturato annuo) e i modelli Clef di Cloudflare (Apache-2.0) presentano pesi aperti.
Articoli sui modelli decisionali
- Decision Index v1.0: la classifica Artificial Analysis
- Decision model vs LLM: differenze, costi e compiti
- Prezzi e costi dei decision model: analisi comparativa
- Quale decision model scegliere: guida ai compiti
Fonti
- Artificial Analysis - Decision Index announcement
- Artificial Analysis - Decision Index leaderboard
- Artificial Analysis - Decision Index methodology
- OpenRouter - Decisions API
- TypeSafe - Jev models
- Fastino - GLiDE
- Microsoft - Microsoft-Decision-1 in Foundry
- Perplexity - Decisions API
- Inception - Mercury Decide
- Celeris - Celeris-1 Decision
- Liquid AI - d1
- Cloudflare - Clef
- OpenAI - Decisions guide
Situazione al 7 ottobre 2026
- Cloudflare Clef (27B, basato su Qwen3.8-27B) e Clef-flash (9B, basato su Qwen3.5-9B) - licenza Apache-2.0, pesi disponibili su Hugging Face, hosting su Workers AI a circa 0,21 EUR (0,24 USD) e circa 0,08 EUR (0,09 USD) per milione di token di input (tasso BCE del 12/10/2026: 1 EUR = 1,1181 USD).
- Strands Decider 2B di AWS - licenza Apache-2.0, pesi, dataset di training e script pubblici; è utilizzabile perfino su CPU.
- Kev 1.0 (Jared Palmer) - serie di modelli aperti da 0,8B a 27B, ottimizzati solo per l’inglese.
- Aplomb 1 di EmpirioLabs (rilasciato il 29 settembre) - 5,3B, gestisce testo, JSON, immagini, video e audio, finestra di contesto da 1 milione di token, pesi sotto licenza proprietaria, API a circa 0,018 EUR (0,02 USD) per milione di token di input. Dettagli.
- Tutti questi modelli adottano l’API standard definita da Jev di TypeSafe (System One), che il 15 settembre ha inaugurato questa categoria.
- Il mio test: Clef-flash e Strands Decider hanno classificato correttamente il reparto competente in 30 casi su 30 su ticket polacchi, con una latenza mediana rispettivamente di 112 e 135 ms per decisione.
Cos’è un modello decisionale
Un tipico modello linguistico (LLM) genera testo un token dopo l’altro. Anche quando gli chiedi di rispondere solo con una singola parola o con un JSON, continua a scrivere, semplicemente riducendo l’output. Un modello decisionale lavora con un’architettura radicalmente diversa:
- Riceve uno stato: il testo del ticket, un payload JSON con i dati dell’ordine e, nel caso di Clef, eventualmente un’immagine.
- Riceve una serie di domande con opzioni chiuse: ad esempio “quale reparto?” con scelte come
pagamenti,consegna,resi… - Elabora lo stato con un solo passaggio (passata di prefill) e calcola una probabilità per ogni opzione permessa. Non c’è alcun campionamento di testo né parsing: è impossibile ottenere una risposta che non faccia parte della lista.
I modelli di questa famiglia gestiscono tre categorie di quesiti, rese celebri da Jev di TypeSafe:
| Tipo | Cosa chiedi | Cosa restituisce |
|---|---|---|
choice |
Scegli un’opzione da una lista | Opzione selezionata, livello di confidenza e distribuzione completa di probabilità |
noul |
Sì o no? | Probabilità del “sì” espressa come valore tra 0 e 1 |
score |
Valutazione su scala (es. nessun impatto, basso, alto, critico) | Livello atteso, confidenza e distribuzione statistica |
La differenza fondamentale sta nel fatto che il valore ottenuto è una probabilità matematica calcolata direttamente dai pesi, non un testo del tipo “sono sicuro al 90%”, che un LLM generativo potrebbe inventare. Questo ti consente di definire una soglia netta di automazione: se la confidenza supera 0,8 il sistema procede da solo, se è inferiore la richiesta viene inoltrata a un operatore umano.
Casi d’uso ideali e limiti
Ambiti in cui eccellono:
- Routing dei ticket di supporto: reparto di destinazione, priorità, lingua del cliente, rischio di abbandono (churn).
- Moderazione dei contenuti: verificare violazioni dei termini, rilevare spam o approvare immagini da pubblicare (Clef supporta file visivi).
- Smistamento documenti: classificazione delle fatture, categorie di spesa o presenza di clausole contrattuali specifiche.
- Tool selection negli agenti autonomi: invece di domandare a un modello generativo costoso “quale funzione chiamare?”, interroghi un modello decisionale rapido (meccanismo approfondito nell’articolo sul function calling).
- Controllo dei workflow agentici (guardrail): verificare se l’output dell’agente rispetta le regole, stabilire se scalare la richiesta a un operatore umano o scegliere il modello migliore da attivare.
Scenari inadatti:
- Generazione di testi, riassunti, traduzioni, interazioni via chat o scrittura di codice: questi modelli non generano frasi;
- Domande aperte (“cosa intende il cliente?”): senza un elenco predefinito di opzioni, il modello non ha elementi tra cui scegliere;
- Ragionamento complesso multi-step: gli sviluppatori di Strands Decider sottolineano chiaramente che le prestazioni decadono sensibilmente sui compiti logici articolati.
Nella pratica aziendale, il modello decisionale lavora a fianco dell’LLM: gestisce centinaia di scelte binarie e categorizzazioni fulminee, lasciando al modello generativo solo i compiti in cui serve produrre testo. Per vedere come coordinare questi elementi in un’unica architettura, puoi consultare la guida su come creare agenti AI da zero.
Panoramica dei modelli decisionali a ottobre 2026
| Modello | Autore | Dimensione e base | Licenza | Disponibilità |
|---|---|---|---|---|
| Jev | TypeSafe | Non dichiarata | Pesi proprietari | API TypeSafe (System One) |
| Clef | Cloudflare | 27B, Qwen3.8-27B + joint schema head | Apache-2.0 | Workers AI, Hugging Face (55 GB) |
| Clef-flash | Cloudflare | 9B, Qwen3.5-9B + joint schema head | Apache-2.0 | Workers AI, Hugging Face (19 GB) |
| Strands Decider 2B | AWS (Strands Labs) | 2B, Qwen3.5-2B-Base + LoRA + pointer head | Apache-2.0 | Hugging Face, GitHub, pip install strands-decider |
| Kev 1.0 | Jared Palmer | 0,8B, 4B, 9B, 27B (Qwen3.5/3.8) | Apache-2.0 | Hugging Face, GitHub |
| Aplomb 1 | EmpirioLabs | 5,3B, Qwen3.5-4B | EmpirioLabs Model License 1.0 (gratuita per uso interno/ricerca in realtà con fatturato sotto 1 mln USD) | Hugging Face (previa autorizzazione licenza), API EmpirioLabs |
| Decisions API | OpenAI | Modello Luna | Proprietario | Anteprima limitata, prezzi non comunicati |
Clef, Clef-flash, Strands Decider e Kev condividono lo standard System One, ricalcando l’interfaccia di Jev (endpoint POST /v1/systemone con i parametri state e questions). Il client può interagire con tutti questi modelli usando il medesimo codice sorgente, cambiando unicamente l’URL e l’identificativo del modello. Aplomb 1 offre invece un endpoint dedicato POST /v1/decisions, oltre a supportare i formati chat di OpenAI, Anthropic e Gemini. Ho accennato alla Decisions API di OpenAI parlando della nuova Agents API.
Cloudflare Clef e Clef-flash
La soluzione di Cloudflare impiega un modello base Qwen congelato, esegue un singolo prefill dell’input senza generazione successiva e convoglia gli stati interni verso un modulo dedicato chiamato joint schema head. Questa testata analizza simultaneamente tutte le opzioni di tutti i quesiti, valutando anche le correlazioni reciproche. Stando a Cloudflare, si tratta del primo modello decisionale con encoder visivo integrato e supporto a un contesto di 64.000 token. Ho descritto l’annuncio e i punteggi nei benchmark nel report su Cloudflare Clef, mentre ho analizzato la piattaforma generale nella guida a Cloudflare.
Amazon Strands Decider 2B
È il modello aperto più compatto. AWS ha mantenuto il corpo centrale di Qwen3.5-2B-Base, rimosso il layer di generazione linguistica e inserito una pointer head da poco più di un milione di parametri, affiancata da un adapter LoRA di rango 16. Su Hugging Face trovi il checkpoint strands-decider-2B-hobson-v19, completo di script e dati di addestramento. Gli autori indicano una latenza mediana di circa 115 ms su scheda RTX 3090 e 153 ms su chip Apple M3. Nel benchmark pubblico JevBench ha risolto 167 compiti su 231 (72,3%).
Kev 1.0
Kev nasce da un’iniziativa di Jared Palmer (creatore di Formik e Turborepo): prevede quattro varianti da 0,8B a 27B, integra una pointer head con LoRA su base Qwen3.5/Qwen3.8 ed è rilasciato sotto licenza Apache-2.0. Rispettando le specifiche dell’API System One, permette di utilizzare l’SDK di TypeSafe con un server locale Kev senza ritocchi. Il modello è stato addestrato e testato esclusivamente in inglese; la versione da 9B richiede circa 22 GB di VRAM stando alla scheda tecnica. Non ho inserito Kev nella prova comparativa per i motivi esposti più avanti.
EmpirioLabs Aplomb 1
Aplomb 1 (debuttato il 29 settembre 2026, con documentazione aggiornata il 5 e 6 ottobre) rappresenta l’opzione più snella capace di accettare contemporaneamente testo, JSON, fino a 16 immagini, 8 tracce audio e 4 video in una sola chiamata, gestendo un contesto esteso a 1 milione di token. Con 5,3 miliardi di parametri derivati da Qwen3.5-4B, necessita di circa 12 GB di VRAM in formato bf16 secondo il team di sviluppo. Oltre ai quesiti standard noul, choice e score, supporta il tipo tool, utile per scegliere la funzione corretta abbinando la probabilità ai singoli parametri.
- Benchmark del costruttore: 44,86 punti nel Decision Index 0.2.1 (test interno di EmpirioLabs del 5/10, non verificato nella leaderboard ufficiale); sulle immagini registra 89,0 su POPE, 68,6 su MMStar e 87,0 su AI2D.
- Elaborazione audio: unico modello della comparativa in grado di ascoltare input sonori (ad esempio, 91,9% nel riconoscimento di vocalizzazioni).
- Termini di licenza: non si tratta di una licenza Apache-2.0. L’uso è gratuito per ricerca, studio e progetti interni in aziende sotto 1 milione di USD di fatturato annuo; servizi gestiti o imprese di dimensioni superiori devono richiedere una licenza commerciale.
- Tariffa API: circa 0,018 EUR (0,02 USD) per milione di token di input (tasso BCE del 12/10/2026: 1 EUR = 1,1181 USD), output a costo zero.
Non ho inserito Aplomb 1 nel test pratico: i pesi risiedono dietro un form di registrazione della licenza e l’accesso all’API richiede un account abilitato. Trovi tutti i dati e le clausole d’uso nell’articolo dedicato ad Aplomb 1 di EmpirioLabs.
Costi e requisiti hardware a confronto
| Modello | Infrastruttura | Costo | Uso locale |
|---|---|---|---|
| Clef | Workers AI @cf/cloudflare/clef |
~0,21 EUR (0,24 USD) / mln token input | 55 GB di pesi in bf16; richiede quantizzazione per girare su 24 GB (non ufficiale) |
| Clef-flash | Workers AI @cf/cloudflare/clef-flash |
~0,08 EUR (0,09 USD) / mln token input | 19 GB di pesi, picco registrato nel test: 18,3 GB VRAM |
| Strands Decider 2B | Nessun hosting gestito, server proprio | 0 USD (solo consumi hardware ed energia) | 4,4 GB di download, picco di 3,8 GB VRAM; compatibile con CPU e Mac |
| Kev-9B | Nessun hosting gestito | 0 USD | Circa 22 GB di VRAM secondo l’autore |
| Aplomb 1 | API EmpirioLabs | ~0,018 EUR (0,02 USD) / mln token input, output gratuito | Circa 12 GB in bf16 indicati dal produttore (non verificati personalmente) |
| Jev | API TypeSafe | ~0,038 EUR (0,042 USD) / mln token input, output gratuito | Non eseguibile in locale |
*I prezzi convertiti in EUR sono stime calcolate al tasso di riferimento BCE del 12/10/2026 (1 EUR = 1,1181 USD, fonte: ecb.europa.eu). I servizi possono applicare IVA locale o costi infrastrutturali separati.
La piattaforma Workers AI include una quota gratuita di 10.000 “neuroni” al giorno sia nel piano Free che in quello Paid. Clef assorbe 21.818 neuroni per ogni milione di token in ingresso, mentre Clef-flash ne richiede 8.182: significa poter elaborare a costo zero circa 458.000 token al giorno con Clef e circa 1,2 milioni con Clef-flash. Una richiesta standard con testo breve e due domande impegna solitamente 150-250 token, consentendo migliaia di valutazioni quotidiane gratuite. Serve un account Cloudflare (che per questa prova non ho attivato, basandomi sui dati delle specifiche ufficiali per la variante cloud).
Il mio test su RTX 4090: 30 ticket di supporto clienti
Per la prova ho creato 30 ticket tipici di un portale e-commerce o di una piattaforma SaaS: pagamenti, spedizioni, resi, gestione profilo, disservizi tecnici e vendite, distribuendo 5 richieste per categoria. Il materiale di test è stato formulato originariamente in lingua polacca, inserendo deliberatamente refusi, caratteri privi di diacritici o casistiche al limite tra due settori (come una contestazione su un rimborso non pervenuto, a metà strada tra pagamenti e resi). Ciascun modello ha dovuto risolvere due problemi: individuare il reparto corretto tra 6 scelte e indicare se la pratica richiedesse una gestione immediata in giornata. I modelli decisionali sono stati interrogati tramite API proprietaria, mentre gli LLM generativi hanno risposto tramite Ollama o OpenRouter con temperature impostata a 0 e schema JSON forzato.
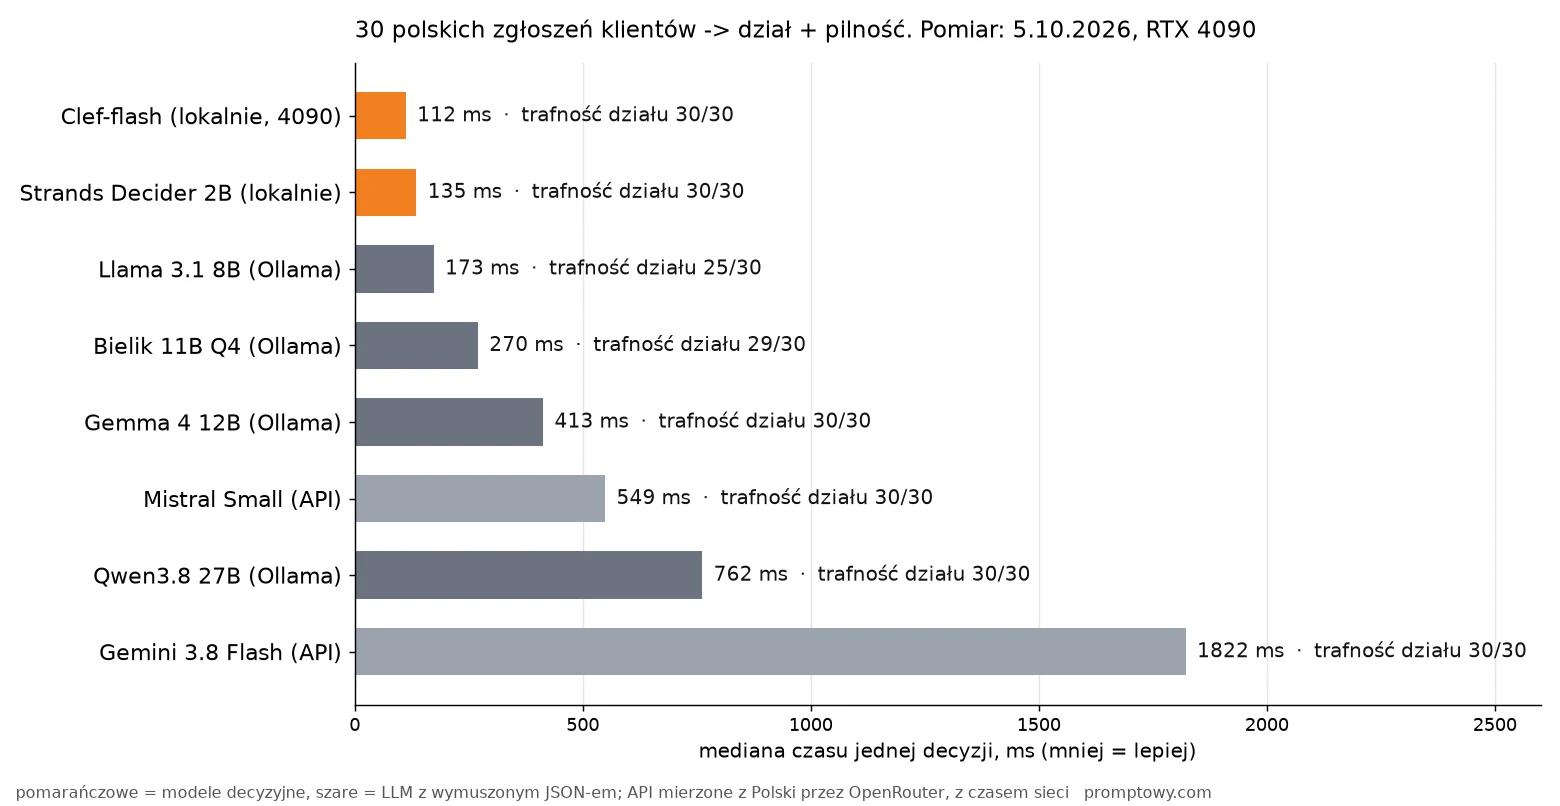
| Modello | Reparto (test in PL) | Urgenza (test in PL) | Tempo mediano | Memoria occupata |
|---|---|---|---|---|
| Clef-flash (locale) | 30/30 | 26/30 (28/30 con soglia a 0,95) | 112 ms | 18,3 GB VRAM |
| Strands Decider 2B (locale) | 30/30 | 24/30 (26/30 con soglia a 0,4) | 135 ms | 3,8 GB VRAM |
| Llama 3.1 8B (Ollama) | 25/30 | 23/30 | 173 ms | File da 4,9 GB |
| Bielik 11B Q4 (Ollama) | 29/30 | 21/30 | 270 ms | File da 6,7 GB |
| Gemma 4 12B (Ollama) | 30/30 | 26/30 | 413 ms | File da 7,0 GB |
| Qwen3.8 27B (Ollama) | 30/30 | 27/30 | 762 ms | File da 16 GB |
| Mistral Small 2603 (API) | 30/30 | 19/30 | 549 ms | - |
| Gemini 3.8 Flash (API) | 30/30 | 26/30 | 1822 ms | - |
Le conclusioni principali emerse dalle misurazioni:
- L’individuazione del reparto si è rivelata troppo semplice per creare un divario netto. 6 modelli su 8 hanno ottenuto il punteggio pieno di 30/30. Su un campione di trenta elementi, uno scarto minimo rientra nella tolleranza statistica. L’unica battuta d’arresto rilevante ha riguardato Llama 3.1 8B (fermo a 25/30), che ha scambiato una fattura per una richiesta commerciale e un guasto su una macchina da caffè per un’interruzione di servizio generica.
- Il vero punto di forza risiede nella velocità pura. Sulla stessa GPU, Clef-flash ha risposto con una rapidità 3,7 volte superiore rispetto a Gemma 4 12B e quasi 7 volte superiore rispetto a Qwen3.8 27B, che pure condivide quasi interamente l’architettura con il Clef da 27B. Questo vantaggio è stato registrato persino senza compilare kernel ad alte prestazioni (flash-linear-attention e causal-conv1d risultano ostici da configurare su ambiente Windows, costringendo la libreria transformers a elaborare i layer di attenzione lineare nella modalità di riferimento non ottimizzata).
- La soglia di confidenza va calibrata sui tuoi flussi reali. Strands Decider ha mostrato una tendenza a sottostimare la probabilità di urgenza sul testo polacco: nessun caso ha toccato lo 0,5, impedendo al sistema di segnalare emergenze con la soglia standard. Tuttavia l’ordinamento relativo era impeccabile: abbassando la soglia a 0,4, la precisione è salita a 26/30. Clef-flash ha mostrato l’effetto opposto: a 0,5 restituiva 4 falsi allarmi, mentre con una soglia impostata a 0,95 gli errori sono scesi ad appena 2.
- Efficacia multilingue anche senza training specifico. Benché i modelli siano stati addestrati prevalentemente in lingua inglese, hanno compreso perfettamente i ticket in polacco. Rieseguendo il test con le richieste tradotte in inglese i risultati non sono cambiati: Clef-flash ha chiuso con 29/30 e Strands con 29/30 (entrambi hanno esitato sulla variazione di un abbonamento a ciclo di fatturazione in corso).
- La definizione di urgenza mantiene una componente soggettiva. Avevo catalogato come urgenti 6 casi specifici (errore server 502, violazione del profilo utente, doppio addebito su carta…). Praticamente tutti i modelli hanno marcato come urgente anche un pagamento istantaneo non visualizzato nella dashboard del cliente: una decisione aziendalmente del tutto ragionevole.
Costo complessivo dell’esperimento: 0 EUR per le esecuzioni in locale e circa 0,036 EUR (0,04 USD) su OpenRouter per inoltrare le 180 chiamate verso Mistral e Gemini. Gemini 3.8 Flash non consentiva la disattivazione del modulo di reasoning, operando al livello minimo e registrando una latenza di circa 1,8 secondi. Ho archiviato script e dataset per riutilizzarli sui prossimi aggiornamenti.
Perché non ho incluso Clef 27B e Kev nella prova
- Clef 27B richiede 55 GB di memoria in formato bf16. Non può essere caricato in una scheda da 24 GB senza quantizzazione, ma Cloudflare non ha rilasciato pesi ufficiali a 4 o 8 bit. Il modello adotta una testata custom e un’implementazione proprietaria (
joint_schema_model.py), rendendolo incompatibile con Ollama o llama.cpp tramite file GGUF. Sarebbe stato possibile caricarlo a 4 bit tramite bitsandbytes, ma il comportamento avrebbe deviato da quello ufficiale verificato da Cloudflare. - Kev-9B richiede il download preliminare della base separata Qwen3.5-9B-Base (ulteriori 19 GB circa), superando la soglia di 40 GB complessivi che avevo stabilito per questo banco di prova. Inoltre lo sviluppatore garantisce l’accuratezza soltanto su materiale in lingua inglese.
- Workers AI richiede la creazione e validazione di un profilo Cloudflare con credenziali, passaggio che ho evitato per concentrarmi sull’esecuzione hardware locale.
Modelli decisionali contro LLM con structured output
Puoi raggiungere un traguardo identico adoperando un modello linguistico tradizionale costretto a emettere un formato JSON conforme a uno schema (come ho illustrato nella guida sullo structured output). Ecco come orientare la scelta:
| Caratteristica | Modello decisionale | LLM + structured output |
|---|---|---|
| Risposta non contemplata | Impossibile per via della struttura intrinseca | Esclusa dallo schema, ma il validatore può generare un errore di parsing (vedi la guida su come risolvere errori JSON dei modelli) |
| Valutazione di confidenza | Probabilità matematica reale per ogni scelta | Assente, oppure stimata “a sensazione” nel testo dal modello |
| Quesiti multipli simultanei | Praticamente a costo zero in termini di latenza | Ogni parametro extra richiede la generazione sequenziale di nuovi token |
| Motivazione dell’esito | Non disponibile | Può spiegare nel dettaglio le ragioni del verdetto |
| Ragionamento logico avanzato | Capacità ridotta | Superiore, specialmente con modelli dedicati al reasoning |
| Spesa computazionale in cloud | Fatturazione limitata ai token di ingresso | Fatturazione di input, output e token di ragionamento |
La mia regola empirica: se il problema prevede risposte da un menu chiuso e i volumi operativi sono elevati (centinaia o migliaia di casi giornalieri), conviene puntare su un modello decisionale. Se occorre una spiegazione discorsiva o la logica necessita di passaggi intermedi, serve un LLM. L’integrazione ideale sfrutta entrambi: il modello decisionale processa i casi chiari a latenza minima e inoltra le richieste incerte (con confidenza inferiore alla soglia impostata) a un LLM di grandi dimensioni o all’assistenza umana.
Come iniziare in 10 minuti
- Installa Python (versione 3.10 o successiva) e PyTorch con supporto CUDA (il codice funziona anche su processore, ma con tempi più lunghi).
- Esegui
pip install strands-decider: scaricherai il modello più snello, circa 4,4 GB. - Invia la prima interrogazione dal terminale:
# Esempio adattato dal test originale (il prompt originale era in polacco) strands-decider ask StrandsAgents/strands-decider-2B-hobson-v19 --state "Mi avete addebitato due volte lo stesso importo per l'abbonamento mensile" --choice "Quale reparto?=pagamenti,consegna,resi,account,guasto,commerciale" --noul "La pratica richiede gestione immediata oggi?" - Una volta verificato il funzionamento, avvia il server locale con
strands-decider serve ... --port 8000per gestire chiamate in formato System One. Il servizio apre le porte solo su 127.0.0.1 senza sistema di autenticazione: se intendi portarlo in produzione, posizionalo dietro un reverse proxy adeguato. - Se hai una scheda grafica con 24 GB di VRAM, puoi passare a Clef-flash: scarica i pesi con
snapshot_download("Cloudflare/clef-flash")e richiama la funzionesystemone()inclusa nel repository. L’interfaccia delle richieste rimarrà immutata.
Se non possiedi un server dedicato con GPU, l’alternativa naturale è rappresentata da Workers AI o dall’API di TypeSafe. Un computer domestico può caricare agevolmente modelli compatti via Ollama, ma solo se si tratta di LLM tradizionali: le architetture decisionali montano testate personalizzate e richiedono l’ambiente Python basato sulla libreria transformers.
A chi serve questa tecnologia
- Scelta consigliata: negozi online e servizi SaaS che necessitano di smistare automaticamente i ticket di supporto; team che sviluppano architetture di agenti basate su frequenti decisioni binarie o multiple; piattaforme con workflow di moderazione visiva e testuale; aziende che vogliono tagliare i costi sostenuti per modelli generativi usati semplicemente per ottenere un “sì” o un “no”.
- Scelta sconsigliata: progetti in cui serve produrre testo naturale, sostenere conversazioni o generare codice; contesti con pochi casi al giorno (dove la versatilità di un classico LLM supera ogni vantaggio di costo); realtà prive di un set di dati storici etichettati utile a definire le soglie di probabilità.
Domande frequenti (FAQ)
Cosa si intende per modello decisionale AI?
È un’architettura neurale progettata non per scrivere frasi, ma per calcolare la distribuzione di probabilità e selezionare la risposta corretta da una serie predeterminata di opzioni. Gestisce selezioni su liste (choice), quesiti booleani (noul) e valutazioni progressive (score).
Cos’è Cloudflare Clef?
È una suite di modelli decisionali open source introdotta da Cloudflare il 1° ottobre 2026, composta da Clef (27B, costruito su Qwen3.8-27B) e Clef-flash (9B, basato su Qwen3.5-9B). Rilasciati sotto licenza Apache-2.0 con checkpoint su Hugging Face e hosting cloud su Workers AI, gestiscono testo, JSON, immagini e video con un contesto massimo di 64.000 token.
L’uso di Clef è gratuito?
I pesi sono del tutto gratuiti e utilizzabili liberamente (inclusi scopi commerciali) grazie alla licenza Apache-2.0. Utilizzando l’infrastruttura Cloudflare Workers AI, il costo ammonta a circa 0,21 EUR (0,24 USD) per Clef e circa 0,08 EUR (0,09 USD) per Clef-flash per milione di token in ingresso, con un plafond gratuito giornaliero di 10.000 neuroni (circa 458.000 token con Clef e 1,2 milioni con Clef-flash).
I modelli decisionali comprendono lingue diverse dall’inglese?
Nel mio test hanno dimostrato piena comprensione anche su ticket in lingua polacca: sia Clef-flash che Strands Decider 2B hanno centrato l’assegnazione corretta in 30 casi su 30. L’unico aspetto che richiede attenzione è la taratura statistica delle probabilità, che può risultare sfalsata rispetto all’inglese: le soglie decisionali vanno sempre verificate sui propri dati. Kev supporta esplicitamente solo l’inglese.
Che hardware serve per eseguire Clef in locale?
Clef-flash ha occupato 18,3 GB di memoria video durante i miei test, risultando utilizzabile su GPU consumer come GeForce RTX 3090, 4090 o 5090. La versione completa Clef da 27B occupa 55 GB in precisione bf16 e impone schede professionali (come H100/H200) oppure versioni quantizzate, attualmente non fornite in via ufficiale. Strands Decider 2B si accontenta di meno di 4 GB di VRAM e può girare persino su CPU tradizionali e Mac. Per maggiori dettagli, leggi l’approfondimento su quanta VRAM serve per i modelli in locale.
Qual è la differenza rispetto al function calling?
Il function calling consente a un LLM convenzionale di produrre il nome di una funzione e valorizzarne i relativi argomenti in formato testuale. Un modello decisionale si occupa specificamente della fase di routing e selezione del tool ottimale, senza generare stringhe descrittive. Spesso lavorano in tandem: il modello decisionale individua l’azione e l’LLM ne scrive i parametri complessi.
Cos’è Aplomb 1?
È un modello decisionale open weight annunciato da EmpirioLabs il 29 settembre 2026. Conta 5,3 miliardi di parametri, elabora input multimodali complessi (testo, JSON, immagini, video e audio), supporta 1 milione di token di contesto e introduce la categoria di quesito tool. I pesi sono archiviati su Hugging Face con licenza specifica di EmpirioLabs, mentre l’endpoint API ufficiale costa circa 0,018 EUR (0,02 USD) per milione di token di input.
Strands Decider può essere impiegato per fini commerciali?
Certamente. Pesi, codice sorgente e dataset di training sono regolati dalla licenza permissiva Apache-2.0, analogamente al modello base di partenza Qwen3.5-2B-Base. Il modulo server integrato non include sistemi di controllo accessi: va protetto dietro un gateway dedicato prima della pubblicazione online.
Cosa sono Jev e System One?
Jev è il capostipite dei modelli decisionali, sviluppato da TypeSafe e lanciato via API il 15 settembre 2026. System One è lo standard di comunicazione aperto introdotto da quell’architettura (basato su payload con stato, quesiti definiti e tipi prefissati), a cui si sono conformati Clef, Kev e Strands Decider. Ne ho parlato nell’approfondimento su TypeSafe e il modello Jev.
Google · Le tue fontiPiù in alto su Google con un solo clicAggiungi alle fonti preferite →Fonti
- Cloudflare: Introducing Clef (01/10/2026)
- Cloudflare/clef e Cloudflare/clef-flash su Hugging Face
- Listino prezzi Cloudflare Workers AI
- Strands Agents: Introducing Strands Decider 2B (01/10/2026) e relativa model card
- Repository Kev su GitHub e jaredpalmer/kev-9b
- empiriolabsai/aplomb-1 e documentazione ufficiale Aplomb 1 (verificati il 07/10/2026)
- Test hardware diretto: eseguito il 5 ottobre 2026 con scheda RTX 4090, Windows 11, PyTorch 2.11, transformers 5.18 e Ollama.
Ultima verifica: 5 ottobre 2026 (dati Aplomb 1 aggiornati al 7 ottobre 2026).
More on this from NITIDO