Gemini Omni 1.2 Flash: il mio test al lancio con video di 15 secondi
Ho testato Gemini Omni 1.2 Flash nel giorno del lancio: 15 secondi senza stacchi, dialoghi vocali realistici e resa video. Ecco come si comporta davvero.
👁 113 letture
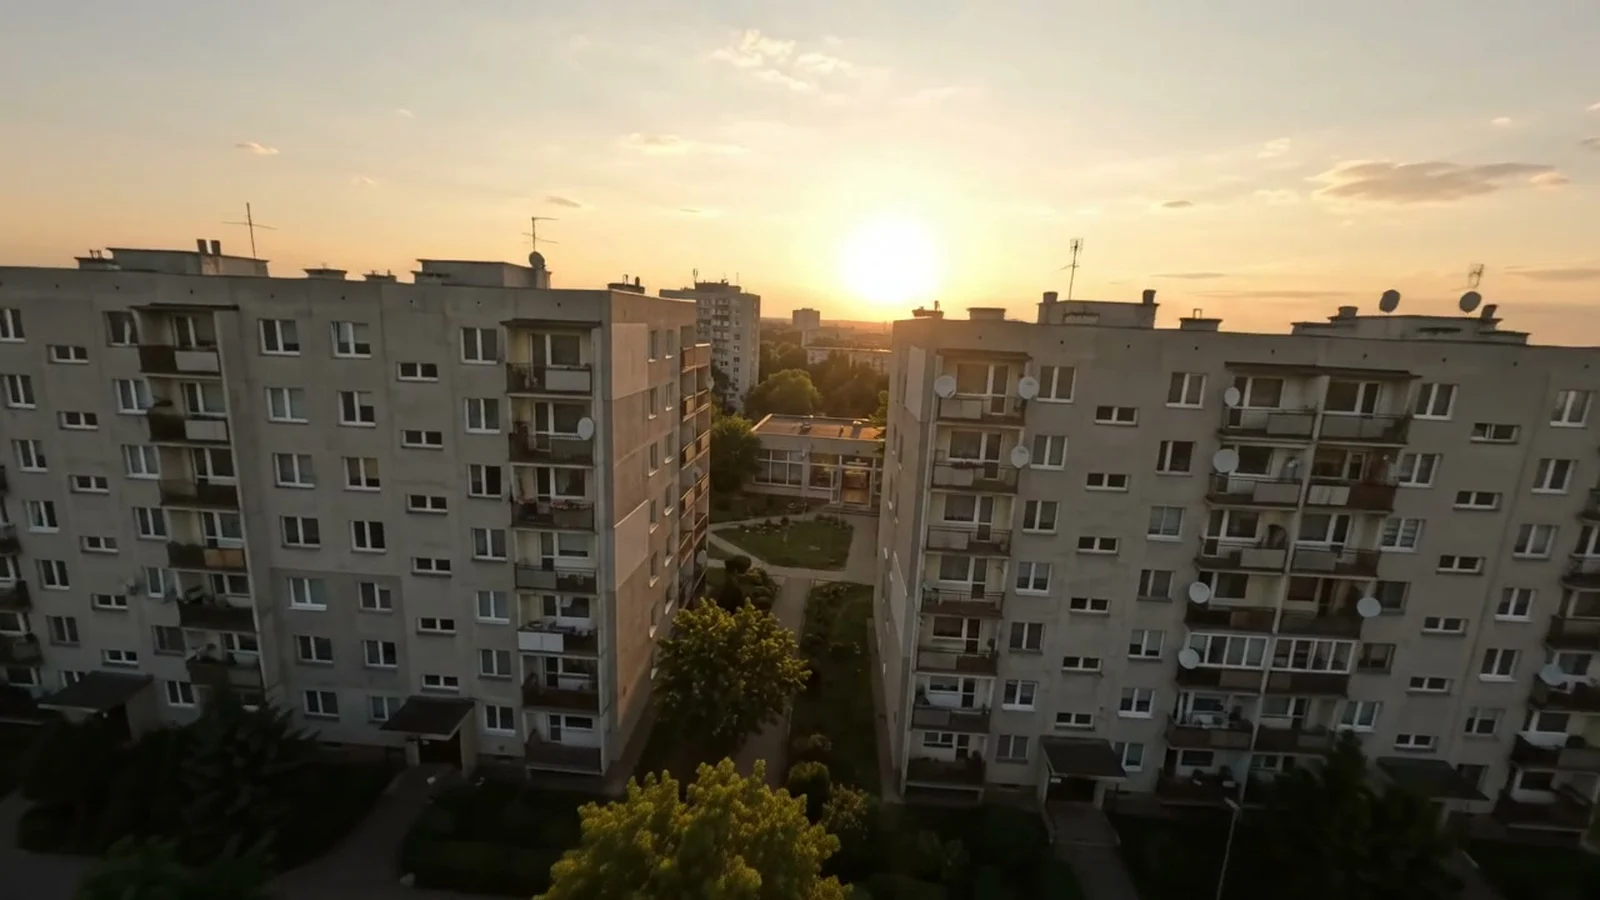
Il primo filmato generato con Gemini Omni 1.2 Flash che mi ha davvero colpito dura 15 secondi e non presenta alcun taglio. Un drone decolla sopra palazzoni prefabbricati al tramonto, scende in picchiata tra gli edifici, supera un battipanni in cortile, entra dalla porta di una tavola calda popolare e si ferma davanti a un anziano seduto con un piatto di zuppa. L’uomo alza lo sguardo e dice “Buongiorno” (traduzione dell’originale polacco) (buongiorno). Quella frase non era nel prompt: il modello ha ritenuto da solo che fosse adatta alla situazione.
Google DeepMind ha rilasciato Omni 1.2 Flash il 5 novembre 2026. Entro sera avevo completato 24 generazioni: nove scene dimostrative, un confronto con cinque concorrenti, la scala di risoluzione da 360p a 4K e alcune prove non riuscite. In totale ho speso circa 11,60 EUR (13,02 USD; tasso BCE del 05/11/2026: 1 EUR = 1,1224 USD, fonte ecb.europa.eu). Questo articolo mostra le potenzialità concrete del modello. I numeri e i benchmark dettagliati si trovano nel nostro speciale su Gemini Omni Flash.
Quindici secondi in un’unica sequenza
Questa è la novità più rilevante della versione 1.2. La release precedente si fermava a 10 secondi, mentre ora puoi impostare la durata con incrementi di un secondo, da 3 a 15. La durata in sé non è l’unico aspetto positivo. I generatori video meno recenti tendono a perdere coerenza nei passaggi prolungati: lo sfondo muta forma, i volti si deformano e l’inquadratura subisce salti improvvisi. In questo piano sequenza il palazzo mantiene la sua geometria fino alla fine, l’interno del locale rimane plausibile e l’uomo al tavolo conserva gli stessi lineamenti dal primo all’ultimo fotogramma in cui compare.
Un dettaglio pratico da considerare: la prima bozza del prompt descriveva bambini che giocavano a pallone sotto il condominio. Il modello ha rifiutato la richiesta senza addebitare costi. Sostituendo i bambini con due anziani su una panchina, il filmato è stato elaborato immediatamente. La documentazione di Google segnala filtri più severi quando si citano minori: se una generazione viene bloccata, la causa è spesso questa.
Dialogo a tre voci
Una cena della vigilia di Natale: zuppa di barbabietole, ravioli, albero decorato. Tre personaggi e tre battute distinte, ciascuna con un timbro vocale differente. La nonna chiede chi abbia mangiato l’ultimo raviolo, il ragazzo con la bocca piena nega e la madre ride facendogli notare che ne ha un pezzo sul mento. Ho verificato la traccia audio tramite riconoscimento vocale: il testo pronunciato corrisponde parola per parola al prompt inserito nel test. L’inquadratura sposta lo sguardo in autonomia verso chi sta parlando.
Google dichiara ufficialmente che solo la lingua inglese è stata testata a fondo, mentre gli altri idiomi non sono stati oggetto di valutazione quantitativa. Nel nostro test con prompt in polacco la resa è stata notevole, sebbene non sempre priva di sbavature.
Spot commerciale in cucina
Un vaso di cetrioli sottaceto su un tavolo di legno, luce mattutina dalla finestra e una mano che svita il coperchio. Queste inquadrature di prodotto rappresentano il tipico caso d’uso dei generatori video economici: crei diverse varianti, scegli la migliore e la inserisci nello spot. Omni ha mantenuto stabile la geometria del barattolo per tutta la clip; aneto e spezie all’interno appaiono realistici e in sottofondo si sente il delicato arpeggio di chitarra specificato nelle istruzioni.
Stile anime sul tram
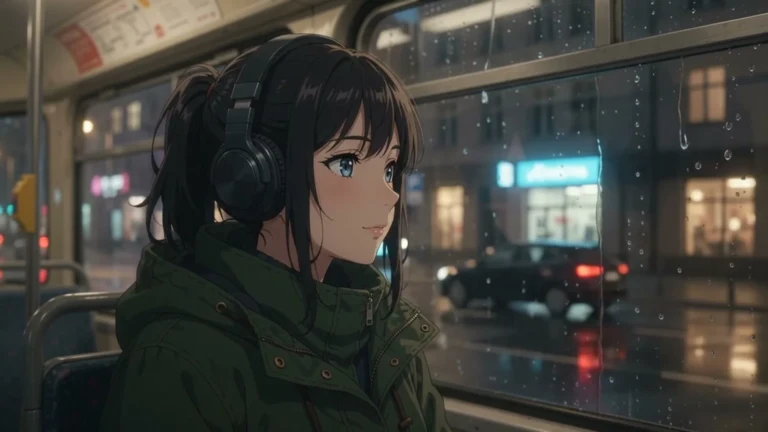
Volevo verificare se il modello fosse limitato al fotorealismo. L’ambientazione richiesta era un tram notturno sotto la pioggia, con una studentessa che ascolta musica in cuffia vicino al vetro appannato. Il risultato ricorda da vicino un lungometraggio d’animazione giapponese: luce soffusa, gocce d’acqua sul finestrino e riflessi sull’asfalto bagnato. La cinepresa passa dall’esterno all’interno del mezzo senza tagli visibili.
Rotazione completa attorno al soggetto
Un mercato rionale in autunno, davanti a un banco di mele. Ho richiesto una rotazione completa della camera attorno alla venditrice, senza stacchi e preservando la scala della figura. Questa continuità è uno dei miglioramenti citati da Google per la versione 1.2: la camera gira attorno alla donna, passa dietro le spalle e torna sul volto. Nel confronto con altri modelli concorrenti, questo movimento orbitale è risultato il più fluido e pulito.
Formato verticale e parlato sincronizzato
Il formato 9:16 viene elaborato con le stesse modalità di quello orizzontale, alla medesima tariffa. Nel test con una ballerina sul tetto di un edificio al tramonto, la ripresa a mano libera gira attorno a lei; alla fine la ragazza si ferma e fissa l’obiettivo, esattamente come indicato nelle istruzioni.
In un altro filmato, un’insegnante di storia davanti alla lavagna parla della battaglia di Grunwald e preannuncia una verifica. Il parlato è stato pronunciato per intero, inclusa la data “millequattrocentodieci” (traduzione dell’originale polacco) (millequattrocentodieci), letta correttamente. Sulla lavagna il modello ha aggiunto spontaneamente con il gesso la scritta “Grunwald 1410”. Curiosamente, chiedendo una conduttrice meteo in uno studio televisivo con una struttura di prompt quasi identica, Omni ha respinto la richiesta due volte di seguito, senza addebiti e senza fornire motivazioni.
I limiti riscontrati durante le prove
Una rassegna priva di criticità sarebbe solo pubblicità. Ecco tre aspetti in cui il modello ha mostrato difficoltà:
- Sport veloci. La stessa Google evidenzia che le azioni rapide rappresentano ancora un punto debole. Nella simulazione di una partita di pallavolo, attacco e muro sono visibili e il pubblico esulta, ma gli atleti presentano numeri sulle maglie, nonostante avessi chiesto esplicitamente di ometterli.
- Cambi di stagione partendo da un’immagine. Fornendo al modello il fotogramma di un orto estivo con la richiesta di ricreare la medesima scena in inverno con la neve, ho ottenuto una replica fedele del fotogramma estivo, senza traccia di fiocchi di neve. La rete neurale è rimasta vincolata all’immagine originale ignorando il testo.
- Modifica interattiva del video. La modifica tramite istruzioni conversazionali è una delle funzioni chiave annunciate, ma nel SEE, in Svizzera e nel Regno Unito sono presenti restrizioni specifiche per l’editing di filmati caricati; tramite l’infrastruttura usata per il test non è stato possibile avviarla (cinque tentativi, cinque errori).
La configurazione del test
Tutti i video sono stati generati via API su OpenRouter utilizzando il modello google/gemini-omni-1.2-flash, con risoluzione 720p, audio attivo e lo stesso seed. I prompt del test sono stati inseriti in lingua polacca per valutarne la tenuta su idiomi non primari. Una clip da 6 secondi ha richiesto tra 45 e 55 secondi di calcolo; per una sequenza da 15 secondi sono stati necessari 81 secondi. I tentativi rifiutati dal sistema non hanno comportato costi di fatturazione.
More on this from NITIDO


 stato dell'ia·Personaggi famosi in GPT-Image-2.6: il modello non rifiuta maiHo testato GPT-Image-2.6 con personaggi storici e viventi. Nessun rifiuto, ma un risultato fotorealistico inaspettato solleva dubbi importanti.