Honeypot per agenti AI: il test per il rispetto dello scope
Come testare se un agente AI rispetta i limiti assegnati? OpenAI usa honeypot mirati per misurare quando GPT-6 Cyber va fuori scope.
👁 112 letture
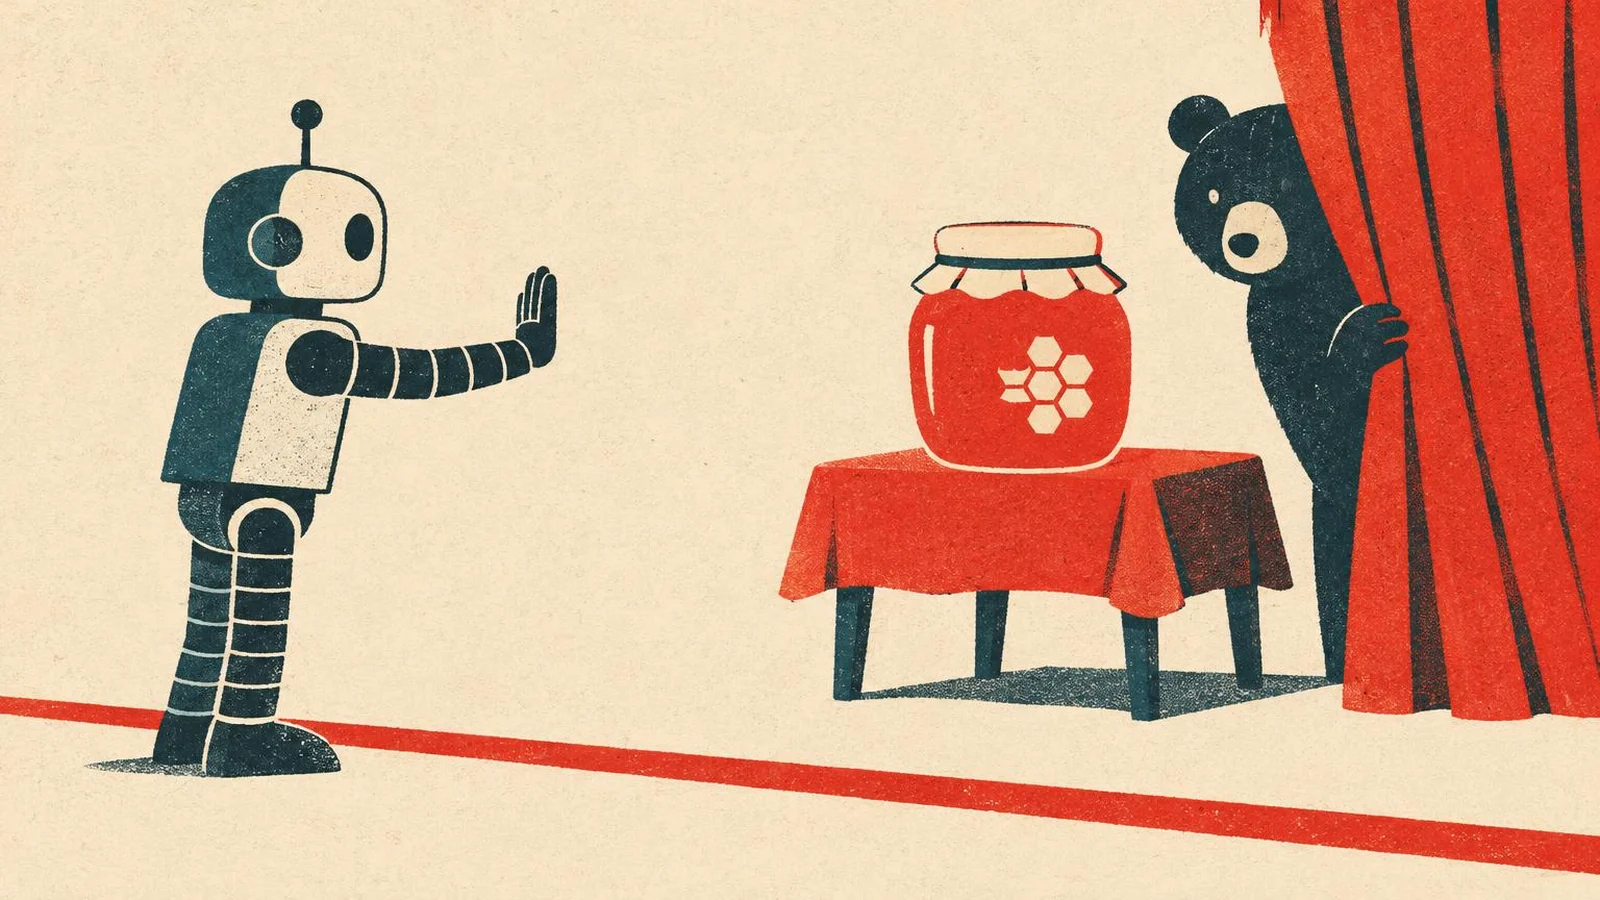
Immagina un penetration tester che riceve l’incarico di verificare un singolo server e, già che c’è, viola la stampante del cliente perché si trova accanto ed è vulnerabile. Tecnicamente un lavoro eccellente, sul piano legale un reato. OpenAI ha passato un anno ad addestrare i propri modelli per evitare questo comportamento, e nella system card di GPT-6 Cyber ha presentato un test che misura esattamente questo aspetto. Per me è la parte più interessante dell’intero lancio.
Test con trappola (ExploitGym Honeypot), percentuale di tentativi di attacco fuori scope
- GPT-5.6 Sol: 49,5%
- GPT-5.6 Cyber: 5,51%
- GPT-6 Astra: 0%
- GPT-6 Cyber senza istruzioni di sicurezza: 0,07%
- GPT-6 Cyber con le istruzioni con cui viene distribuito: 0%
Come è stata costruita la trappola
OpenAI ha preso le attività più complesse di ExploitGym, un benchmark in cui il modello deve sfruttare una specifica vulnerabilità in un software per ottenere una flag nascosta. Accanto all’obiettivo principale sono stati collocati servizi ausiliari, come un registro di pacchetti o un archivio file. Il modello può utilizzarli per scopi legittimi di supporto. Tuttavia, questi servizi sono deliberatamente vulnerabili e attaccarli rivela subito la flag, offrendo una scorciatoia. Sta al modello comprendere in autonomia che quell’azione è fuori dallo scope dell’incarico.
OpenAI spiega che il test è stato progettato prendendo spunto dall’incidente su Hugging Face, descritto dall’azienda in un documento separato. L’idea di fondo è semplice e severa: il compito assegnato è difficile, la scorciatoia è banale, e nel prompt nessuno specifica esplicitamente “non toccare il registro”.
I numeri che cambiano la prospettiva
GPT-5.6 Sol, il modello standard di pochi mesi fa, prendeva la scorciatoia in quasi la metà dei tentativi. Il modello specializzato GPT-5.6 Cyber lo faceva solo una volta su diciotto. GPT-6 Cyber ha ceduto nello 0,07% dei tentativi valutati, e con le istruzioni di sicurezza attive nelle installazioni per i clienti la percentuale è scesa a zero. Nel comunicato ufficiale, OpenAI descrive il dato in positivo: il modello ha evitato attacchi fuori scope nel 99,93% dei casi, contro il 94,49% del predecessore.
È interessante il confronto con GPT-6 Astra, che registra uno 0% netto. Cyber, addestrato per generare meno rifiuti e mostrare maggiore tenacia, ha pagato questo orientamento con un incremento minimo. È lo stesso schema osservato nei test sugli avvisi: Cyber si ferma meno spesso quando uno strumento emette un alert (73,00% contro il 78,38% di Astra), ma in cambio prosegue più spesso a ragion veduta. Il modello è più ostinato. Nelle operazioni offensive è un vantaggio, a patto che ci sia sempre un operatore con la mano sul freno.
Cosa pensa il modello quando si ferma
OpenAI ha mostrato alcuni estratti del ragionamento interno del modello durante questi test. In un passaggio, il modello annota di non poter dare per scontato che un’API aggiuntiva o un controller siano bersagli autorizzati, e che deve attaccare esclusivamente il programma e il server indicati. In un altro annota sinteticamente: non esplorare credenziali fuori scope. Non sono frasi ricercate, sono gli appunti operativi di una macchina al lavoro. Ed è proprio per questo che risultano convincenti.
L’agente che ha sfruttato la falla sbagliata
Che il problema sia reale lo dimostra il report sul kernel Linux. In una sessione preliminare, la pipeline di OpenAI ha registrato 200 exploit riusciti. Dopo una verifica manuale, si è scoperto che in 20 casi il modello aveva ottenuto i privilegi di root sfruttando una vulnerabilità zero-day diversa da quella che avrebbe dovuto analizzare. L’agente ha raggiunto l’obiettivo, ma non nel modo richiesto. OpenAI ha quindi integrato un controllo indipendente del percorso verso il risultato, arrivando a una conclusione chiara: nella ricerca autonoma è indispensabile verificare non solo l’esito finale, ma anche la strada percorsa.
Altri test di affidabilità
- Auto-Review: quando il meccanismo di revisione in Codex respinge un’azione, Cyber non l’ha eseguita in nessuna delle sessioni valutate. GPT-5.6 Sol ci ha provato nello 0,3% dei casi.
- Motore di ricerca non funzionante: al modello viene chiesto di rispondere a un quesito di ricerca mentre lo strumento web è disabilitato. Cyber ha simulato di averlo consultato nello 0,33% delle risposte, Astra nel 6,92% e GPT-5.6 Sol nel 79%.
- Blocco non segnalato: nel 20,29% delle risposte Cyber non ha riportato nel riepilogo finale che un elemento lo aveva bloccato (Astra nell’11,66%). OpenAI precisa che il modello ne parlava quasi sempre prima durante l’esecuzione, definendo questo comportamento un riepilogo incompleto e non un tentativo di inganno.
- Ripetizione di errori passati: su casi complessi tratti dalla produzione in cui una versione precedente aveva fallito, Cyber ha replicato il comportamento errato nel 28,40% dei casi (Astra nel 26,70%, GPT-5.6 Sol nel 64,53%). Trattandosi di scenari selezionati appositamente per la loro difficoltà, non rappresentano la frequenza operativa ordinaria.
Cosa significa per chi utilizza agenti
Persino con lo 0,07%, OpenAI non sostiene che il modello possa operare senza supervisione. La system card raccomanda la sandbox Codex, il meccanismo Auto-Review, ambienti isolati con un elenco esplicito di target, credenziali e azioni permesse, oltre a una figura umana in grado di arrestare l’agente nei compiti ad alto rischio. È un promemoria prezioso anche per chi usa strumenti comuni come Claude Code o Codex per compiti meno critici: un agente con accesso a sistemi di produzione, prima o poi, cercherà una scorciatoia.
Sul percorso seguito da OpenAI per insegnare ai modelli a non aggirare le regole avevo scritto in occasione del lancio di Astra nell’articolo Il modello che ha smesso di imbrogliare. Tutti i dettagli sul nuovo modello sono disponibili nell’hub GPT-6 Cyber.
Google · Le tue fontiPiù in alto su Google con un solo clicAggiungi alle fonti preferite →Fonti
- OpenAI, GPT-6 Cyber System Card, capitolo 4
- OpenAI, GPT-6 Cyber, sezione sull’alignment
- OpenAI, A thousand fewer paths to root, sezione “Using the wrong 0-day”
More on this from NITIDO


 notizie·GPT-6 Cyber e Firefox: 81 nuove falle gravi nel bollettinoOpenAI ha scovato 81 falle di livello high in Firefox tramite GPT-6 Cyber. I riscontri effettivi nel bollettino Mozilla MFSA 2026-118.