Decision Index di Artificial Analysis: Jev 1.13 in testa
Artificial Analysis lancia il Decision Index v1.0: Jev 1.13 guida la classifica dei modelli decisionali AI, più veloci ed economici dei classici LLM.
👁 114 letture
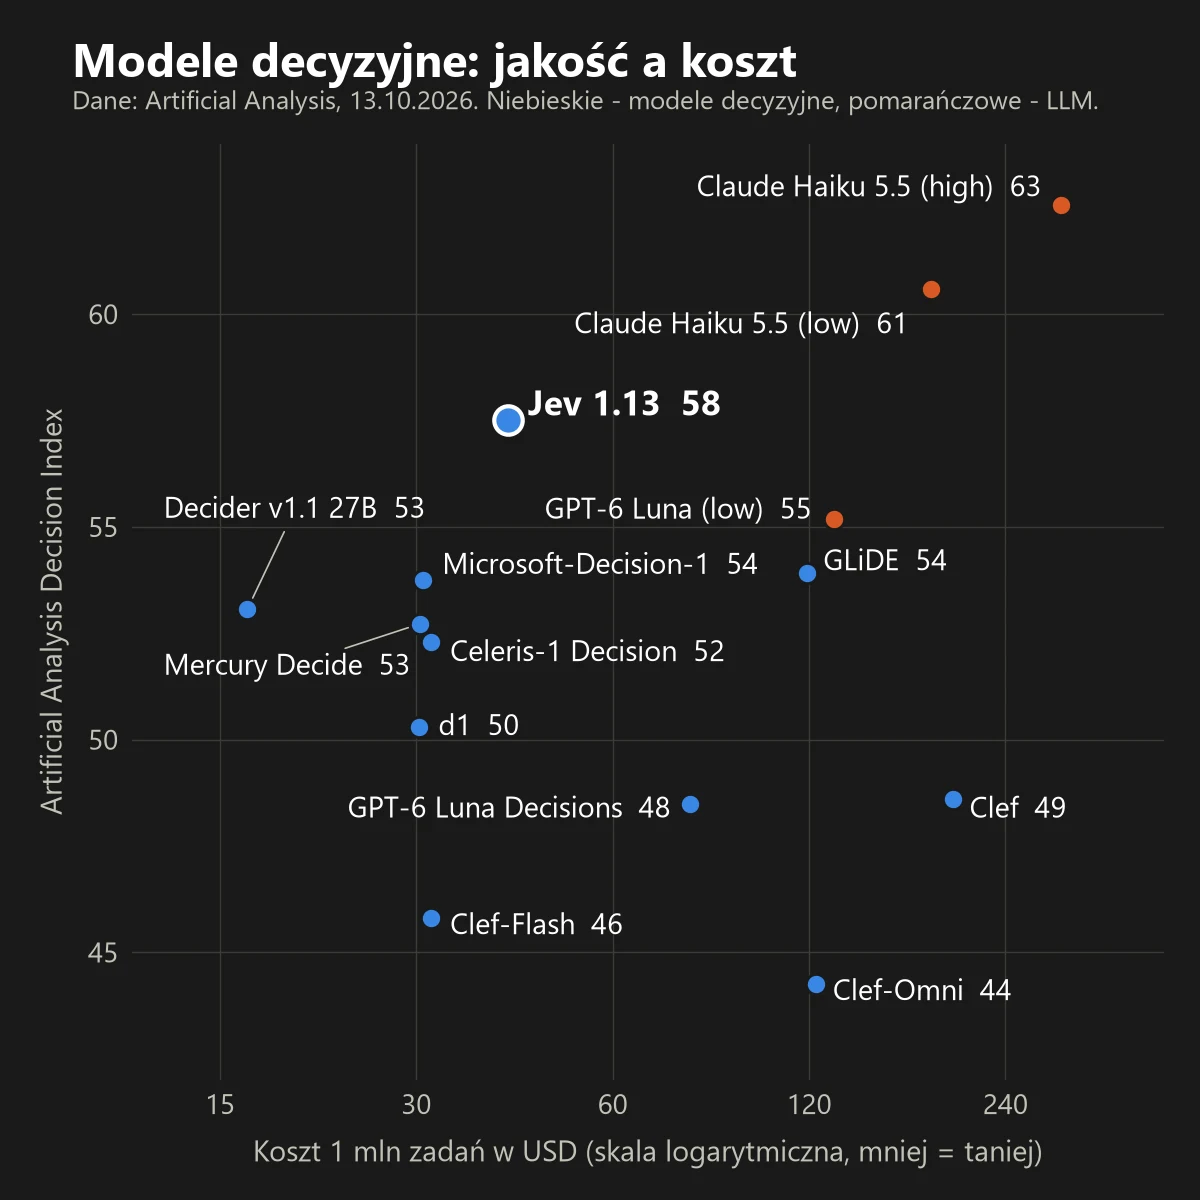
Il 13 ottobre 2026 Artificial Analysis ha pubblicato il Decision Index v1.0, la prima classifica indipendente di modelli decisionali: sistemi AI progettati non per generare testo aperto, ma per selezionare una risposta da un elenco chiuso fornendo la probabilità di ciascuna opzione. Al primo posto si posiziona Jev 1.13 di TypeSafe con un punteggio di 58, davanti a GLiDE (Fastino) e Microsoft-Decision-1 (entrambi a quota 54). Il più economico risulta Decider v1.1 27B di Perplexity: circa 15,19 EUR (17 USD) per milione di richieste. Claude Haiku 5.5 tradizionale ottiene un punteggio complessivo più alto (61), ma stando alle misurazioni di AA è 11 volte più lento e 4,4 volte più costoso del modello di testa. (I valori in EUR sono stime calcolate secondo il tasso di riferimento BCE del 13.10.2026: 1 EUR = 1,1188 USD, fonte: ecb.europa.eu).
I numeri chiave (Artificial Analysis, 13.10.2026)
- 11 modelli decisionali nell’indice complessivo, 9 inclusi nell’analisi iniziale.
- Leader: Jev 1.13 (TypeSafe) - 58 punti, circa 37,54 EUR (42 USD) per milione di compiti, latenza di 0,13 s.
- Costo per milione di compiti: da circa 15,19 EUR (17 USD, Decider v1.1 27B) a circa 177,87 EUR (199 USD, Cloudflare Clef).
- Tempo di risposta per compito: da 0,06 s (Celeris-1 Decision) a 0,5 s (Mercury Decide).
- Claude Haiku 5.5 (low): 61 punti, circa 164,46 EUR (184 USD) per milione di compiti, 1,4 s di latenza.
Nota di trasparenza: conosco il modello Jev da una precedente ricognizione tecnica, avendo sviluppato a settembre un client API elementare per strumenti editoriali interni. TypeSafe non ha commissionato né retribuito questo articolo; la posizione di Jev è riportata esclusivamente in base ai test indipendenti di Artificial Analysis.
Che cos’è un modello decisionale
Un modello decisionale riceve due elementi in ingresso: uno stato (ad esempio il testo del ticket di un cliente) e una serie di domande con risposte prefissate. Invece di redigere frasi, calcola e restituisce la distribuzione di probabilità per ciascuna opzione consentita. Artificial Analysis illustra il meccanismo simulando una richiesta utente (tradotta dall’originale polacco del test: «i prelievi sono bloccati da 3 giorni e domani devo pagare l’affitto») sottoposta a tre verifiche simultanee:
- reparto di destinazione: pagamenti, supporto tecnico oppure gestione account (selezione da elenco),
- urgenza: sì oppure no,
- livello di irritazione del cliente: calmo, frustrato, arrabbiato (scala di valori).
Il modello decisionale risolve tutti e tre i quesiti con una singola chiamata API e produce la rispettiva distribuzione di probabilità. Un LLM standard dovrebbe invece generare una stringa JSON da sottoporre a parsing, senza offrire una misura calibrata della propria confidenza statistica. Ho approfondito questo approccio nella guida sui modelli decisionali AI, documentando un test originariamente svolto su ticket in lingua polacca.
Classifica: Artificial Analysis Decision Index v1.0
| Modello (azienda) | Indice | Costo 1 mln compiti | Tempo per compito |
|---|---|---|---|
| Jev 1.13 (TypeSafe) | 58 | circa 37,54 EUR (42 USD) | 0,13 s |
| GLiDE (Fastino Labs) | 54 | circa 106,36 EUR (119 USD) | 0,22 s |
| Microsoft-Decision-1 (Microsoft) | 54 | circa 27,71 EUR (31 USD) | 0,21 s |
| Decider v1.1 27B (Perplexity) | 53 | circa 15,19 EUR (17 USD) | 0,17 s |
| Mercury Decide (Inception) | 53 | circa 26,81 EUR (30 USD) | 0,50 s |
| Celeris-1 Decision (Celeris) | 52 | circa 28,60 EUR (32 USD) | 0,06 s |
| d1 (Liquid AI) | 50 | circa 26,81 EUR (30 USD) | 0,30 s |
| Clef (Cloudflare) | 49 | circa 177,87 EUR (199 USD) | 0,31 s |
| GPT-6 Luna Decisions (OpenAI) | 48 | circa 70,61 EUR (79 USD) | 0,17 s |
| Clef-Flash (Cloudflare) | 46 | circa 28,60 EUR (32 USD) | 0,30 s |
| Clef-Omni (Cloudflare) | 44 | circa 109,94 EUR (123 USD) | 0,17 s |
A titolo comparativo, i modelli linguistici convenzionali testati sul medesimo benchmark mostrano: Claude Haiku 5.5 (low) a 61 punti con circa 164,46 EUR (184 USD) e 1,4 s; GPT-6 Luna (low) a 55 punti con circa 117,09 EUR (131 USD) e 1,5 s. I tempi riflettono la mediana per operazione; il costo rappresenta la spesa media calcolata sulle tariffe token vigenti, proiettata su un milione di elaborazioni. I modelli decisionali fatturano esclusivamente i token di input, mentre i modelli generativi addebitano input e output.
Come viene calcolato l’indice
Il Decision Index è una media ponderata di quattro benchmark distinti, ciascuno con un peso del 25%:
- AA-Omniscience-Decision (conoscenza e allucinazioni): 500 quesiti riservati con cinque opzioni (quattro risposte e l’opzione «non so»). Il punteggio assegna metà peso all’accuratezza e metà alla frequenza con cui il modello indica «non so» anziché tirare a indovinare.
- HLE-MultiChoice (ragionamento logico): 513 domande a risposta multipla estratte da Humanity’s Last Exam, uno dei dataset più complessi per l’AI.
- When2Call (uso degli strumenti): suite curata da NVIDIA in cui il modello analizza una conversazione e un set di tool disponibili per stabilire se rispondere in autonomia, richiamare un’integrazione esterna, richiedere parametri mancanti o dichiararsi impossibilitato a procedere.
- WildGuardTest (classificazione e sicurezza): benchmark di Ai2 mirato a identificare prompt malevoli, analizzare se l’output dell’assistente costituisce un rifiuto e quantificare l’eventuale nocività del testo.
Cosa rivelano le rilevazioni
- Jev prevale nel ragionamento: raggiunge 21 punti su HLE-MultiChoice, laddove nessun altro modello specializzato supera quota 15. Nei compiti di pura conoscenza enciclopedica si ferma tuttavia al 35% di accuratezza (il vertice appartiene a d1 di Liquid AI con il 41%).
- Capacità di riconoscere i propri limiti: Microsoft-Decision-1 sceglie «non so» nel 40% delle situazioni critiche (Jev al 35%, Mercury Decide al 32%, i restanti sotto il 17%). Al contrario, d1 registra un’ottima accuratezza informativa ma non ammette quasi mai l’incertezza (punteggio pari a 2).
- Tool calling superiore ai modelli generativi: su When2Call, Celeris-1 Decision e GLiDE toccano 84 punti, superando Claude Haiku 5.5 low (73) e GPT-6 Luna low (77).
- Efficacia nella moderazione: in WildGuardTest, GLiDE raggiunge 95 punti, seguito da Jev e Decider a 94, mentre Claude Haiku 5.5 (low) si attesta a 93 e GPT-6 Luna (low) a 89.
- Tendenza all’eccesso di confidenza: incrociando le probabilità dichiarate con la reale correttezza, emerge che nei quesiti di logica e cultura generale i modelli stimano una sicurezza statistica superiore ai risultati concreti. L’allineamento probabilistico risulta invece solido nella classificazione e nella scelta dei tool.
I motivi del vantaggio economico
Non dovendo comporre frasi, il motore di un modello decisionale legge il contesto in ingresso una volta sola, determina la distribuzione probabilistica su tutte le voci assegnate e chiude l’elaborazione. Questo schema introduce tre vantaggi strutturali:
- Fatturazione sul solo input: totale azzeramento dei costi per token generati o passaggi intermedi di reasoning.
- Valutazioni multiple in una sola richiesta: nessuna necessità di attendere la scrittura sequenziale dei campi di una struttura JSON.
- Tempi di risposta misurati in millisecondi: intervalli tipici di 0,06-0,5 s per richiesta contro gli 1,4-1,5 s misurati sui piccoli LLM generativi impostati a bassa latenza.
Il risparmio cresce rapidamente su larga scala. Nelle prove su WildGuardTest, Artificial Analysis ha registrato un costo per milione di esecuzioni di circa 10,82 EUR (12,1 USD) con Decider e circa 20,38 EUR (22,8 USD) con Jev, contro circa 81,78 EUR (91,5 USD) necessari utilizzando Claude Haiku 5.5 (low).
Quando adottare un modello decisionale
L’integrazione è consigliata se l’output richiesto appartiene a un insieme discreto di possibilità e i volumi operativi sono elevati:
- instradamento automatico di comunicazioni, email o documenti,
- filtri di moderazione, policy check e intercettazione di prompt dannosi,
- scelta dell’azione ottimale all’interno di architetture ad agenti («eseguire l’API o chiedere dettagli»),
- sistemi di supervisione per approvare una bozza, inviarla a correzione o passarla a un operatore umano.
Il loro impiego è invece sconsigliato quando il processo richiede sintesi espositive o vasta conoscenza generale. Nelle prove enciclopediche Claude Haiku 5.5 (low) registra il 52% di precisione e GPT-6 Luna (low) il 66%, contro la fascia 28-41% dei motori decisionali. Un modello decisionale, inoltre, non redige messaggi indirizzati all’utente finale: la generazione conversazionale resta appannaggio dei classici LLM.
Prospettive
Artificial Analysis aggiorna la classifica in tempo reale integrando progressivamente nuove soluzioni commerciali. L’analisi dettagliata sui quattro test, le tariffe API complete e i riscontri dei test empirici (inizialmente svolti su testi polacchi) sono raccolti nella nostra guida dedicata ai modelli decisionali AI. In precedenza abbiamo analizzato nel dettaglio Jev di TypeSafe, Cloudflare Clef e Strands Decider 2B di AWS.
Google · Le tue fontiPiù in alto su Google con un solo clicAggiungi alle fonti preferite →Fonti
- Artificial Analysis: Artificial Analysis Decision Index v1.0 (13.10.2026)
- Artificial Analysis: Decision Index - benchmark live (dati estratti il 13.10.2026)
- Artificial Analysis: metodologia Decision Index
- Artificial Analysis su X (comunicato del 13.10.2026)
More on this from NITIDO

 magazine·Caso Thélyson Orélien: ho testato il romanzo con tre rilevatori di IA. Stesso paragrafo: 100%, 85% e 0%Il caso Orélien in breve e il mio test degli estratti del romanzo con Pangram, AUTHORRA e ZeroGPT, con Zola e un testo IA come controllo.