World model AI: cosa sono e come funzionano Genie, Odyssey e Cosmos
I world model non creano solo video: simulano mondi interattivi in tempo reale. Ecco come funzionano Genie 3, Odyssey-3, Cosmos e V-JEPA e cosa possono fare.
👁 113 letture
Un world model (modello del mondo) e un’intelligenza artificiale che non si limita a scrivere testo o a montare un filmato statico, ma calcola come cambia l’ambiente a ogni tua mossa. In questo modo puoi esplorare un mondo generato in tempo reale proprio come in un videogioco, mentre un robot puo simulare un compito prima di eseguirlo nella realta. In questa guida abbiamo raccolto i modelli piu importanti - Genie, Odyssey, Cosmos, V-JEPA e Atlas - analizzando cosa e accessibile, quanto costa e cosa abbiamo riscontrato nei nostri test.
Situazione al 9 ottobre 2026
- Il piu recente: Odyssey-3 (8/10/2026) - demo gratuita via browser, senza registrazione, accessibile subito online.
- Il piu discusso: Genie 3 di Google DeepMind, disponibile come Project Genie all’interno del piano Google AI Ultra.
- A pesi aperti: NVIDIA Cosmos e Meta V-JEPA 2 - scaricabili ed eseguibili sul proprio hardware.
- Il nostro test: ambienti naturali e urbani messi alla prova su Odyssey-3 - i dettagli piu in basso.
Cos’e un world model
Un grande modello linguistico prevede la parola successiva. Un world model prevede lo stato successivo del mondo: il fotogramma seguente, la posizione degli oggetti, il movimento della telecamera. L’elemento cruciale e l’input di controllo. Il modello riceve un comando come “il giocatore avanza” o “il braccio robotico chiude la pinza” e deve mostrare visivamente cosa accade subito dopo.
Le differenze sostanziali rispetto a un generatore video tradizionale come Veo:
- un generatore video calcola l’intera clip in blocco e tu puoi solo guardare il risultato finito;
- un world model calcola le immagini fotogramma per fotogramma, in tempo reale, reagendo direttamente ai tuoi comandi;
- un world model deve ricordare cio che ha gia mostrato: se ti volti di 180 gradi e poi torni indietro, un edificio deve restare identico e nella stessa posizione (questo rimane ancora il limite piu critico).
Per approfondire le ragioni per cui la ricerca considera i world model il passaggio fondamentale dopo gli LLM, rimandiamo alla nostra analisi sui world model e l’AI che comprende la fisica.
Come funziona sotto il cofano
La maggior parte dei world model odierni dedicati alla generazione visiva segue un’architettura comune:
- Addestramento su video: il modello elabora milioni di ore di riprese, spesso tratte da videogiochi e dashcam automobilistiche, associate ai segnali di input corrispondenti (tasti premuti, sterzate, comandi meccanici).
- Previsione sequenziale: basandosi sugli ultimi frame visti e sui comandi ricevuti, il sistema predice il fotogramma successivo. Si tratta di un approccio autoregressivo analogo a quello dei modelli linguistici, ma applicato alle immagini.
- Diffusione: ogni nuovo fotogramma nasce da un processo di denoising, simile a quello dei modelli di generazione di immagini. Per garantire prestazioni in tempo reale, i ricercatori applicano tecniche di distillazione che riducono il rendering a pochissimi passaggi.
- Finestra di memoria: il modello mantiene una visione ristretta degli eventi recenti. Quando un dettaglio esce da questa finestra temporale, l’AI e costretta a reinterpretarlo da zero: ecco perche le strutture architettoniche spesso mutano dopo una rotazione della visuale.
V-JEPA adotta invece una strategia diversa: al posto dei pixel genera una rappresentazione dello stato del mondo all’interno di uno spazio concettuale astratto. Non permette una navigazione visiva in prima persona, ma consuma molte meno risorse computazionali ed e nettamente piu efficace per la pianificazione delle traiettorie robotiche.
I limiti di cui i produttori parlano poco
- Coerenza e persistenza degli oggetti: ruotando la visuale, l’ambiente circostante tende a modificarsi in modo anomalo. Nel nostro test su Odyssey-3 questo comportamento e emerso gia dopo appena 10 secondi.
- Durata delle sessioni: le anteprime gratuite consentono sessioni di pochi minuti, e secondo le specifiche fornite da Google anche Genie 3 mantiene la stabilita per intervalli di tempo piuttosto limitati.
- Risoluzione contenuta: la maggior parte dei modelli opera tra 480p e 720p, ben al di sotto degli standard 4K dei generatori video offline.
- Lacune sui dettagli locali: i modelli padroneggiano il concetto generico di “citta europea”, ma faticano a riprodurre monumenti o specificita regionali meno diffusi nei dataset globali.
- Benchmark interni: le misurazioni indipendenti sono ancora rare e ciascun laboratorio tende a pubblicare esclusivamente i test in cui la propria architettura primeggia.
A cosa servono davvero
- Robotica e guida autonoma: simulazioni intensive che sostituiscono migliaia di ore di test fisici e riducono l’usura dell’hardware reale. E il settore di riferimento principale per NVIDIA e Odyssey.
- Agenti AI autonomi: ambienti infiniti e controllabili in cui addestrare comportamenti complessi, sia nel software che nei videogiochi.
- Videogiochi e previsualizzazione cinematografica: generazione rapida di concept ambientali, illuminazione di scena e prototipi di livelli interattivi.
- Ricerca scientifica: quantificare la comprensione delle regole fisiche da parte delle reti neurali attraverso benchmark dedicati come Physics-IQ.
I principali world model a ottobre 2026
| Modello | Azienda | Cosa fa | Disponibilita | Pesi |
|---|---|---|---|---|
| Odyssey-3 / Pro | Odyssey | mondo interattivo in tempo reale da prompt, 832×480 / 1280×720, visuale in prima e terza persona | si, anteprima gratuita senza account; API su richiesta | no |
| Genie 3 (Project Genie) | Google DeepMind | mondo esplorabile da testo o immagine, 720p a 24 fps | incluso nel piano Google AI Ultra (per utenti maggiorenni) | no |
| Cosmos (inclusi Cosmos 3 e Cosmos 3 Edge) | NVIDIA | world model per robotica e veicoli autonomi, generazione di dati sintetici per il training | si, liberamente scaricabile | si (licenza NVIDIA) |
| V-JEPA 2 | Meta | analisi e previsione video in spazio latente senza rendering pixel; pianificazione robotica | si, liberamente scaricabile | si |
| Atlas e Marble | World Labs | scene 3D e video generati da singola immagine, esportazione in 3D Gaussian splat | Marble via browser; Atlas annunciato | no |
Genie 3 e Project Genie
Genie 3 e il modello svelato da Google DeepMind nell’agosto 2025. Genera ambienti interamente navigabili a una risoluzione di 720p e 24 fotogrammi al secondo. Nel gennaio 2026 Google ne ha avviato il rollout sperimentale all’interno di Labs con il nome di Project Genie, inizialmente riservato agli abbonati a Google AI Ultra negli Stati Uniti. A partire da maggio 2026 l’accesso e stato esteso agli abbonati Ultra di altri paesi, pur senza una lista ufficiale completa. Project Genie combina l’infrastruttura di Genie 3 con Nano Banana e Gemini. Per un quadro piu ampio su questa sfida tecnica, puoi leggere il nostro approfondimento sui world model come nuova frontiera dell’AI dopo gli LLM.
Odyssey-3
L’azienda californiana Odyssey, con sede a Palo Alto, ha rilasciato Odyssey-3 l’8 ottobre 2026. L’architettura e basata su un transformer a diffusione autoregressivo: il modello pulisce dal rumore i frame successivi tenendo conto di quelli passati e degli input dell’utente. Grazie a un’ottimizzazione mirata, il processo richiede pochissimi passaggi per fotogramma, consentendo un’interazione fluida in tempo reale. Lo stesso motore e progettato per la simulazione di robot, veicoli a guida autonoma, droni e per l’addestramento di agenti virtuali. La disamina tecnica completa e disponibile nel nostro articolo su Odyssey-3 e i test sul campo.
NVIDIA Cosmos
Cosmos e la suite open source di NVIDIA pensata per la cosiddetta Physical AI. Il suo impiego primario risiede nella generazione di dati sintetici realistici per accelerare l’apprendimento di veicoli e robot. La variante Edge e ottimizzata specificamente per girare in locale sui dispositivi periferici senza dipendere dal cloud. Abbiamo dettagliato la configurazione pratica nella guida su come iniziare con NVIDIA Cosmos 3 e coperto le novita dell’architettura on-device nel report su Cosmos 3 Edge.
V-JEPA 2 e Yann LeCun
Presentato da Meta nel giugno 2025, V-JEPA 2 segue una filosofia radicalmente alternativa: non calcola i singoli pixel a schermo, ma anticipa gli eventi futuri operando in uno spazio di concetti astratti. Questo approccio e sostenuto con forza da Yann LeCun, convinto che il rendering di ogni pixel sia uno spreco di potenza computazionale non necessario per la vera comprensione spaziale. I pesi sono completamente aperti. Dopo la separazione da Meta, LeCun prosegue lo sviluppo di questi principi con la sua nuova realta aziendale, vicenda che abbiamo approfondito nel focus su Yann LeCun e la visione di AMI Labs.
World Labs: Marble e Atlas
La startup fondata da Fei-Fei Li si concentra sull’intelligenza spaziale. La piattaforma Marble genera ambienti 3D tridimensionali, mentre Atlas, annunciato il 1 settembre 2026, produce a partire da un singolo scatto fino a un minuto di video in risoluzione 1440p, garantendo un controllo millimetrico della telecamera e l’esportazione verso nuvole di punti. Trovi i dettagli nell’articolo dedicato al lancio di Atlas da parte di World Labs.
I risultati nel benchmark di fisica Physics-IQ
Physics-IQ misura la capacita di un’AI di prevedere l’evoluzione temporale di una scena rispettando le leggi della fisica classica: caduta dei gravi, dinamica degli urti e comportamento dei fluidi. Di seguito riportiamo i dati ufficiali condivisi da Odyssey in occasione del lancio. Poiche gli altri laboratori tendono a testare configurazioni differenti, abbiamo evitato aggregazioni fuorvianti.
Il nostro test: luoghi specifici su Odyssey-3
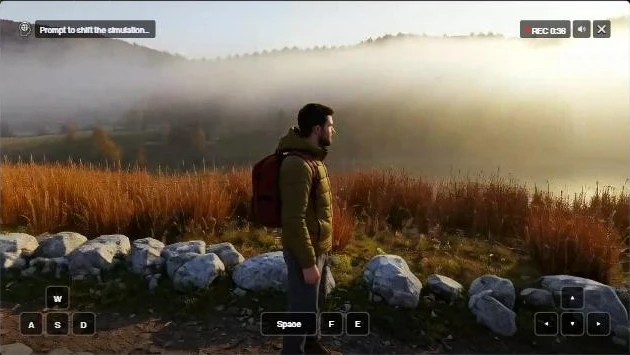
Odyssey-3 e l’unico world model di grandi dimensioni che al 9 ottobre 2026 abbiamo potuto avviare senza dover creare un account e senza costi. Abbiamo testato tre scenari descrittivi specifici (inclusi prompt in polacco per verificare la tenuta linguistica su riferimenti esteuropei): una vallata montuosa nei Bieszczady in inglese, la medesima richiesta scritta in polacco e il centro storico di Cracovia (Rynek Glowny) coperto dalla neve.
| Parametro testato | Esito riscontrato |
|---|---|
| Comprensione del prompt multilingue (testato in polacco) | interpretato correttamente |
| Resa dell’atmosfera (nebbia, vegetazione, colline) | buona |
| Monumenti e architetture regionali specifiche | non riconosciuti: generici edifici in stile europeo |
| Fluidita nei movimenti e nella rotazione della visuale | buona |
| Coerenza dello spazio dopo una rotazione | insufficiente: la geometria degli edifici si e deformata |
Il verdetto: il modello restituisce egregiamente toni, luci e resa atmosferica, ma non possiede conoscenze geografiche o architettoniche puntuali e perde coerenza geometrica non appena ci si volta. Funziona molto bene per generare rapidamente ambientazioni d’atmosfera, ma non puo essere impiegato per simulazioni realistiche di luoghi precisi.
Come iniziare: tre strade
- Gratis e immediato: vai su experience.odyssey.systems, inserisci la descrizione dell’ambiente desiderato e muoviti liberamente usando i tasti WASD e le frecce direzionali.
- Tramite abbonamento Google: Project Genie e integrato nel piano Google AI Ultra; puoi controllare la disponibilita direttamente nella sezione Labs del tuo profilo.
- In locale sul tuo computer: scaricando NVIDIA Cosmos o Meta V-JEPA 2 da Hugging Face. Richiede una GPU NVIDIA dalle prestazioni elevate e familiarita con Python.
World model e giochi generati dall’AI
Spesso si tende a confondere i world model con i generatori procedurali di videogiochi. Sistemi come Google Labs Playground creano un titolo vero e proprio dotato di meccaniche di gioco, punteggi e condizioni di vittoria o sconfitta. Un world model, al contrario, calcola esclusivamente lo spazio volumetrico in cui muoversi, privo di logiche di gioco prefissate. Playground e al momento accessibile soltanto negli Stati Uniti - maggiori dettagli nella nostra guida su come funziona Google Playground.
Domande frequenti
In cosa differisce un world model da un generatore video?
Un generatore video sintetizza un filmato a durata fissa senza alcuna interazione. Un world model calcola i fotogrammi dinamicamente in tempo reale reagendo alle tue azioni e cercando di preservare la continuita visiva degli elementi gia generati.
Esistono world model gratuiti?
Si. Odyssey-3 offre un’anteprima gratuita direttamente nel browser senza registrazione, mentre NVIDIA Cosmos e Meta V-JEPA 2 mettono a disposizione i propri pesi come software open source.
Genie 3 e utilizzabile in Europa?
Project Genie e legato alla sottoscrizione a Google AI Ultra. Google non ha ancora pubblicato un elenco formale di tutte le aree geografiche coperte, per cui e necessario verificarne l’attivazione sul proprio account Google Labs.
I world model comprendono davvero la fisica?
Solo in parte. I punteggi piu elevati registrati nel benchmark Physics-IQ toccano circa 66 punti su 100, un risultato ancora distante dalla perfezione. Nelle nostre prove, le dinamiche di base (propagazione della nebbia, illuminazione, camminata) sono comunque apparse credibili.
Posso eseguire un world model sul mio PC di casa?
Piattaforme come Cosmos e V-JEPA 2 possono girare in locale a patto di disporre di una scheda grafica NVIDIA molto potente. Sistemi come Odyssey-3 e Genie 3 funzionano invece esclusivamente in cloud sui server delle rispettive aziende.
A cosa puo servire questa tecnologia a un creator?
Risulta utile per creare rapidamente bozzetti concettuali di ambienti, impostare il moodboard visivo di una scena cinematografica e prototipare scenari di gioco. Per produzioni commerciali finite e ancora presto.
Google · Le tue fontiPiù in alto su Google con un solo clicAggiungi alle fonti preferite →Fonti e data di verifica
- Odyssey - Meet Odyssey-3
- Google - Project Genie
- 9to5Google su Project Genie
- Wikipedia - Genie (world model)
- Test diretto della redazione su Odyssey-3 eseguito il 9/10/2026. Informazioni verificate al 9 ottobre 2026.
More on this from NITIDO

 stato dell'ia·ROAR: serie temporali zero-shot con retrieval augmentationROAR ottimizza l'uso dei dati storici nel forecasting zero-shot di serie temporali, decidendo quando fidarsi dei candidati recuperati dal database.