Test Gemini 4 Argon: 23 compiti contro Opus 5.5 e GPT-6 Astra
Ho messo alla prova Gemini 4 Argon su 23 compiti complessi: 99,5% di precisione, costi ridotti e massima velocità nel confronto con Opus 5.5 e GPT-6 Astra.
Aggiornamento (9 novembre 2026): sono usciti Claude Fable 5.2 e Mythos 5.2 - prezzi, accesso e benchmark nella mia guida a Claude Fable 5.2.
👁 125 letture
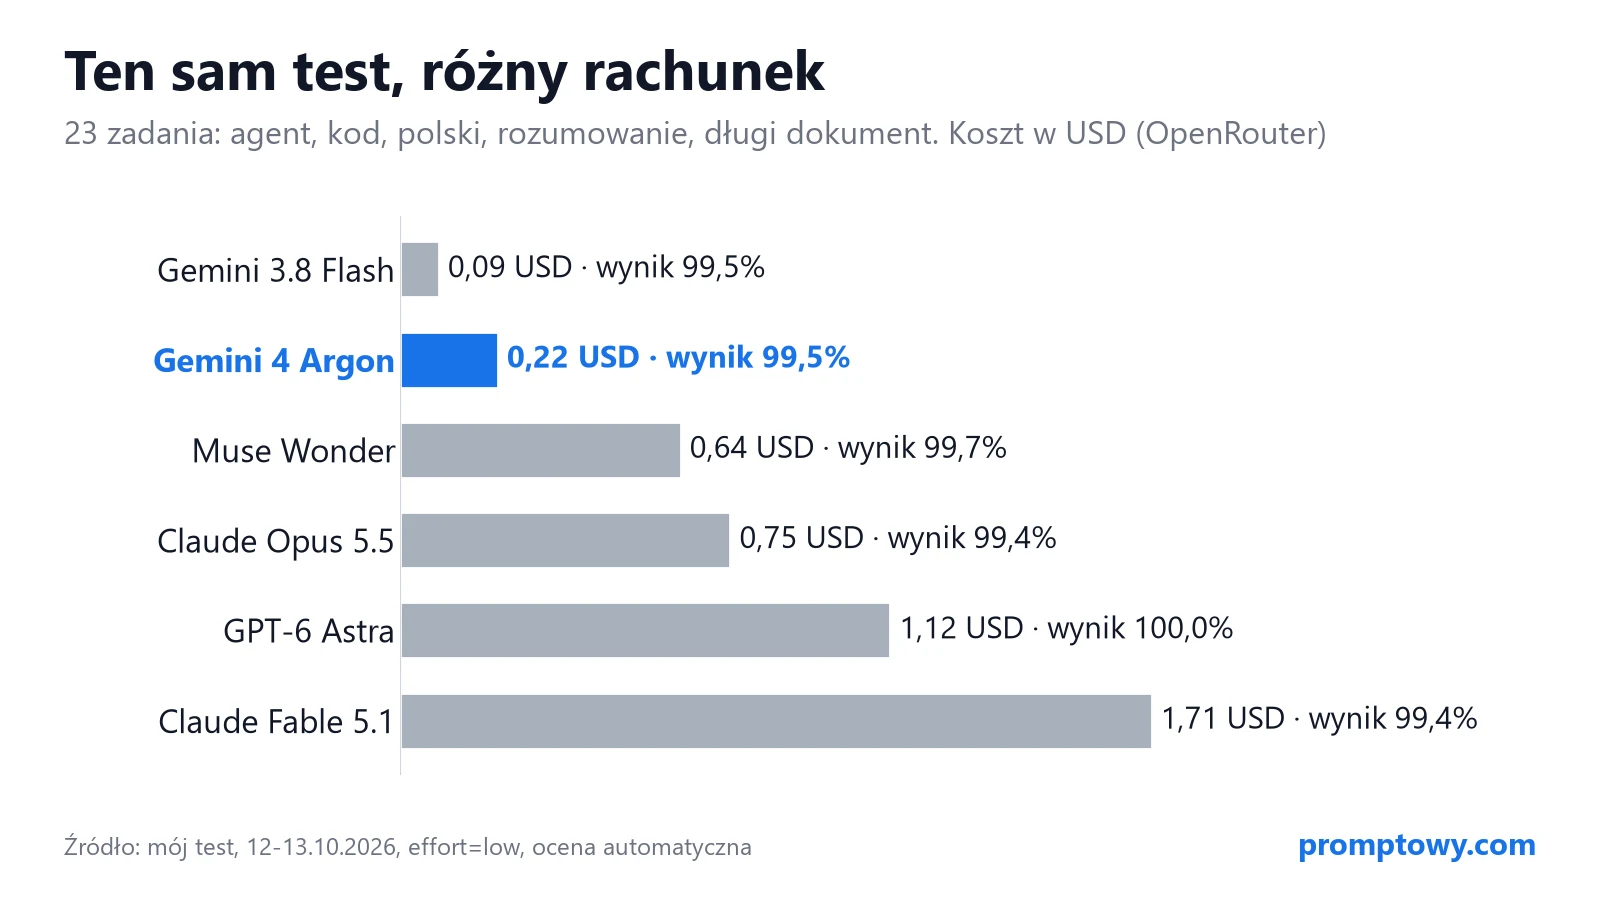
La sera del 13 ottobre 2026, mezz’ora dopo l’apertura ufficiale di Gemini 4 Argon a tutti gli utenti paganti da parte di Google, ho sottoposto il modello allo stesso set di 23 compiti affrontato il giorno prima da Muse Wonder, Claude Opus 5.5, Claude Fable 5.1, GPT-6 Astra e Gemini 3.8 Flash. Argon ha raggiunto il 99,5%, con un costo di circa 0,20 EUR (0,22 USD) e il tempo complessivo più rapido di tutti: 135 secondi per completare l’intera sequenza. L’unico punto formalmente perso si è rivelato un difetto del mio script di valutazione, mentre una svista reale si nascondeva pochi paragrafi più sotto. Dettagli sul modello, prezzi e disponibilità sono raccolti nella guida dedicata a Gemini 4 Argon. I valori in valuta europea qui riportati sono stime calcolate secondo il tasso di riferimento BCE del 12 ottobre 2026 (1 EUR = 1,1181 USD, fonte: BCE).
Dati del test: sera del 13 ottobre 2026
- Modello:
google/gemini-4-argonvia OpenRouter, livello di ragionamento impostato su low. - Concorrenti: gli stessi 23 compiti, lo stesso codice e gli stessi parametri di configurazione, eseguiti il 12 ottobre durante il test di Muse Wonder.
- Valutazione automatizzata: unit test, verifica delle chiamate agli strumenti (tool call), risposte esatte. Nessun giudice AI: ogni penalità è stata verificata manualmente da me.
- Costo totale di Argon nel benchmark: circa 0,20 EUR (0,22 USD) con la tariffa promozionale di lancio di circa 1,79 EUR (2 USD) in input e circa 8,94 EUR (10 USD) in output per milione di token.
I risultati a confronto
| Modello | Punteggio (23 compiti) | Costo stimato (USD originale) | Tempo totale |
|---|---|---|---|
| Gemini 4 Argon | 99,5% | circa 0,20 EUR (0,22 USD) | 135 s |
| Muse Wonder | 99,7% | circa 0,57 EUR (0,64 USD) | 165 s |
| Claude Opus 5.5 | 99,4% | circa 0,67 EUR (0,75 USD) | 222 s |
| GPT-6 Astra | 100% | circa 1,00 EUR (1,12 USD) | 200 s |
| Claude Fable 5.1 | 99,4% | circa 1,53 EUR (1,71 USD) | 263 s |
| Gemini 3.8 Flash | 99,5% | circa 0,08 EUR (0,09 USD) | 139 s |
Il punteggio rappresenta la media sui 23 compiti, ciascuno con il medesimo peso. Nelle prove con più requisiti, il valore riflette la quota percentuale di criteri soddisfatti. Tra i modelli di punta, Argon è il più economico: circa 3,4 volte meno caro di Claude Opus 5.5, 5 volte meno di GPT-6 Astra e 2,9 volte inferiore rispetto a Muse Wonder. Solo Gemini 3.8 Flash, un modello pensato per fasce d’impiego più leggere, ha registrato una spesa inferiore.
I compiti inclusi nella prova
| Ambito | Compiti (testati originariamente in lingua polacca) | Metodo di valutazione |
|---|---|---|
| Agenti e strumenti (3) | Pianificazione viaggio a Lisbona con 3 strumenti e tranelli tariffari; reso tardivo per un e-commerce; conversione fatture in EUR con tassi ufficiali e gestione errore 503 alla prima richiesta | Correttezza delle chiamate agli strumenti, decisioni prese, valori numerici finali |
| Programmazione (4) | Validazione identificativo fiscale locale, fusione di intervalli temporali, calcolo giorni lavorativi con festività variabili, trascrizione importi numerici in lettere per fatture | 51 unit test eseguiti in locale |
| Elaborazione testi complessi (4) | Correzione di 10 errori ortografici, sintesi in 3 punti entro 60 parole, redazione ricorso amministrativo previdenziale, declinazione morfologica di toponimi e cognomi complessi | Checklist analitica e controllo delle forme grammaticali esatte |
| Ragionamento logico (11) | Combinatoria, logica di calendario, angoli delle lancette dell’orologio, indovinelli su cavalieri e furfanti | Confronto con la risposta esatta |
| Documento lungo (1) | 80 verbali di consiglio d’amministrazione (158.111 caratteri), 5 quesiti di cui uno relativo a una delibera modificata in seguito e uno su un dettaglio del tutto assente dal testo | Verifica di risposte puntuali |
Prestazioni per categoria
| Ambito | Gemini 4 Argon | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|
| Agenti | 100%, circa 0,022 EUR (0,025 USD) | 100%, circa 0,081 EUR (0,091 USD) | 100%, circa 0,089 EUR (0,100 USD) |
| Programmazione | 100%, circa 0,025 EUR (0,028 USD) | 100%, circa 0,074 EUR (0,083 USD) | 100%, circa 0,116 EUR (0,130 USD) |
| Elaborazione testi | 97,2%, circa 0,020 EUR (0,022 USD) | 96,4%, circa 0,098 EUR (0,110 USD) | 100%, circa 0,097 EUR (0,108 USD) |
| Ragionamento | 100%, circa 0,039 EUR (0,044 USD) | 100%, circa 0,102 EUR (0,114 USD) | 100%, circa 0,075 EUR (0,084 USD) |
| Documento lungo | 100%, circa 0,092 EUR (0,103 USD) | 100%, circa 0,317 EUR (0,355 USD) | 100%, circa 0,622 EUR (0,695 USD) |
Nel confronto ho evidenziato il punteggio più alto o, in caso di pareggio, il costo inferiore. Gli altri modelli hanno perso frazioni di punteggio in punti differenti: Muse Wonder nella programmazione (98,4% per un refuso nella conversione in lettere), Gemini 3.8 Flash sempre nel codice (96,9% per aver anticipato di un anno una nuova festività) e sia Claude Fable 5.1 che Opus 5.5 nei testi (96,4% per aver superato il limite tassativo di 60 parole nel riassunto).
Velocità ed efficienza economica
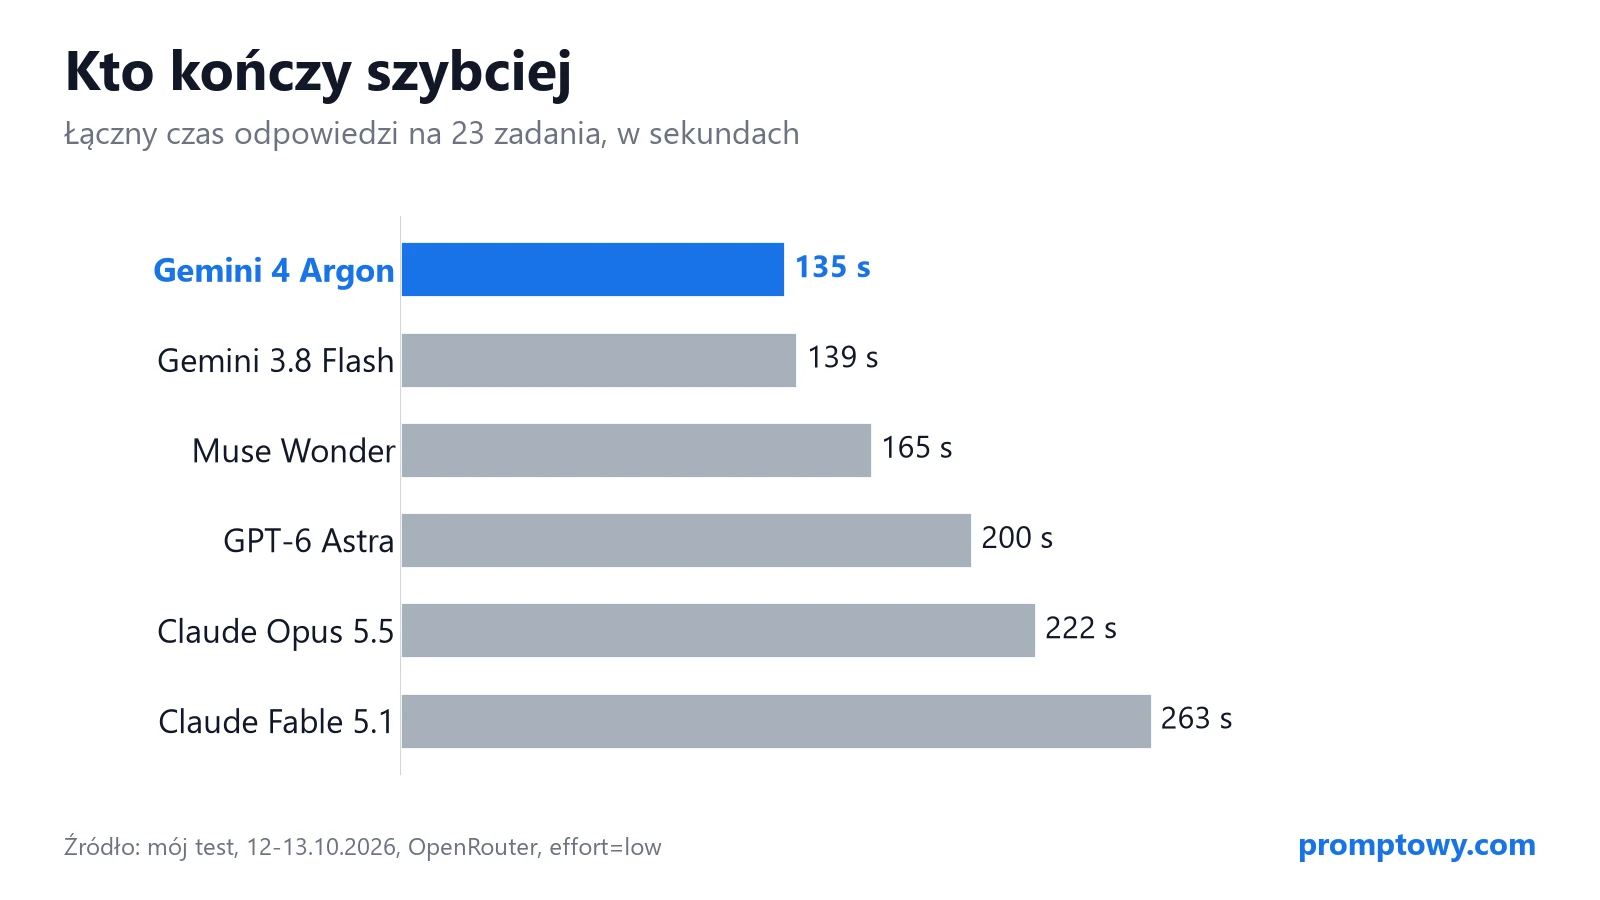
Argon produce risposte concise senza pause superflue. Su OpenRouter, con l’opzione reasoning impostata su low, il modello non ha generato alcun token di riflessione visibile nei 23 compiti; la correzione del testo con 10 errori è stata completata in 2,6 secondi. Per contro, Muse Wonder ha consumato 636 token di ragionamento solo per pianificare l’itinerario di viaggio. Alcuni riscontri puntuali:
- Viaggio a Lisbona: 4 chiamate API in 2 passaggi, esclusione delle due insidie (un volo troppo mattutino e un hotel con recensioni insufficienti), itinerario con museo al coperto per via di una probabilità di pioggia dell’80%. Precisione analoga ai rivali, ma con un costo di soli circa 0,010 EUR (0,011 USD).
- Reso e-commerce: ha individuato la transazione corretta, rifiutato la pratica e spiegato all’acquirente che erano trascorsi 32 giorni dalla consegna a fronte di un termine di 30.
- Fatturazione e tassi di cambio: dopo aver ricevuto un codice HTTP 503 dal servizio bancario centrale, ha ritentato la query, escluso la fattura già saldata e calcolato correttamente l’importo convertito.
- Documento lungo: 5 risposte corrette su 5 in 4,5 secondi per circa 0,09 EUR (0,10 USD). Ha rilevato che la metratura del magazzino era stata rettificata a 6.200 mq in un verbale successivo e ha replicato “NON PRESENTE” alla domanda su una campagna social mai menzionata. GPT-6 Astra ha impiegato meno tempo (3,5 s), ma a fronte di circa 0,62 EUR (0,69 USD).
Nella gestione di documenti corposi pesa notevolmente l’efficienza del tokenizer. I medesimi 158.111 caratteri si sono tradotti in 51.482 token per Argon, mentre Claude ne ha generati 87.675 (circa il 70% in più). Unendo questa compattezza al prezzo inferiore, interrogare gli 80 verbali è costato circa 0,09 EUR (0,10 USD) con Argon, 0,17 EUR (0,19 USD) con Muse Wonder (46.929 token ma tariffati a 4 USD per milione), 0,32 EUR (0,35 USD) con Opus 5.5, 0,62 EUR (0,69 USD) con Astra e 0,79 EUR (0,88 USD) con Fable 5.1.
Il ricorso amministrativo: analisi della penalità
Il sistema automatico ha assegnato ad Argon 8 punti su 9 nella redazione del ricorso amministrativo previdenziale per una pensione d’invalidità respinta, segnalando come assente il tribunale ordinario quale destinatario. Esaminando l’output effettivo, il tribunale era presente ma declinato nella formula polacca del complemento di termine: Argon ha intestato correttamente l’atto indicando la sezione lavoro e previdenza dell’organo competente, specificando la trasmissione tramite l’ente previdenziale. Il mio script cercava la dicitura al nominativo: si trattava dunque di un limite dell’algoritmo di verifica e non di un errore del modello. Con la correzione manuale il punteggio sale al 100%, appaiando GPT-6 Astra. Nel riepilogo mantengo il dato grezzo per garantire uniformità di giudizio con le altre sessioni.
Nel testo compaiono passaggi procedurali solidi: Argon ha ricordato la necessità del passaggio medico preliminare e ha calcolato la scadenza del termine di un mese, slittando dal giorno festivo domenicale al primo lunedì utile. Il difetto rilevante risiede invece nella motivazione. La traccia fornita specificava unicamente che la commissione medica aveva omesso la cartella cardiologica del 2026. Nel testo prodotto (qui tradotto dal polacco utilizzato nel test), Argon ha inserito sintomi non indicati e formulato accuse dirette:
[Traduzione dall’originale polacco] “I sintomi della patologia, quali rapido affaticamento, dispnea da sforzo, sbalzi pressori e dolori precordiali, precludono il normale svolgimento delle attività quotidiane (…)”
[Traduzione dall’originale polacco] “Il medico collegiale, nel formulare il proprio giudizio, ha condotto una visita del tutto sommaria (…)”
Anche Opus 5.5 ha suggerito riferimenti simili, ma racchiudendoli tra parentesi quadre come esempi da personalizzare; Argon li ha presentati come circostanze accertate. In un atto giudiziario dove ogni perizia viene confrontata minuziosamente con la documentazione clinica, un’aggiunta arbitraria rappresenta un rischio concreto: se utilizzi Argon per redigere memorie o testi formali, ti consiglio di esaminare la motivazione riga per riga.
I costi previsti dopo il periodo promozionale
La tariffa di lancio di circa 1,79 EUR (2 USD) in ingresso e circa 8,94 EUR (10 USD) in uscita per milione di token termina il 30 novembre 2026. Dal 1° dicembre i prezzi di listino passano a circa 3,58 EUR (4 USD) e circa 17,89 EUR (20 USD), allineandosi a Opus 5.5 e Muse Wonder. Mantenendo inalterati i volumi di token, il costo del mio benchmark raddoppierà indicativamente:
| Modello | Prezzo per 1M token (input / output) | Costo stimato 23 compiti |
|---|---|---|
| Gemini 4 Argon (fino al 30/11) | circa 1,79 / 8,94 EUR (2 / 10 USD) | circa 0,20 EUR (0,22 USD) |
| Gemini 4 Argon (dal 01/12) | circa 3,58 / 17,89 EUR (4 / 20 USD) | circa 0,40 EUR (ca. 0,45 USD) |
| Muse Wonder | circa 3,58 / 17,89 EUR (4 / 20 USD) | circa 0,57 EUR (0,64 USD) |
| Claude Opus 5.5 | circa 3,58 / 17,89 EUR (4 / 20 USD) | circa 0,67 EUR (0,75 USD) |
| GPT-6 Astra | circa 8,94 / 44,72 EUR (10 / 50 USD) | circa 1,00 EUR (1,12 USD) |
| Claude Fable 5.1 | circa 8,94 / 44,72 EUR (10 / 50 USD) | circa 1,53 EUR (1,71 USD) |
| Gemini 3.8 Flash | circa 0,67 / 3,35 EUR (0,75 / 3,75 USD) | circa 0,08 EUR (0,09 USD) |
Anche dopo l’aggiornamento dei listini, Argon risulterà in questo scenario circa 1,7 volte meno oneroso di Opus 5.5 a parità di tariffa base per token. Ciò dipende dalla tendenza a produrre risposte asciutte prive di token di ragionamento aggiuntivi e dalla maggiore densità del tokenizer. Anche la memorizzazione in cache (input caching) subirà un ritocco, passando da circa 0,09 EUR (0,10 USD) a circa 0,18 EUR (0,20 USD) per milione di token.
Limiti e condizioni della prova
- Impostazione effort=low: tutti i modelli sono stati eseguiti con il profilo di ragionamento minimo per garantire uniformità e contenere la spesa. I dati ufficiali diffusi da Google impiegano la configurazione massima, definendo uno scenario operativo differente.
- Campione contenuto e singola esecuzione: 23 compiti affrontati una sola volta. Una discrepanza su una singola prova non costituisce un divario strutturale.
- Date distinte: i modelli concorrenti sono stati valutati il 12 ottobre, mentre Argon è stato testato il 13 ottobre a ridosso del rilascio dell’API. I task erano identici, ma la latenza può risentire del carico dell’infrastruttura nei rispettivi momenti.
- Punteggi prossimi al tetto massimo: tutti i partecipanti hanno registrato tra il 99% e il 100%. Il benchmark evidenzia differenze di spesa, velocità e peculiarità di risposta, ma non stabilisce quale architettura prevalga nella risoluzione di problemi di complessità estrema.
- Valutazione via script: l’analisi misura parametri oggettivi e aderenza formale, non l’eleganza stilistica. La penalità sul ricorso dimostra come gli automatismi possano equivocare le forme linguistiche, motivo per cui ho analizzato singolarmente ogni errore.
- Accesso tramite OpenRouter: le condizioni economiche e i pesi del modello corrispondono alla release ufficiale, ma la prova non si è svolta direttamente sulle chiavi Gemini API della console Google.
Considerazioni finali
Nei flussi operativi di routine Argon offre risposte sovrapponibili a quelle di Opus 5.5, Astra e Fable 5.1, garantendo costi sensibilmente più bassi e tempi di risposta ridotti. Durante il periodo promozionale rappresenta il modello di vertice più accessibile fra quelli analizzati; dopo l’aumento manterrà comunque un margine di convenienza rispetto ad Opus 5.5 grazie alla gestione dei token. Di contro, mostra la tendenza ad arricchire i testi con asserzioni non presenti nel prompt iniziale. Nei test dedicati alla qualità di scrittura e stile (svolti in lingua polacca con valutazione in cieco), Argon ha ottenuto 81,8 punti piazzandosi all’ottavo posto, a distanza da Opus 5.5 che ha guidato la classifica con 90,1 punti, come approfondito nell’analisi su Gemini 4 Argon nei testi complessi. Queste conclusioni riflettono la singola sessione di test condotta il 13 ottobre 2026.
Domande frequenti
Gemini 4 Argon è superiore a Claude Opus 5.5?
Nel benchmark su 23 compiti l’accuratezza rilevata è sostanzialmente pari: 99,5% contro 99,4%. Argon ha richiesto una spesa 3,4 volte inferiore completando l’elaborazione in tempi più brevi, mentre Opus 5.5 conserva un vantaggio sensibile nella redazione stilistica avanzata.
Qual è il prezzo delle API di Gemini 4 Argon?
Fino al 30 novembre 2026 la tariffa ammonta a circa 1,79 EUR (2 USD) per milione di token in entrata e circa 8,94 EUR (10 USD) in uscita. Dal 1° dicembre i valori saliranno rispettivamente a circa 3,58 EUR (4 USD) e circa 17,89 EUR (20 USD).
Quale ambiente è stato impiegato per la prova?
L’esecuzione è avvenuta tramite OpenRouter richiamando l’endpoint google/gemini-4-argon, accessibile e funzionante al momento del test il 13 ottobre 2026.
Fonti
- Benchmark proprietario su OpenRouter: Gemini 4 Argon testato il 13/10/2026, modelli comparativi il 12/10/2026, 23 compiti, reasoning impostato su low, validazione automatizzata e controllo manuale
- OpenRouter: documentazione e tariffe per Gemini 4 Argon
- Gemini API: listino prezzi ufficiale Google
- Google: Gemini 4 Argon: Built to solve your hardest problems (13/10/2026)
- Google DeepMind: report di valutazione e benchmark di Gemini 4 Argon
More on this from NITIDO


 notizie·Liquid AI lancia LFM2.5-24B-A2B: modello agentico localeLiquid AI presenta LFM2.5-24B-A2B su Hugging Face: 24 miliardi di parametri totali, ma solo 2B attivi per eseguire agenti AI veloci e privati in locale.