Qwen-Image-2.1 benchmark: tabella completa 29 modelli immagine
Il produttore ha pubblicato un grafico con 29 modelli. Abbiamo estratto i numeri e confrontato le dimensioni: un modello da 7B batte uno da 80B di oltre 9 punti.
👁 115 letture
Il produttore di Qwen-Image-2.1 ha pubblicato al lancio un grafico che confronta 29 modelli di generazione immagini - aperti e chiusi. Nessuno lo ha fornito in formato tabella, quindi abbiamo estratto i numeri dal grafico e li abbiamo confrontati con le dimensioni dei modelli. Il risultato è più interessante della semplice posizione in classifica.
Verdetto in un paragrafo
Qwen-Image-2.1 si posiziona al settimo posto con un punteggio di 60,28 punti nel benchmark Qwen-Image-Bench. Davanti a lui ci sono esclusivamente modelli chiusi, di cui i produttori non rivelano le dimensioni. Più interessante è ciò che accade dietro di lui: supera Nano Banana 2.0, GPT Image 1.5, Seedream 5 Pro e Nano Banana Pro, oltre a FLUX 2 Max, che è quattro volte più grande, e Hunyuan Image 3.0 - undici volte più grande. È un modello da 7 miliardi di parametri che batte un modello da ottanta di oltre nove punti.
Classifica completa Qwen-Image-Bench
Numeri estratti dal grafico pubblicato dal produttore. La colonna delle dimensioni è vuota dove il produttore del modello non le rivela - nel grafico era indicato con un lucchetto.
| # | Modello | Punteggio | Dimensioni |
|---|---|---|---|
| 1 | GPT Image 2.5 Sunburst | 67,01 | non rivelate |
| 2 | GPT Image 2 | 64,69 | non rivelate |
| 3 | Grok Imagine 2.0 | 63,47 | non rivelate |
| 4 | Qwen Image 3 Pro | 62,36 | non rivelate |
| 5 | Muse Image | 62,34 | non rivelate |
| 6 | MAI Image 2.5 Pro | 61,02 | non rivelate |
| 7 | Qwen-Image-2.1 | 60,28 | 7B |
| 8 | Nano Banana 2.0 | 59,82 | non rivelate |
| 9 | GPT Image 1.5 | 59,65 | non rivelate |
| 10 | Seedream 5 Pro | 59,53 | non rivelate |
| 11 | Nano Banana Pro | 59,45 | non rivelate |
| 12 | Grok Imagine Quality | 58,47 | non rivelate |
| 13 | Qwen Image 2.0 Pro | 57,84 | non rivelate |
| 14 | Seedream 5.0 | 57,22 | non rivelate |
| 15 | Seedream 4.5 | 56,78 | non rivelate |
| 16 | Seedream 4.0 | 56,21 | non rivelate |
| 17 | FLUX 2 Max | 55,33 | 32B |
| 18 | FLUX 2 Pro | 54,57 | 32B |
| 19 | GPT Image 1 | 54,07 | non rivelate |
| 20 | Qwen Image 2512 | 52,06 | 20B |
| 21 | Imagen 4.0 Ultra | 51,99 | non rivelate |
| 22 | Boogu | 51,40 | 10B |
| 23 | Hunyuan Image 3.0 | 50,81 | 80B |
| 24 | Imagen 4.0 | 50,29 | non rivelate |
| 25 | Qwen Image | 49,23 | 20B |
| 26 | Kling Image 2.1 | 48,26 | non rivelate |
| 27 | GLM Image | 48,19 | 16B |
| 28 | LongCat | 46,34 | 6B |
| 29 | HiDream O1 | 46,17 | circa 8B |
Una precisazione necessaria: questo è un benchmark pubblicato dal produttore di uno dei modelli valutati. Trattalo come materiale del produttore, perché lo è. Questo non significa che i numeri siano inventati - significa che il set di compiti e il metodo di punteggio sono stati scelti da una parte interessata al risultato.
Tre cose visibili solo confrontando con le dimensioni
1. Salto all’interno della stessa famiglia
| Versione | Dimensioni | Punteggio |
|---|---|---|
| Qwen Image | 20B | 49,23 |
| Qwen Image 2512 | 20B | 52,06 |
| Qwen-Image-2.1 | 7B | 60,28 |
Un modello quasi tre volte più piccolo ottiene 8,22 punti in più rispetto al predecessore diretto. Non è un semplice aggiornamento, ma un’architettura diversa - layer single-stream, attenzione a granularità mista e riutilizzo della cache.
2. Le dimensioni non sono più un lasciapassare per la vetta
Hunyuan Image 3.0 ha 80 miliardi di parametri e un punteggio di 50,81. Qwen-Image-2.1 ha 7 miliardi e 60,28. La differenza è undici volte le dimensioni a favore del perdente.
Conseguenza pratica per chi calcola l’hardware: il modello che dà il risultato migliore entra in una singola scheda consumer, mentre quello più grande richiede una server farm. Questa è un’opinione: per la maggior parte delle applicazioni, questo chiude la discussione su quale scegliere.
3. I modelli chiusi guidano ancora, ma il vantaggio si è ridotto
Al leader mancano 6,73 punti, al terzo posto 3,19. Un modello aperto che puoi eseguire a casa è oggi cinque punti dietro la vetta, non venti. Dietro di lui sono rimasti invece modelli per cui paghi per ogni immagine.
Cosa ha ricevuto il modello in questa versione
Il produttore elenca quattro modifiche:
- Architettura compatta - 32 layer DiT, attenzione a granularità mista, riutilizzo della cache di chiavi e valori con più immagini in input.
- Trasparenza native - possibilità di specificare nel prompt che l’immagine deve avere un canale alfa, e ritaglio di oggetti da foto come layer. L’abbiamo verificato con misurazioni.
- Editing - fino a dieci immagini di riferimento, indicazione dell’area di editing con cerchio, mascheratura o maschera, conservazione dell’identità delle persone e dell’aspetto dei prodotti.
- Texture e tipografia - luce migliore sui ritratti e disposizione del testo che tiene conto del font e della composizione.
Inoltre panorami da una singola foto, infografiche e storyboard da character sheet.
Come l’abbiamo testato
Abbiamo installato il modello localmente su RTX 4090 ed eseguito sei test. Due conclusioni che non trovi nei materiali del produttore:
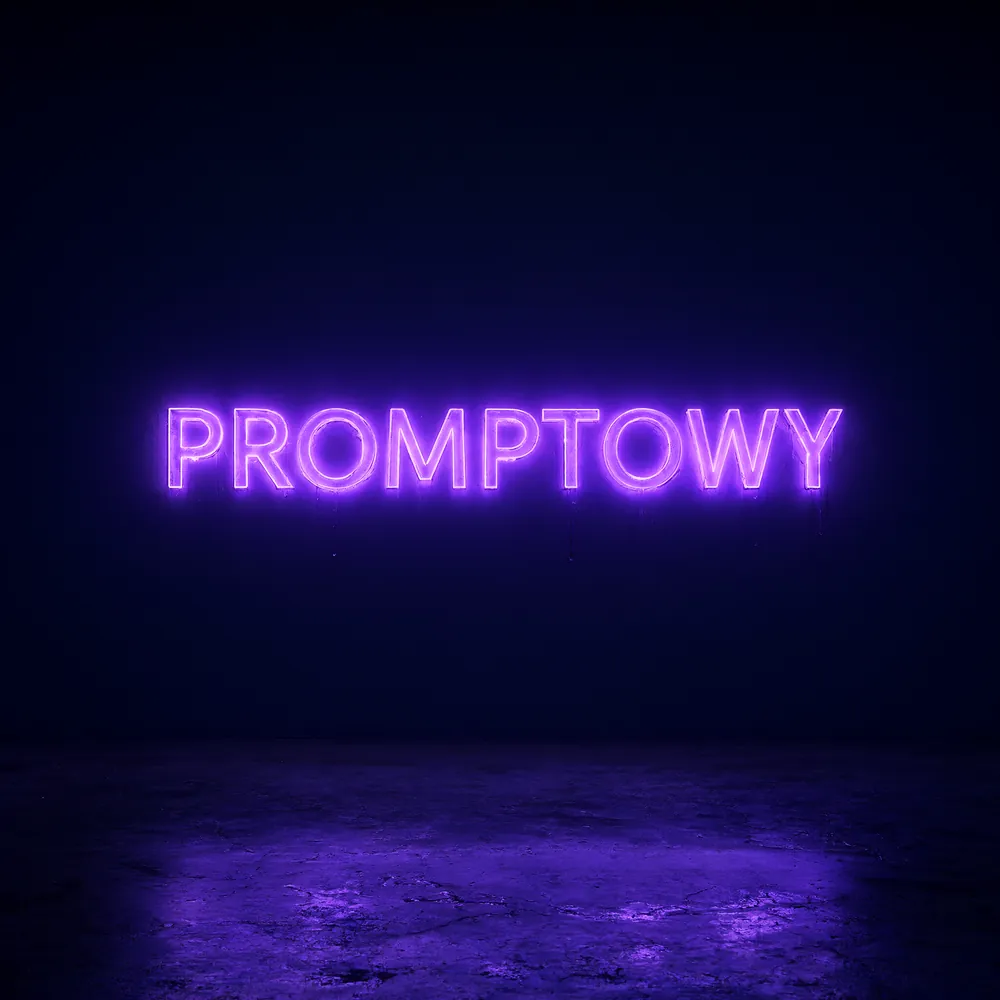
Insegna al neon con la scritta [MARCHIO] generata localmente in risoluzione 2048×2048 - la scritta è uscita perfetta al primo tentativo.
- Le scritte sono effettivamente corrette. L’insegna al neon con la scritta [MARCHIO] in 2048×2048 è uscita perfetta al primo tentativo.
- I prompt sull’età dei personaggi vengono talvolta ignorati. La richiesta di un ritratto di donna trentenne ha prodotto una persona visibilmente più anziana - tecnicamente eccellente, ma non conforme al prompt.
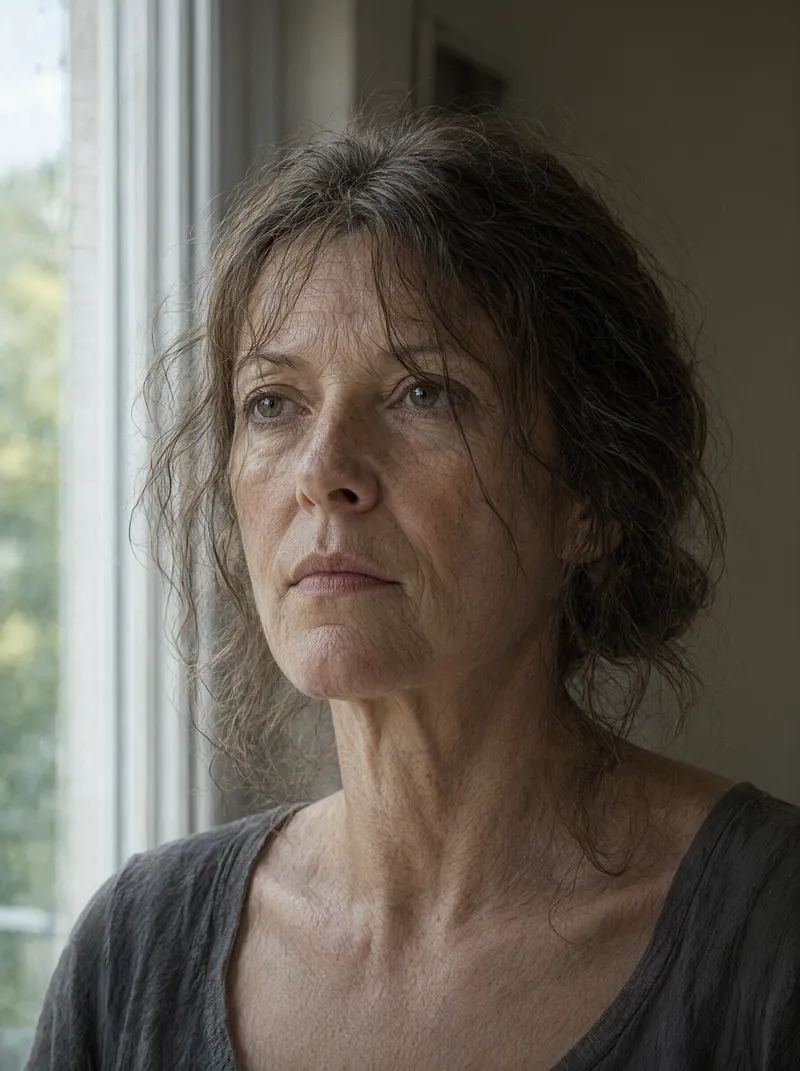
Ritratto da un prompt su una donna trentenne. Texture della pelle e luce impeccabili, età del personaggio visibilmente superiore a quella richiesta.
Tempi, impostazioni e script pronti sono nella guida all’installazione, e abbiamo raccolto tutto nella guida al modello.
Come appaiono i risultati in pratica
Il benchmark è un singolo numero. Qui sotto tre immagini da tre categorie diverse, per mostrare cosa c’è dietro quel numero.
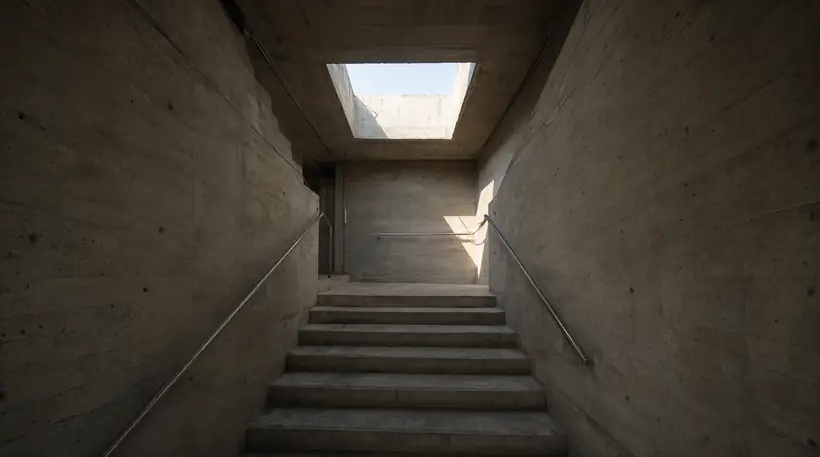
Architettura - categoria in cui il modello eccelle maggiormente.
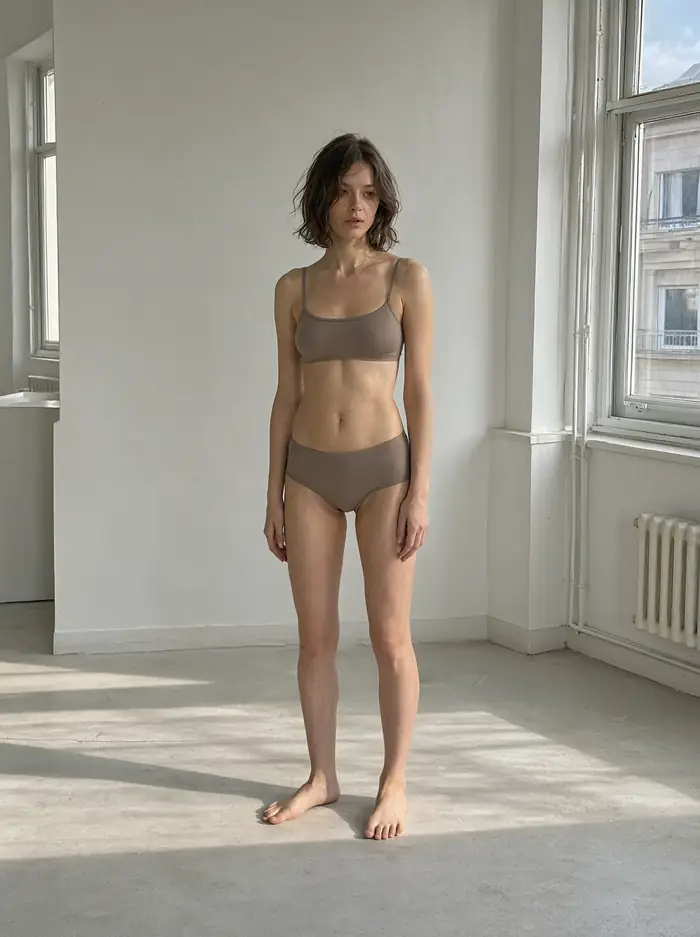
Luce naturale - il modello rinuncia all’aspetto da campagna pubblicitaria in favore del reportage.
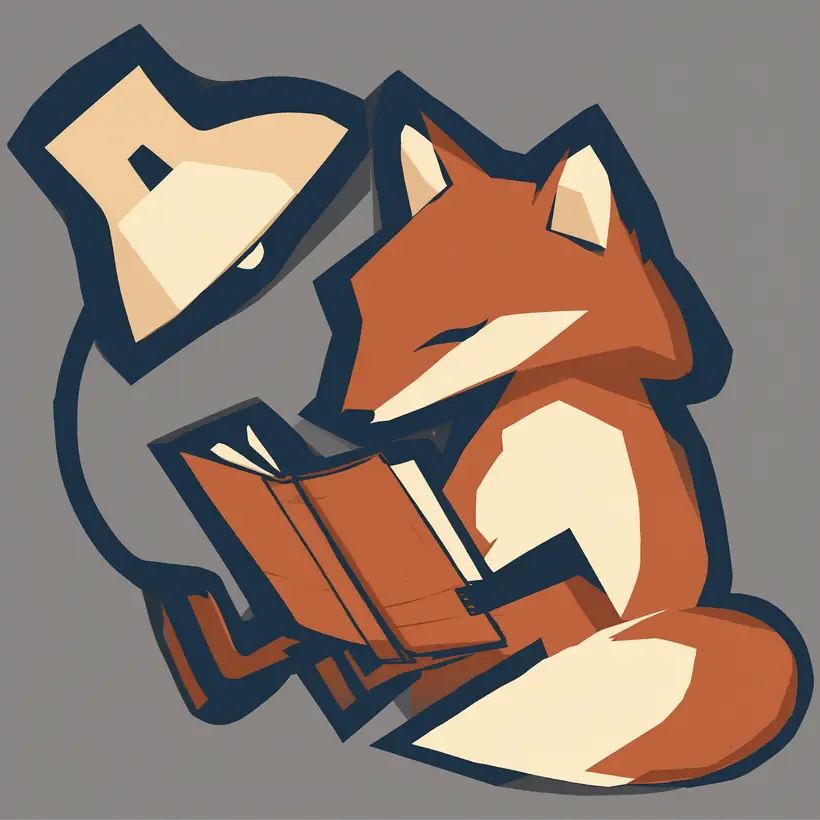
Illustrazione vettoriale - corretta, ma generica. Qui si vede il limite.
Domande frequenti
Quale punteggio ha Qwen-Image-2.1 nel benchmark?
60,28 punti in Qwen-Image-Bench, settimo posto tra 29 modelli confrontati.
È il miglior modello aperto per immagini?
In questo confronto sì - supera FLUX 2 Max (55,33), Hunyuan Image 3.0 (50,81) e GLM Image (48,19). Ricorda che il benchmark proviene dal produttore.
Quanti parametri ha?
7 miliardi nella parte che genera l’immagine, in 32 layer DiT single-stream.
Quale modello vince il benchmark?
GPT Image 2.5 Sunburst con un punteggio di 67,01, davanti a GPT Image 2 (64,69) e Grok Imagine 2.0 (63,47).
È migliore di Nano Banana?
Secondo questo benchmark sì: 60,28 contro 59,82 per Nano Banana 2.0 e 59,45 per Nano Banana Pro. La differenza è tuttavia minima.
Fonti e data di verifica
- Risultati estratti il 22 settembre 2026 dal grafico Qwen-Image-Bench pubblicato nell’annuncio di lancio su qwen.ai
- descrizione dell’architettura e delle funzioni dallo stesso annuncio e dalla scheda del modello Qwen/Qwen-Image-2.1. Il produttore ha fornito questi dati in forma di grafico
- non di tabella - i numeri nella tabella sopra sono una lettura della redazione da quel grafico. Le osservazioni sulle scritte e sull’età dei personaggi provengono dai nostri test su RTX 4090
More on this from NITIDO


 magazine·Qwen-Image-2.1 senza censura: test dei pesi ufficialiLe versioni "senza censura" cambiano qualcosa? Abbiamo testato i pesi ufficiali: il filtro non è nei pesi, ma nel servizio cloud.