HappyHorse 1.1: 7 video di prova con prompt e voti
Ho generato 7 video con HappyHorse 1.1: movimenti di camera, dialoghi e image-to-video. Ecco tutti i prompt usati, i voti e i limiti emersi dai test.
👁 112 letture
Ho generato 7 clip con il modello HappyHorse 1.1 tramite OpenRouter, ciascuna di 5 secondi in 720p al costo di circa 0,44 EUR (0,494 USD). Tre sono riuscite molto bene (8,5/10): lo stesso personaggio dopo uno stacco di montaggio, un dialogo in inglese e un’animazione da immagine con una tazza. Due hanno invece fallito nettamente: una scritta su lavagna in polacco (3/10) e il parlato in lingua polacca (4,5/10). Di seguito trovi ogni clip con il prompt esatto e la valutazione. Classifiche, prezzi e disponibilità si trovano nella guida a HappyHorse 1.1. I prezzi convertiti in EUR sono stime basate sul tasso BCE del 12/10/2026: 1 EUR = 1,1181 USD (fonte: https://www.ecb.europa.eu/stats/eurofxref/eurofxref-daily.xml).
Verdetto in sintesi (11 ottobre 2026)
- Punti di forza: movimenti di camera, coerenza del personaggio, generazione da immagine (image-to-video), parlato in inglese.
- Punti deboli: testo renderizzato nell’inquadratura, caratteri speciali, parlato in lingue diverse dall’inglese, fisica dei liquidi.
- Media delle 4 scene del test comparativo (senza parlato): 6,1/10. Wan 3.0 aveva ottenuto 9,1.
- Costo del test: circa 3,09 EUR (3,46 USD) per 7 clip, più circa 0,027 EUR (0,03 USD) per il frame iniziale.
Come ho condotto il test
Tutti i video sono stati generati l’11 ottobre 2026 tramite l’API di OpenRouter (alibaba/happyhorse-1.1), a risoluzione 720p, formato 16:9, durata di 5 secondi e con lo stesso seed 20261008. La generazione ha richiesto tra i 96 e i 112 secondi per clip. Ogni file ha una risoluzione di 1280×720 a 24 frame al secondo con traccia audio. Le prime cinque scene utilizzano gli stessi identici prompt impiegati nel mio confronto nella video arena dell’8 ottobre, consentendo un paragone diretto con altri sei modelli. La valutazione segue il medesimo metodo: quattro fotogrammi chiave (all’8%, 35%, 62% e 92% della durata) più l’analisi del video completo, su una scala da 0 a 10. Per il parlato ho verificato la fedeltà con faster-whisper large-v3 calcolando il WER (Word Error Rate), ovvero la percentuale di parole trascritte in modo errato.
| Esempio | Ambito d’uso | Valutazione | Migliore nell’Arena dell’8/10 |
|---|---|---|---|
| 1. Orbita attorno alla moto | inquadrature di prodotto, spot | 8 | Wan 3.0 e Kling 3.0: 8,5 |
| 2. Parlato in polacco | reel con dialoghi in lingua | 4,5 | MiniMax H3 Max: 9 |
| 3. Scritta sulla lavagna | cartelli, insegne, loghi | 3 | Wan 3.0 e H3 Max: 10 |
| 4. Versare l’acqua | food, bevande | 5 | Wan 3.0: 9 |
| 5. Personaggio in 2 inquadrature | cortometraggi, serie video | 8,5 | Wan 3.0: 9 |
| 6. Parlato in inglese | reel e spot in inglese | 8,5 | scena esterna all’Arena |
| 7. Da immagine a video | animazione di foto prodotto | 8,5 | scena esterna all’Arena |
La barra completa corrisponde a 10 punti.
I sette video di prova
1. Orbita della telecamera attorno alla moto
Ambito d’uso: inquadratura di prodotto su tutti i lati, apertura di uno spot, transizione per video musicali.
A smooth 180-degree camera orbit around a vintage red motorcycle parked on a wet cobblestone street in an old European town at blue hour. The camera circles steadily from the front of the motorcycle to its back at a constant speed. Street lamps reflect in the puddles, light drizzle. The motorcycle keeps its exact shape and details. Realistic cinematic footage, real-time motion, no text, no logos.
Traduzione del prompt testato: una telecamera gira fluidamente a 180 gradi attorno a una moto d’epoca rossa parcheggiata sul pavé bagnato durante l’ora blu, con i lampioni che si riflettono nelle pozzanghere.
Valutazione: 8/10. L’inquadratura ruota con precisione dal fronte-lato al retro-lato, compiendo il mezzo giro richiesto. La moto non perde dettagli strutturali né deforma la carrozzeria; le pozzanghere e i riflessi sono convincenti. Si tratta di un risultato in linea con MiniMax H3 Max (8) e di poco inferiore a Wan 3.0 (8,5). Nello stesso test, Seedance 2.5 aveva generato un telo scuro improvvisato sulla sella, mentre Veo 3.1 Lite non aveva praticamente mosso la telecamera.
2. Parlato in lingua polacca
Ambito d’uso: reel con dialoghi locali, pubblicità con voce narrante in primo piano.
Mezzo primo piano di una donna sui trent'anni seduta al tavolo della cucina, che guarda dritto nella telecamera. Pronuncia in polacco in modo chiaro e calmo: (traduzione dell'originale polacco: "A Szczebrzeszyn lo scarabeo ronza nella canna, e io pago trentadue unità della valuta polacca originale"). Luce diurna naturale da una finestra, telecamera statica, realistico, niente sottotitoli, niente testo sullo schermo, niente musica.
Traduzione del prompt originale (testato intenzionalmente con una complessa frase in polacco ricca di consonanti): primo piano medio di una donna sui trent’anni al tavolo della cucina che pronuncia un noto scioglilingua locale e una cifra monetaria.
Valutazione: 4,5/10. Il video è visivamente valido, il labiale è sincronizzato e la voce suona naturale. Tuttavia il modello di riconoscimento vocale Whisper ha riscontrato evidenti distorsioni fonetiche: 6 parole su 12 sono risultate errate, con un WER di 0,5. Nel medesimo test in lingua polacca, MiniMax H3 Max aveva totalizzato un WER pari a 0, Wan 3.0 lo 0,167 e Seedance 2.5 lo 0,583. Trovi l’analisi approfondita nell’articolo sul parlato polacco in HappyHorse 1.1.
3. Scritta con il gesso sulla lavagna
Ambito d’uso: schermate con titoli, insegne, nomi di prodotti nel frame.
Primo piano di una lavagna scolastica verde in un'aula illuminata dal sole. Una mano finisce di scrivere con il gesso bianco. La lavagna mostra chiaramente esattamente due righe di testo in lettere maiuscole: prima riga (traduzione dell'originale polacco: "ARENA VIDEO 2026"), seconda riga (traduzione dell'originale polacco: "BARCA GIALLA"). Telecamera statica, realistico, polvere di gesso nella luce, nessun altro testo.
Traduzione del prompt testato: primo piano di una lavagna scolastica verde illuminata dal sole dove una mano scrive in maiuscolo (traduzione dell’originale polacco: “ARENA VIDEO 2026”) e (traduzione dell’originale polacco: “BARCA GIALLA”) (con lettere polacche accentate).
Valutazione: 3/10.Il movimento della mano e la polvere di gesso che fluttua nella luce sono resi in modo molto realistico. Il testo, tuttavia, presenta errori marcati: sulla lavagna compare “testo corrotto nel test originale polacco 2026” e “testo corrotto nel test originale polacco”. Nell’arena comparativa solo Wan 3.0 e MiniMax H3 Max hanno scritto entrambe le righe in modo impeccabile. Se hai bisogno di inserire testo preciso nel video, HappyHorse 1.1 non è la scelta adatta; conviene aggiungerlo in post-produzione.
4. Versare acqua fino a farla traboccare
Ambito d’uso: spot per il settore beverage, cucina, inquadrature con simulazione di fluidi.
Static close-up on a wooden kitchen table in daylight. Water is poured from a glass pitcher into an empty clear drinking glass. The stream splashes, bubbles rise, the water level rises steadily until the glass overflows and water spills onto the table and spreads into a puddle. Real-time speed, no slow motion, realistic physics, no text.
Traduzione del prompt testato: l’acqua viene versata da una caraffa in un bicchiere vuoto; il livello sale fino a traboccare formando una pozzanghera sul tavolo.
Valutazione: 5/10. Il flusso dell’acqua e le bolle d’aria sono resi visivamente bene. L’errore riguarda la coerenza temporale: la chiazza d’acqua sul tavolo compare già al secondo secondo, prima ancora che il bicchiere sia colmo. Lo stesso errore di sincronizzazione fisica era capitato a Veo 3.1 Lite (anch’esso valutato con 5). Wan 3.0 aveva meritato un 9 grazie a una salita graduale del livello del liquido e alla fuoriuscita al momento esatto.
5. Lo stesso personaggio in due inquadrature diverse
Ambito d’uso: narrazioni brevi, produzioni seriali con l’AI, spot con personaggio ricorrente.
Two shots separated by one hard cut. Shot 1: wide shot of a young woman with short red hair, round black glasses, a yellow raincoat and a black backpack walking along a rainy city street at night with neon reflections on the wet pavement. Hard cut. Shot 2: close-up of the same woman with the same short red hair, the same round black glasses and the same yellow raincoat as she stops under a shop awning and looks up at the rain. Realistic, cinematic, no text.
Traduzione del prompt testato: due inquadrature separate da uno stacco netto. Nella prima una donna con capelli rossi corti e impermeabile giallo cammina di notte sotto la pioggia; nella seconda c’è un primo piano della stessa persona sotto una tenda da sole.
Valutazione: 8,5/10. Lo stacco di montaggio avviene esattamente al punto giusto. Dopo il taglio il viso resta coerente, così come gli occhiali, l’impermeabile giallo e le cinghie dello zaino. L’unica lieve discrepanza riguarda la lunghezza dei capelli, leggermente maggiore nel primo piano. Il risultato supera MiniMax H3 Max (7,5, che aveva modificato il taglio in un caschetto con frangia) e Seedance 2.5 (6, in cui il cappuccio nascondeva la testa). Soltanto Wan 3.0 ha fatto di meglio (9).
6. Pescatore che parla in inglese
Ambito d’uso: reel e contenuti pubblicitari in inglese, stile documentaristico con camera a spalla.
Medium shot of an elderly fisherman with a grey beard sitting on a wooden pier at sunrise, mending a net. He looks up at the camera, smiles and says in English: "The sea gives you exactly what you have patience for." Gentle waves, seagulls in the distance, warm golden light, handheld documentary style, realistic, no subtitles, no text.
Traduzione del prompt testato: un anziano pescatore con la barba grigia ripara una rete su un molo all’alba, guarda verso la camera e pronuncia in inglese una frase sul mare e la pazienza.
Valutazione: 8,5/10. Whisper ha trascritto la frase senza commettere alcun errore (WER 0) e il movimento delle labbra segue fedelmente il parlato. Unica nota di demerito: un micro-stacco iniziale non richiesto (un rapido dettaglio sulle mani) prima di passare all’inquadratura media. Poiché si tratta dello stesso generatore che nel test in polacco ha fallito metà dei termini, è evidente come il collo di bottiglia sia legato al dataset linguistico e non alla capacità di sintesi labiale in sé.
7. Da immagine a video: tazza e caffè
Ambito d’uso: animazione di immagini di prodotto, contenuti per e-commerce, cutaway.
Il frame iniziale (una tazza verde su un tavolo di quercia) è stato generato con il modello Qwen-Image 3 via OpenRouter per circa 0,027 EUR (0,03 USD):
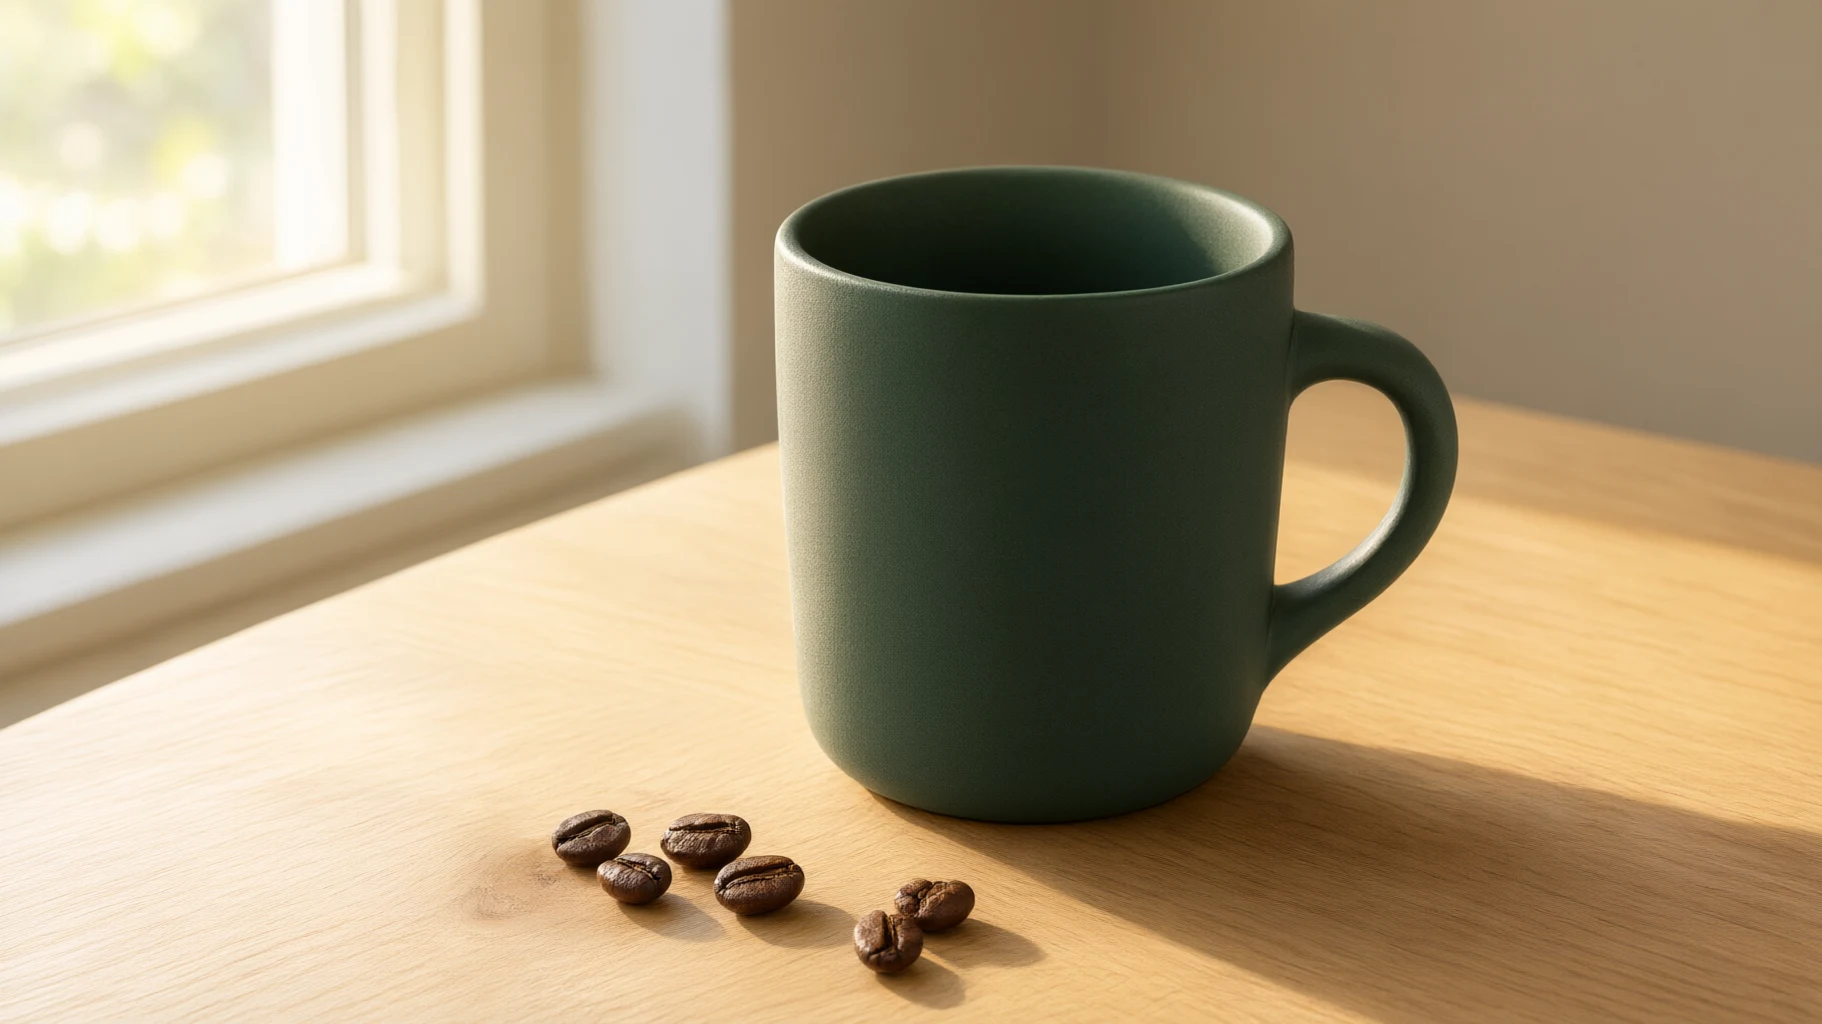
Slow camera push-in on the green ceramic mug. Hot black coffee is poured into the mug from above in a thin stream, steam rises and curls in the sunlight, dust particles float in the window light. Sound of pouring coffee and a quiet morning kitchen. Realistic, no text, no logo.
Traduzione del prompt testato: carrellata in avanti lenta verso la tazza verde, caffè nero che scende dall’alto in un flusso sottile, vapore che si alza controluce e rumore tipico di una cucina al mattino.
Valutazione: 8,5/10. L’avvicinamento dell’inquadratura è fluido, la tazza mantiene esattamente geometria e colore dell’immagine di partenza, il caffè scende in modo lineare e il vapore è convincente. L’unico effetto collaterale è che i chicchi di caffè ai bordi escono dall’inquadratura per via del movimento, comportamento otticamente normale. È una chiara dimostrazione del perché HappyHorse risulti più efficace nella modalità image-to-video rispetto al puro text-to-video.
Prompt ufficiali consigliati da provare
Alibaba Cloud non distribuisce file video corredati da prompt; sul blog ufficiale è presente solo una GIF senza istruzioni. I prompt seguenti arrivano dalla documentazione tecnica e dalla campagna di lancio. Non li ho generati direttamente, per cui non riporto il risultato video.
Città in miniatura di cartone (documentazione, text-to-video)
A miniature city built from cardboard and bottle caps comes to life at night. A cardboard train slowly passes through, with small lights dotting the scene and illuminating the way ahead.
Traduzione dell’esempio: una città in miniatura costruita con cartone e tappi a corona prende vita di notte, mentre un trenino di cartone l’attraversa illuminato da piccole luci. Fonte: documentazione di Alibaba Cloud.
Danza con cambio di stile visivo (campagna Alibaba Cloud)
A girl is dancing gracefully. As she spins around in a full turn, the entire scene seamlessly transforms from a cartoon style into a realistic live-action setting.
Traduzione dell’esempio: una ragazza balla con grazia e durante una piroetta completa la scena passa senza interruzioni dallo stile cartoon a un’inquadratura realistica dal vivo. Fonte: pagina della campagna HappyHorse.
Battaglia di ballo tra due soggetti (fal.ai, con riferimenti)
A dance battle between character1 and character2, cinematic lighting, smooth camera movement.
Traduzione dell’esempio: sfida di ballo tra due figure definite da immagini di riferimento, luce cinematografica e movimento fluido. Questa tipologia richiede la modalità con reference image, che non ho verificato personalmente; le diciture character1 e character2 fanno riferimento ai file caricati.
Galleria della community
Su happyhorse.com è disponibile una bacheca di template creati dagli utenti, con esempi che spaziano da cuccioli a clip complesse da 15 secondi strutturate al secondo, fino a scene horror in stile anni ’80 con diversi elementi di riferimento. Ti consiglio di consultarla per studiare la struttura dei prompt reali. Non incorporo i video qui poiché sono stati realizzati da utenti terzi senza licenze esplicite. Il video in evidenza “Are You Happy - HappyHorse 1.1 Is Now Available” (2:21, 23/06/2026) è visibile direttamente sul loro portale.
Conclusioni e consigli pratici
- Formula i prompt in inglese e mantieni il parlato in inglese se intendi usare la voce del modello. Le lingue con dataset ridotti mostrano frequenti errori fonetici.
- Non affidarti al modello per inserire scritte. Applica testi e grafiche in post-produzione.
- Parti da un’immagine di riferimento ogni volta che puoi: la modalità image-to-video ha fornito i risultati più stabili e puliti.
- Definisci inquadrature e tagli in modo esplicito nel testo (ad esempio “Shot 1”, “Hard cut”, “Shot 2”): il modello recepisce bene queste indicazioni di montaggio.
Per scoprire come HappyHorse 1.1 si posiziona rispetto a Wan 3.0, Seedance e MiniMax sulle stesse scene, consulta il nostro confronto tra quattro modelli. Per test aggiuntivi, puoi fare riferimento alla nostra video arena e alla classifica dei generatori video AI.
Fonti e data di verifica
- Clip del test: OpenRouter, modello alibaba/happyhorse-1.1, testate l’11/10/2026; valutazioni comparative dalla video arena dell’08/10/2026
- Documentazione tecnica Alibaba Cloud (verificata l’11/10/2026)
- Campagna promozionale HappyHorse di Alibaba Cloud (verificata l’11/10/2026)
- happyhorse.com, galleria della community (verificata l’11/10/2026)
More on this from NITIDO