Gemma 4 31B in locale su RTX 4090: VRAM, velocita e test
Abbiamo provato Gemma 4 31B su RTX 4090 con Ollama: 42 tok/s, 19 GB di VRAM, licenza Apache 2.0 e benchmark completi. Guida e ottimizzazioni.
👁 114 letture
Gemma 4 31B di Google e il modello denso a pesi aperti piu potente in grado di funzionare interamente su una singola scheda grafica RTX 4090. Lo abbiamo provato con Ollama: genera circa 42 token al secondo, in test linguistici complessi (che abbiamo condotto in polacco) ha totalizzato 9,5 su 10, ma occupa quasi tutti i 24 GB di memoria della scheda ed e severo con i dischi lenti. Ecco tutti i numeri, le misure di VRAM e la guida per farlo girare.
Situazione all’8 ottobre 2026
- Modello:
gemma4:31b-it-qatin Ollama 0.40.1 (versione con quantizzazione post-training QAT, file da 17,65 GB + 1,2 GB del modulo visivo). - Licenza: Apache 2.0 - libero utilizzo anche commerciale.
- Velocita: 40,7-43,4 tok/s in generazione, circa 870-1240 tok/s in elaborazione del prompt.
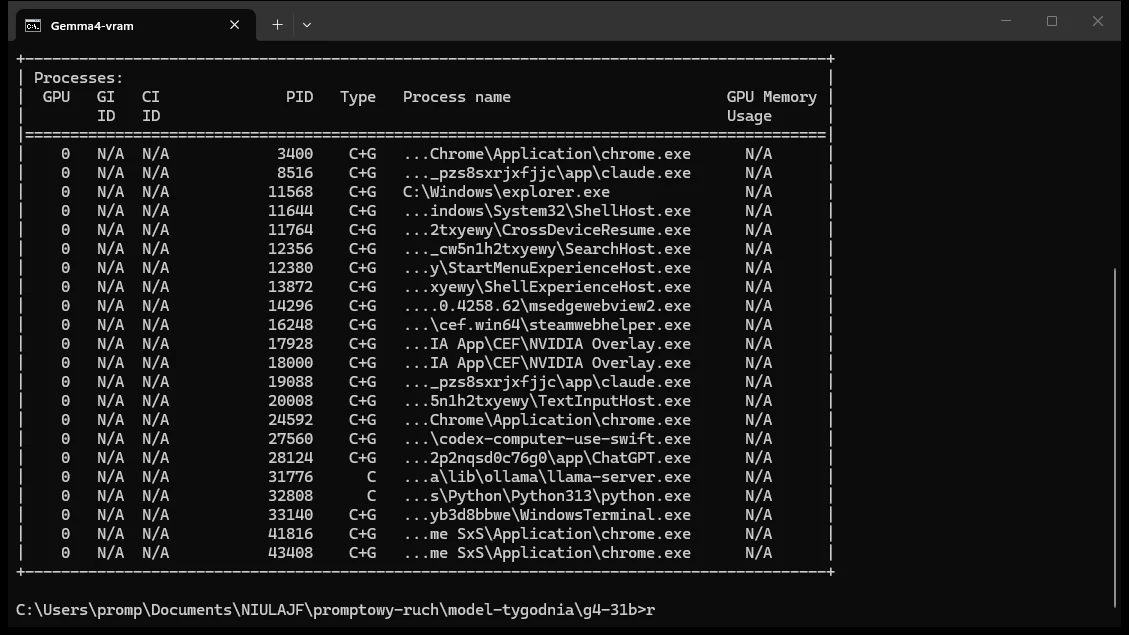
- Memoria grafica: 19,2 GB allocati da Ollama, picco complessivo della scheda a 24,0 GB (nvidia-smi).
- Qualita linguistica: 9,5/10 nei nostri 5 test avanzati (condotti in polacco).
- Download: 40 min 41 s. Caricamento da disco USB: da 1 min 53 s a 14 min 33 s.
Perche partire proprio da Gemma 4 31B
Ogni settimana mettiamo alla prova un modello aperto su una RTX 4090 (24 GB, Windows 11) analizzando sempre gli stessi aspetti: installazione, caricamento, velocita, VRAM, resa nei testi articolati e licenza d’uso. Prima di selezionare Gemma 4 31B abbiamo preso in esame diverse alternative recenti, ma quasi tutte presentavano limitazioni per una singola scheda consumer:
- Ling 3.1 Flash - conta 560 miliardi di parametri e non offre pesi aperti (ne abbiamo parlato nell’analisi su Ling 3.1 Flash).
- Mistral Small 4 - a dispetto del nome ha 119 miliardi di parametri; perfino con quantizzazioni spinte non entra in 24 GB.
- GLM 5.3 - non esiste un’edizione “Air”, e la variante minima GLM-5.3 Flash richiede 320 miliardi di parametri.
- Hy Image 3.5 - Tencent ha reso disponibile solo un’anteprima via API, senza rilasciare i pesi.
- Qwen 3.8 27B - gia analizzato nel nostro confronto tra 7 modelli in locale.
Gemma 4 31B e disponibile da qualche mese, ma mancava ancora una verifica approfondita su hardware reale. Si tratta del modello piu grande della famiglia Gemma 4 ed e l’unico modello “denso” (non MoE) di questa taglia eseguibile su una comune GPU enthusiast da 24 GB.
Scheda tecnica del modello
| Caratteristica | Gemma 4 31B |
|---|---|
| Sviluppatore | Google DeepMind |
| Parametri | 30,7 miliardi, modello denso (tutti attivi su ogni singolo token) |
| Finestra di contesto | fino a 256.000 token |
| Input / Output | input di testo e immagini; output esclusivamente testuale |
| Lingue | oltre 140 nel dataset di addestramento, circa 35 con supporto elevato secondo Google |
| Licenza | Apache 2.0 |
| Build in Ollama | gemma4:31b-it-qat (Q4_0, 19 GB), gemma4:31b-it-q8, gemma4:31b-it-bf16 (63 GB) |
| Impostazioni consigliate | temperature 1.0, top_p 0.95, top_k 64 |
La versione QAT e stata ottimizzata direttamente in fase di training per la quantizzazione a 4 bit, preservando una precisione superiore rispetto a una normale quantizzazione standard a 4 bit. Su una scheda da 24 GB rappresenta l’unica scelta realistica, dato che la build q8 supera i 30 GB.
I nostri benchmark su RTX 4090
| Misurazione | Risultato | Note |
|---|---|---|
| Download (18,2 GB) | 40 min 41 s | velocita variabile tra 4 e 29 MB/s |
| Primo caricamento | errore dopo 5 min | “timed out waiting for llama-server to start” - vedi sotto per la soluzione |
| Caricamento da disco USB | 8 min 32 s e 14 min 33 s | unita D: collegata via USB, transfer rate di circa 44-66 MB/s |
| Caricamento da cache RAM | 1 min 53 s | file gia mantenuto nella RAM di sistema dalla sessione precedente |
| Generazione (media su 5 task) | 40,7-43,4 tok/s | contesto impostato a 8192, senza reasoning attivo |
| Output lungo (1438 token) | 41,3 tok/s | circa 800 parole completate in 35 s |
| Generazione con contesto a 32.768 | 42,2 tok/s | nessuna perdita di velocita riscontrata |
| Elaborazione prompt | 870-1240 tok/s | prima query piu lenta per warmup (24 tok/s) |
| VRAM modello (Ollama) | 19,2 GB (8k) / 19,3 GB (32k) | 100% offload su GPU |
| VRAM totale scheda (nvidia-smi) | 21,8 GB a riposo, 24,0 GB al picco | inclusi desktop e browser attivo (circa 0,8 GB prima del test) |
Una velocita compresa tra 41 e 43 token al secondo e ampiamente superiore al ritmo medio di lettura umana. Nel nostro test comparativo di modelli in locale la piu compatta Gemma 4 12B toccava 104 tok/s occupando 8 GB, mentre Qwen 3.8 27B viaggiava a circa meta velocita occupando 17 GB. Gemma 4 31B risulta quindi la piu esigente del gruppo, ma garantisce una fluidita impeccabile per qualsiasi sessione interattiva.
Regola fondamentale: niente altri carichi sulla GPU
Mentre acquisivamo le schermate di test, sulla stessa GPU e partito in background un processo di generazione immagini con ComfyUI. La VRAM disponibile e andata subito a saturazione (23,9 su 24 GB), Windows ha iniziato a scaricare memoria sulla RAM di sistema e il throughput di generazione e crollato da 42 a 2,7 tok/s, scendendo fino a 0,5 tok/s nel tentativo successivo. Il modello da 31 miliardi di parametri occupa quasi tutta la memoria: non lascia margine per affiancare un generatore di immagini, e perfino un browser con molte schede aperte puo sottrarre centinaia di megabyte critici.
Test pratici: 5 sfide complesse
Abbiamo sottoposto il modello a una batteria di 5 compiti ad alta difficolta linguistica e logica. Abbiamo eseguito questi test specifici in polacco per mettere alla prova declinazioni irregolari, ortografia complessa, calcoli contabili e comprensione di modi di dire. Ogni prova e valutata da 0 a 2 punti.
| Prova | Punteggio | Esito osservato |
|---|---|---|
| E-mail formale con toponimi e cognomi complessi (Brzęczyszczykiewicz, Szczebrzeszyn) | 1,5/2 | declinazione corretta di „do Szczebrzeszyna”, inserito sconto 10% con codice promozionale, ma ha omesso il cognome nell’incipit („Szanowny Panie Grzegorzu”) |
| Correzione bozze su 8+ errori ortografici e sintattici | 2/2 | ha individuato ogni refuso, errore di concordanza e 5 virgole mancanti |
| Calcolo fattura: 3 voci con aliquote differenziate (23% e 5%) | 2/2 | imposta calcolata a 1314,00, lordo finale 7073,90 - esatto all’ultimo centesimo |
| 5 domande di conoscenza territoriale e storica | 2/2 | risposte perfette sui capoluoghi del voivodato, autore classico, altezza del monte Rysy (2499 m), data storica (1410) e numero di regioni (16) |
| 3 espressioni idiomatiche con contestualizzazione | 2/2 | definizioni accurate ed esempi d’uso naturali |
| Punteggio totale | 9,5/10 |
Abbiamo riscontrato due piccole imperfezioni di stile: il modello tende a fare largo uso di formattazione Markdown (elenchi puntati, grassetti) e nella correzione ha inserito frecce formattate in sintassi LaTeX ($rightarrow$), che richiedono un renderer adeguato per vedersi pulite. Quando e attiva la modalita reasoning interna, il modello struttura il ragionamento in inglese prima di formulare l’output finale nella lingua richiesta.
E-mail formale di scuse - risposta completa del modello (185 token, 42,5 tok/s)
Prompt originale (testato in polacco): Napisz krótki e-mail (do 120 słów) do klienta, pana Grzegorza Brzęczyszczykiewicza ze Szczebrzeszyna, z przeprosinami za 5-dniowe opóźnienie dostawy krzesła biurowego. Zaproponuj rabat 10% na kolejne zamówienie. Ton uprzejmy, bez przesady. Użyj poprawnej odmiany nazwiska i nazwy miejscowości.
*(Traduzione: Scrivi una breve e-mail (massimo 120 parole) al cliente Grzegorz Brzęczyszczykiewicz di Szczebrzeszyn scusandoti per un ritardo di 5 giorni nella consegna di una sedia da ufficio. Offri uno sconto del 10% sul prossimo ordine. Tono cordiale ma professionale. Usa la corretta declinazione di cognome e toponimo).*
Temat: Przeprosiny za opóźnienie w dostawie zamówienia

Szanowny Panie Grzegorzu,

chciałbym najmocniej przeprosić za 5-dniowe opóźnienie w dostawie Pana krzesła biurowego do Szczebrzeszyna. Bardzo nam przykro z powodu zaistniałej sytuacji.

W ramach rekompensaty przygotowaliśmy dla Pana kod rabatowy o wartości 10% na kolejne zamówienie w naszym sklepie: RABAT10.

Mamy nadzieję, że produkt spełni Pana oczekiwania, a ten gest pozwoli nam zachować Pana zaufanie. W razie dodatkowych pytań pozostaję do dyspozycji.

Z poważaniem,

[Twoje Imię i Nazwisko]
[Nazwa Firmy]
Correzione del testo - risposta completa del modello (306 token, 40,7 tok/s)
Prompt originale (testato in polacco): Popraw błędy w tekście i wypisz listę poprawek (każda w osobnym punkcie: było -> jest). Tekst: “Wczoraj poszłem do sklepu żeby kupić chleb, ale okazało się że był zamknięty. W poniedziałek napewno pójde jeszcze raz, bo mam nadzieje że będzie otwarte. Moja koleżanka która tam pracuje mówiła, że wogóle nie zamykają przed 18.“
*(Traduzione: Correggi gli errori nel testo e stila un elenco delle correzioni, ciascuna su un punto separato nel formato: prima -> dopo).*
Oto poprawiony tekst:

„Wczoraj poszedłem do sklepu, żeby kupić chleb, ale okazało się, że był zamknięty. W poniedziałek na pewno pójdę jeszcze raz, bo mam nadzieję, że będzie otwarty. Moja koleżanka, która tam pracuje, mówiła, że w ogóle nie zamykają przed 18.”

Lista poprawek:
* poszłem $rightarrow$ poszedłem (błąd fleksyjny)
* sklepu żeby $rightarrow$ sklepu, żeby (brak przecinka przed spójnikiem)
* okazało się że $rightarrow$ okazało się, że (brak przecinka przed spójnikiem)
* napewno $rightarrow$ na pewno (pisownia rozdzielna)
* pójde $rightarrow$ pójdę (brak polskiego znaku)
* nadzieje $rightarrow$ nadzieję (brak polskiego znaku)
* że będzie otwarte $rightarrow$ że będzie otwarty (błąd składniowy - sklep jest rodzaju męskiego)
* koleżanka która $rightarrow$ koleżanka, która (brak przecinka przed zdaniem podrzędnym)
* pracuje mówiła $rightarrow$ pracuje, mówiła (brak przecinka zamykającego zdanie podrzędne)
* wogóle $rightarrow$ w ogóle (pisownia rozdzielna)
Calcolo contabile - risposta completa del modello (176 token, 41,4 tok/s)
Prompt originale (testato in polacco): Policz fakturę. Pozycje netto: laptop 4200,00 (VAT 23%), książka 59,90 (VAT 5%), usługa szkolenia 1500,00 (VAT 23%). Podaj VAT dla każdej pozycji, sumę netto, sumę VAT i sumę brutto. Kwoty zaokrąglaj do grosza. Na końcu jedna linia: BRUTTO = …
*(Traduzione: Calcola la fattura. Voci imponibile netto: laptop 4200,00 (IVA 23%), libro 59,90 (IVA 5%), servizio di formazione 1500,00 (IVA 23%). Fornisci l’IVA per ciascuna voce, la somma imponibile, la somma IVA e il totale lordo. Arrotonda ai centesimi. Chiudi con una riga: BRUTTO = …).*
Oto wyliczenia dla poszczególnych pozycji:

*   Laptop: netto 4200,00 $rightarrow$ VAT (23%): 966,00
*   Książka: netto 59,90 $rightarrow$ VAT (5%): 3,00
*   Usługa szkolenia: netto 1500,00 $rightarrow$ VAT (23%): 345,00

Suma netto: 5759,90
Suma VAT: 1314,00
Suma brutto: 7073,90

BRUTTO = 7073,90
5 quesiti puntuali - risposta completa del modello (60 token, 43,4 tok/s)
Prompt originale (testato in polacco): Odpowiedz krótko na 5 pytań, każde w jednej linii: 1) Jakie miasta są siedzibami władz województwa lubuskiego? 2) Kto napisał “Lalkę“? 3) Jak wysoki jest najwyższy szczyt Polski i jak się nazywa? 4) W którym roku odbyła się bitwa pod Grunwaldem? 5) Ile województw ma Polska?
*(Traduzione: Rispondi brevemente a 5 domande, ciascuna su una riga: 1) Quali citta sono capoluoghi del voivodato di Lubusz? 2) Chi ha scritto “Lalka”? 3) Quanto e alta la vetta piu alta della Polonia e come si chiama? 4) In che anno si svolse la battaglia di Grunwald? 5) Quanti voivodati ha la Polonia?).*
1) Zielona Góra i Gorzów Wielkopolski.
2) Bolesław Prus.
3) 2499 m n.p.m., Rysy.
4) 1410.
5) 16.
Espressioni idiomatiche - risposta completa del modello (303 token, 42,0 tok/s)
Prompt originale (testato in polacco): Wyjaśnij prostym językiem znaczenie trzech polskich frazeologizmów i do każdego podaj jedno zdanie przykładowe: “wyjść jak Zabłocki na mydle“, “rzucać grochem o ścianę“, “mieć muchy w nosie“.
*(Traduzione: Spiega con parole semplici il significato di tre modi di dire polacchi e fornisci per ciascuno una frase d’esempio: “fare la fine di Zablocki con il sapone”, “tirare piselli contro il muro”, “avere mosche nel naso”).*
Oto wyjaśnienia tych frazeologizmów napisane prostym językiem:

1. Wyjść jak Zabłocki na mydle
*   Znaczenie: Oznacza ponieść klęskę, sromotnie przegrać lub zostać z niczym, mimo że miało być inaczej (często po tym, jak ktoś wierzył w łatwy zysk).
*   Przykład: *Kupiłem ten tani telefon przez internet, ale okazał się zepsuty i sprzedawca nie chce oddać pieniędzy - wyszedłem jak Zabłocki na mydle.*

2. Rzucać grochem o ścianę
*   Znaczenie: Mówić do kogoś, kto zupełnie nie słucha, nie rozumie lub ignoruje nasze argumenty i prośby.
*   Przykład: *Tłumaczę synowi już godzinę, że musi posprzątać pokój, ale to jak rzucanie grochem o ścianę.*

3. Mieć muchy w nosie
*   Znaczenie: Być w złym humorze bez wyraźnego powodu, być marudnym lub poirytowanym.
*   Przykład: *Nie podchodź teraz do Anny, bo od samego rana ma muchy w nosie i na wszystko się gniewa.*
Licenza d’uso: quali sono i vincoli
Gemma 4 e distribuito sotto licenza Apache 2.0. Si tratta di un passaggio rilevante rispetto a Gemma 3, vincolata a termini proprietari di Google con restrizioni d’uso specifiche. In sintesi:
- puoi impiegare il modello in contesti commerciali, inclusa l’integrazione in software destinati ai clienti;
- puoi eseguire fine-tuning e distribuire versioni modificate, mantenendo le consuete note di licenza;
- non sono previste royalty verso Google: i soli costi sono l’hardware e l’energia elettrica.
Guida pratica all’installazione con Ollama
- Installa Ollama da ollama.com (abbiamo utilizzato la release 0.40.1). Se vuoi salvare i modelli su un percorso diverso da quello di default, imposta la variabile di sistema
OLLAMA_MODELS(nel nostro casoD:AIollama). Per approfondire trovi tutti i dettagli nella nostra guida a Ollama. - Scarica il modello (circa 18 GB):
ollama pull gemma4:31b-it-qat
- Estendi il timeout di avvio se usi un disco non velocissimo. Di fabbrica Ollama attende fino a 5 minuti; da un’unita USB il caricamento puo richiedere da 8 a 14 minuti, generando l’errore “timed out waiting for llama-server to start”. Su PowerShell (dopo aver chiuso l’icona di Ollama nella barra di sistema):
$env:OLLAMA_LOAD_TIMEOUT = "30m"
ollama serve
L’opzione ideale resta comunque ospitare i file su un’unita NVMe interna.
- Avvia e monitora le prestazioni da un secondo terminale:
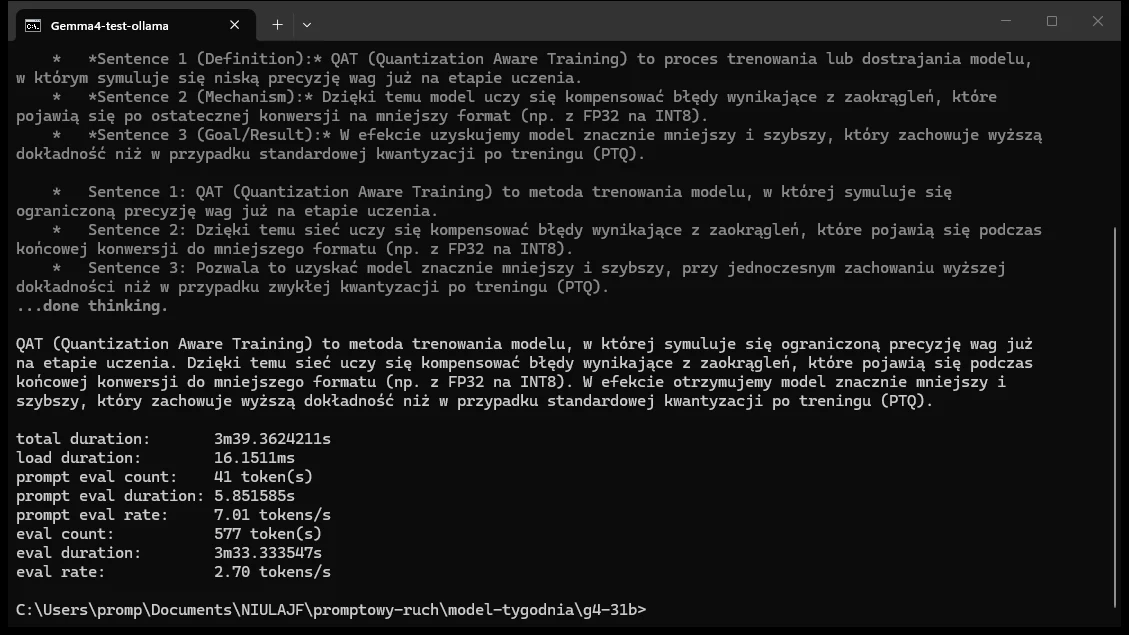
ollama run gemma4:31b-it-qat --verbose "Spiega in 3 frasi semplici che cos'e la quantizzazione QAT."
L’argomento
--verbosemostra in chiusura il valore “eval rate”, ovvero i token al secondo generati. Se vuoi escludere il reasoning interno usa il parametro--think=false. - Verifica l’allocazione della VRAM:
ollama ps
nvidia-smi
Nel prospetto di Ollama la colonna PROCESSOR deve indicare “100% GPU”. Qualora compaia una suddivisione CPU/GPU, riduci la finestra di contesto oppure chiudi gli altri software che usano la scheda video.
- Query con contesto esteso via API (metodo usato per i dati in tabella):
curl http://127.0.0.1:11434/api/chat -d "{"model":"gemma4:31b-it-qat","messages":[{"role":"user","content":"Ciao"}],"think":false,"options":{"num_ctx":32768}}" - Scarica il modello dalla memoria al termine del lavoro:
ollama stop gemma4:31b-it-qat
A chi conviene Gemma 4 31B in locale
- Scelta consigliata se possiedi una GPU da 24 GB (RTX 4090, 3090 o 5090) e cerchi un modello linguistico di alto profilo per elaborare testi senza trasmettere informazioni verso servizi cloud esterni.
- Scelta consigliata per la gestione di documenti riservati, compiti di revisione e sintesi complesse: i circa 42 tok/s offrono una velocita eccellente.
- Scelta sconsigliata se la tua scheda dispone di 16 GB o meno: in questo caso e preferibile Gemma 4 12B, che nei nostri precedenti test si e rivelata molto agile e circa 2,5 volte piu rapida.
- Scelta sconsigliata se vuoi eseguire in parallelo sulla medesima GPU flussi di generazione grafica o rendering video.
Tutti gli altri modelli locali per testo, immagini e video sono catalogati nella nostra guida all’AI in locale; per verificare quanta memoria serve a seconda dei parametri, consulta la nostra analisi su quanta VRAM serve per i modelli AI.
Domande frequenti
Quanta VRAM serve per eseguire Gemma 4 31B?
Nella variante QAT a 4 bit, Ollama alloca 19,2 GB con contesto a 8.000 token e 19,3 GB a 32.000 token. Tenendo conto dei carichi minimi del sistema operativo, il consumo effettivo della GPU raggiunge 24 GB: serve quindi una scheda dedicata da 24 GB senza altri processi grafici attivi.
Gemma 4 31B puo girare su una RTX 4090?
Si, viene caricata al 100% sulla memoria della scheda, generando tra 40 e 43 token al secondo. E essenziale che nessun’altra applicazione occupi VRAM: condividendo la scheda con tool come ComfyUI la velocita puo precipitare tra 0,5 e 2,7 tok/s.
Come si comporta Gemma 4 31B con compiti linguistici complessi?
I risultati sono di primo livello: ha ottenuto 9,5 su 10 nelle nostre prove strutturate, gestendo compiti logici e conteggi senza errori. L’unica sbavatura e stata l’omissione di un cognome nell’intestazione di una lettera formale.
La licenza di Gemma 4 consente usi commerciali?
Si, il rilascio sotto licenza Apache 2.0 autorizza l’utilizzo commerciale, la modifica del modello e la redistribuzione dei pesi modificati.
Perche Ollama va in timeout caricando Gemma 4 31B?
La causa piu frequente e la lentezza dell’unita di archiviazione: il timeout predefinito di Ollama e pari a 5 minuti. Puoi incrementarlo tramite la variabile d’ambiente OLLAMA_LOAD_TIMEOUT=30m oppure spostare i file su una memoria NVMe veloce. Una seconda causa e la memoria grafica insufficiente per via di altri software attivi sulla GPU.
Meglio scegliere Gemma 4 31B oppure Gemma 4 12B?
Con una GPU da 24 GB, 31B offre una qualita di comprensione superiore. Con schede di taglio inferiore o qualora la priorita assoluta sia la rapidita di generazione, 12B e la scelta piu indicata (104 tok/s con circa 8 GB di memoria nei nostri rilevamenti).
Fonti e data di verifica
- Scheda del modello Gemma 4 31B su Hugging Face (dati tecnici, licenza e parametri operativi).
- Libreria Ollama: tag di gemma4.
- Dati rilevati sul banco di prova della redazione (RTX 4090 24 GB, Windows 11, Ollama 0.40.1), 8 ottobre 2026.
More on this from NITIDO

 benchmark·Miniature YouTube con l’AI: test di leggibilità a 320 pixelAbbiamo generato e testato sei miniature per YouTube a 320 pixel di larghezza su smartphone: tre ottime, tre buone e i consigli per renderle efficaci.