ACE-Step 1.5: generatore musica AI locale con voce su RTX 4090
ACE-Step 1.5 è un generatore musicale open source con licenza MIT capace di creare brani completi con voce sul proprio PC. Ho messo alla prova il modello su una RTX 4090 confrontandolo con YuE2, MiniMax Music 3 e DiffRhythm 2.
👁 115 letture
Se cerchi un generatore musica AI locale capace di sintetizzare brani completi di voce e strumenti direttamente sul tuo computer, ACE-Step 1.5 rappresenta una delle soluzioni aperte piu interessanti del momento. Il modello e distribuito con licenza MIT, permettendo l’uso commerciale sia per basi sia per canzoni cantate. Nella mia panoramica sull’AI locale per testo, immagini e video analizzo l’evoluzione di questi strumenti, e il 17 ottobre 2026 ho voluto testare a fondo questo sistema sul mio PC dotato di scheda Nvidia RTX 4090 da 24 GB.
Situazione al 17 ottobre 2026
- ACE-Step 1.5 (sviluppato da ACE Studio e StepFun, pesi diffusi da gennaio 2026, licenza MIT): architettura a diffusione da 2B nei formati turbo, base e SFT, oltre alla variante XL (4B) rilasciata il 2 aprile 2026.
- Planner integrato: modello linguistico basato su Qwen3 declinato nei tagli da 0,6B, 1,7B e 4B.
- Supporto nativo in ComfyUI: template ufficiale disponibile nella sezione Templates con pesi forniti dal repository Comfy-Org.
- Banco di prova: test del 17 ottobre 2026 su Windows 11, RTX 4090 (24 GB VRAM), ComfyUI 0.41, variante ACE-Step 1.5 turbo con planner da 1,7B, valutazione della precisione vocale tramite Whisper large-v3.
Che cos’e ACE-Step 1.5
ACE-Step 1.5 trasforma un prompt descrittivo sullo stile e un testo con metrica in un file stereo completo di arrangiamento e traccia vocale. L’architettura si divide in due componenti principali: un modello linguistico leggero (il planner) che pianifica la struttura musicale e la scandisce in codici sonori, e un modello a diffusione da 2 miliardi di parametri che ricostruisce il segnale audio vero e proprio.
Gli autori dichiarano la capacita di generare da brevi loop di pochi secondi fino a composizioni da 10 minuti, con supporto a oltre 50 lingue testuali e la possibilita teorica di funzionare su schede con meno di 4 GB di VRAM tramite quantizzazione int8 e offloading sulla memoria di sistema. Oltre alla generazione da zero, la pipeline supporta cover, repainting di sezioni audio e aggiunta di basi musicali su una traccia vocale isolata.
Il fattore distintivo resta la licenza MIT, che consente l’impiego commerciale delle tracce generate. Si tratta di una caratteristica rara nel panorama dei modelli musicali open weight: YuE2 e vincolato alla licenza non commerciale CC BY-NC 4.0, mentre MiniMax Music 3 locale applica una licenza comunitaria specifica con clausole vincolanti per le aziende. Per la sola generazione strumentale senza traccia cantata, un’alternativa resta Stable Audio 3 con la Stability Community License.
Come installare ed eseguire ACE-Step 1.5 in ComfyUI
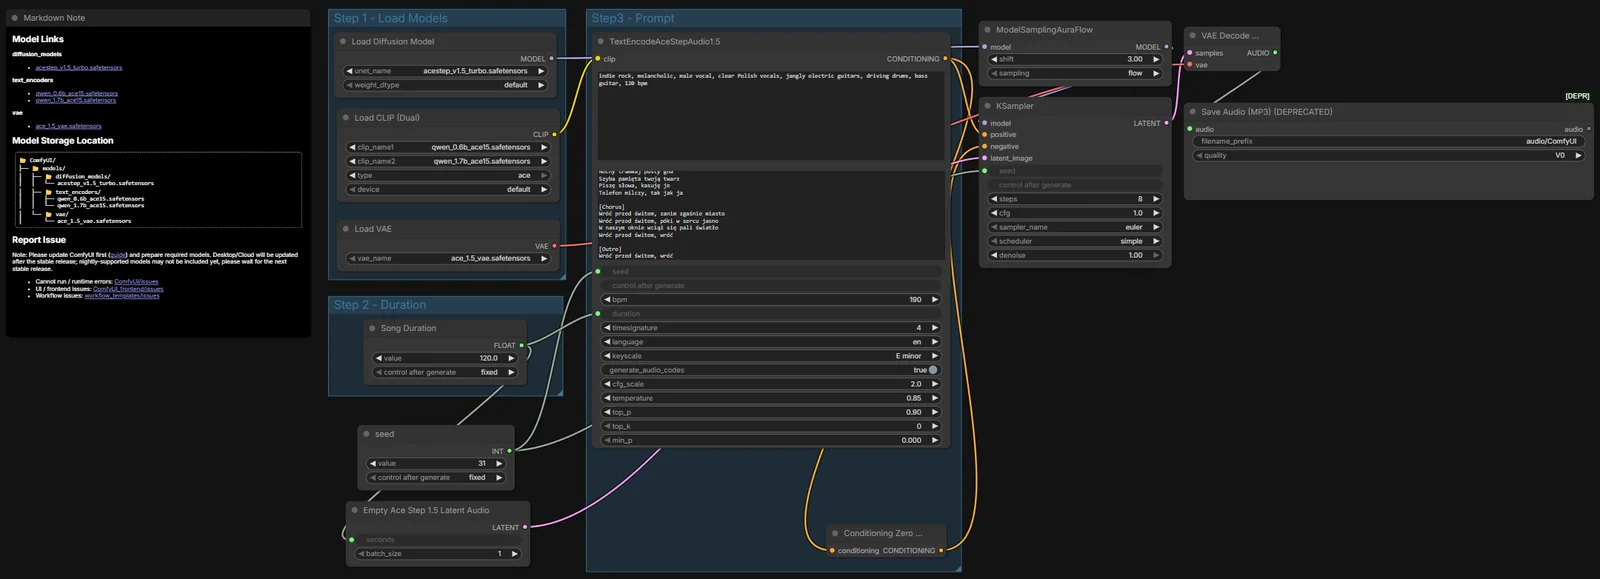
Per eseguire ACE-Step 1.5 sul proprio computer tramite ComfyUI, la procedura manuale richiede il download di quattro file distinti per un totale di circa 10 GB di dati:
- Installa o aggiorna ComfyUI alla versione 0.41 o successiva.
- Nel menu Templates, cerca “ACE-Step 1.5” e carica il template con i file separati (split).
- Scarica i pesi dal repository Hugging Face
Comfy-Org/ace_step_1.5_ComfyUI_filesposizionandoli nelle rispettive cartelle:acestep_v1.5_turbo.safetensors(4,8 GB) dentromodels/diffusion_modelsqwen_0.6b_ace15.safetensors(1,2 GB) eqwen_1.7b_ace15.safetensors(3,7 GB) dentromodels/text_encodersace_1.5_vae.safetensors(0,3 GB) dentromodels/vae
- Nel nodo TextEncodeAceStepAudio1.5, definisci lo stile musicale nei tag, inserisci il testo diviso dai marcatori
[verse]e[chorus], imposta tempo, tonalita e lingua desiderata (il valore predefinito een). - Configura la durata del brano sia nel blocco di testo sia nel nodo EmptyAceStep1.5LatentAudio (nel template predefinito i due parametri sono gia collegati dal nodo unico Song Duration).
- Esegui il workflow cliccando su Run: il file WAV finito verra salvato nella cartella
ComfyUI/output/audio.
Esiste anche la versione XL (4B): secondo gli sviluppatori garantisce una resa sonora superiore, ma il solo modello turbo XL in bf16 richiede 10 GB, a cui si aggiungono 8,4 GB per il planner 4B. Sebbene gestibile sui 24 GB della RTX 4090, su schede da 12 GB richiede necessariamente il ricorso all’offloading su RAM.
Test su RTX 4090: risultati in inglese e prova multilingue
Ho effettuato i benchmark il 17 ottobre 2026 sul mio sistema con RTX 4090, impostando la versione turbo (8 step di campionamento), il planner da 1,7B e una durata target di 120 secondi. La prima verifica ha riguardato un brano synthpop anni ’80 in lingua inglese con voce maschile, mentre la seconda serie di misure ha sfruttato un testo di prova multilingue (una ballata pop di 83 parole scritta in lingua polacca) identico a quello somministrato ad altri modelli locali per valutarne la fedelta fonetica. La trascrizione delle tracce e stata eseguita con Whisper large-v3 per calcolare la percentuale esatta di parole cantate e riconosciute.
| Test | Parole cantate | Tempo totale | Picco VRAM |
|---|---|---|---|
| Inglese (synthpop) | 96,1% (73/76) | 8,0 s | 15,2 GB |
| Prova multilingue (seed 11) | 94,0% (78/83) | 35,2 s | 20,0 GB |
| Prova multilingue (seed 22) | 94,0% (78/83) | 91,4 s | 14,0 GB |
| Prova multilingue (seed 33) | 98,8% (82/83) | 34,1 s | 10,7 GB |
Dall’analisi delle tracce audio emergono alcuni comportamenti tecnici precisi:
- Velocita di elaborazione pura: quando il modello risiede gia nella VRAM della GPU, la generazione di due minuti di musica richiede appena 8 secondi, come registrato nel test in inglese. I tempi piu alti (fino a 91,4 s) dipendono esclusivamente dalla fase in cui ComfyUI scarica e ricarica i diversi pesi in memoria tra un’esecuzione e l’altra.
- Precisione della durata: ACE-Step riceve l’indicazione temporale a monte e restituisce esattamente i 2:00 minuti richiesti, evitando troncature premature.
- Resa fonetica: nella prova multilingue non inglese, la media sulle tre generazioni si e attestata al 95,6% (con un picco del 98,8%). Gli errori rilevati da Whisper hanno riguardato singole consonanti o toponimi complessi, mantenendo comunque l’intelligibilita priva di parole inventate.
Confronto tra 4 modelli: generatore musica AI locale alla prova
Durante la sessione di test ho messo a confronto ACE-Step 1.5 con altri tre sistemi vocali locali: YuE2 (3B), MiniMax Music 3 e DiffRhythm 2. Il benchmark ha previsto sia l’esecuzione del testo in lingua inglese sia il medesimo testo multilingue su tre seed differenti (11, 22, 33).
| Modello | Inglese (riconoscimento) | Test multilingue (media) | Licenza d’uso |
|---|---|---|---|
| ACE-Step 1.5 turbo | 96,1% | 95,6% | MIT (commerciale si) |
| YuE2 (3B, bf16) | 100% | 91,2% | CC BY-NC 4.0 (solo non commerciale) |
| MiniMax Music 3 | 92,1% | 89,2% | MiniMax Community (con vincoli) |
| DiffRhythm 2 | 100% | 4,8% | Apache 2.0 (commerciale si) |
Nel test in lingua inglese con stile synthpop, YuE2 e DiffRhythm 2 hanno ottenuto il 100% di parole riconosciute coprendo circa due minuti di brano in 32 secondi (YuE2) e circa 1 minuto (DiffRhythm 2). ACE-Step 1.5 si e posizionato subito dietro con il 96,1% ma con un tempo di generazione imbattibile di appena 8 secondi. MiniMax Music 3 ha raggiunto il 92,1% impiegando ben 305 secondi.
Nell’analisi sui testi non inglesi, invece, emergono differenze strutturali importanti tra le architetture:
- ACE-Step 1.5 turbo: e risultato il piu costante (94,0%, 94,0%, 98,8%), grazie alla presenza del selettore esplicito della lingua nel nodo di codifica.
- YuE2: ha registrato la singola prova migliore (98,8%), ma anche un calo vistoso a 84,3% con ripetizioni di intere frasi nel seed 22 e salti di testo nel seed 33, richiedendo piu tentativi per selezionare la traccia ideale.
- MiniMax Music 3: ha mostrato una tendenza a invertire le strofe e ha troncato la durata dei brani (73, 111 e 92 secondi a fronte di un limite di 150), saturando l’intera VRAM da 24 GB.
- DiffRhythm 2: non possiede un vocabolario fonetico al di fuori di inglese e cinese, degradando l’audio a un insieme incomprensibile (4,8%).
Quale modello scegliere
La scelta del modello dipende dalle tue esigenze operative, hardware e legali:
- Per produzioni commerciali e jingle rapidi: ACE-Step 1.5 turbo e la scelta di riferimento. La licenza MIT garantisce piena liberta d’uso commerciale e la rapidita (8 secondi a regime) permette di generare decine di varianti a costo zero.
- Per la massima articolazione in inglese (uso personale): YuE2 offre un cantato eccellente in inglese (100% nel test), ma la licenza CC BY-NC 4.0 ne vieta tassativamente l’impiego per fini di lucro.
- Per tracce lunghe o sonorita particolari: MiniMax Music 3 puo essere valutato solo se disponi di 24 GB di VRAM dedicati e accetti tempi di attesa sensibilmente superiori, ricordando che la sua licenza comunitaria richiede l’attribuzione esplicita e impone accordi commerciali separati per entrate superiori a 20 milioni di USD.
Domande frequenti
ACE-Step 1.5 puo essere utilizzato per scopi commerciali?
Si, il modello e distribuito con licenza MIT che consente l’impiego commerciale delle tracce generate. Ricorda tuttavia che le piattaforme di distribuzione streaming possono applicare regolamenti interni propri per i contenuti generati tramite intelligenza artificiale, fermo restando che il testo originale da te composto rimane di tua proprieta.
Quanta memoria VRAM richiede ACE-Step 1.5?
Durante le mie prove su RTX 4090, il picco di memoria grafica occupata dall’intero ambiente ComfyUI e variato tra 10,7 e 20,0 GB. Secondo la documentazione ufficiale, il modello 2B turbo puo girare su GPU fino a 6 GB tramite quantizzazione int8 e offloading, richiede tra gli 8 e i 16 GB per il funzionamento ottimale con planner fino a 1,7B, mentre il formato XL richiede tra i 20 e i 24 GB per evitare l’offloading su RAM.
Quale differenza c’e tra le varianti turbo, base e SFT?
La versione turbo opera con 8 step di campionamento ed e progettata specificamente per garantire la massima velocita di generazione in ambito locale. Le varianti base e SFT (Supervised Fine-Tuning) lavorano a 50 step per offrire un dettaglio sonoro piu elevato a fronte di tempi di calcolo maggiori, con la variante SFT ulteriormente ottimizzata per la qualita complessiva.
ACE-Step 1.5 supporta lingue diverse dall’inglese?
Si, l’architettura supporta oltre 50 lingue testuali selezionabili tramite l’apposito parametro nel blocco di codifica. Nel mio test comparativo su un testo multilingue non inglese, il modello ha ottenuto una media di riconoscimento vocale del 95,6%, dimostrando di saper gestire correttamente l’articolazione delle parole purché venga impostato il codice linguistico opportuno.
Come impostare il testo della canzone per ottenere una voce chiara?
E consigliabile strutturare il brano alternando strofe e ritornelli su righe separate tramite le etichette standard come [verse] e [chorus]. Funzionano meglio i versi con una metrica regolare e un numero simile di sillabe, limitando i toponimi insoliti o sequenze fitte di consonanti che possono indurre il modello in errore di pronuncia.
Fonti
- Repository ufficiale ACE-Step 1.5 su GitHub (licenza MIT).
- Scheda modello ACE-Step/Ace-Step1.5 su Hugging Face.
- Pesi e configurazioni Comfy-Org/ace_step_1.5_ComfyUI_files.
- Scheda del modello m-a-p/YuE2-3B (licenza CC BY-NC 4.0).
- Scheda MiniMaxAI/MiniMax-Music3 (MiniMax-Music3 Community License).
- Repository DiffRhythm 2 su GitHub (licenza Apache 2.0).
Verificato il 17 ottobre 2026.
More on this from NITIDO