Muse Wonder vs Opus 5.5 e GPT-6 Astra: test su 23 task
Abbiamo messo alla prova Muse Wonder contro Claude Opus 5.5, GPT-6 Astra, Fable 5.1 e Gemini 3.8 Flash su 23 compiti reali. Ecco costi, velocita ed errori.
Aggiornamento (9 novembre 2026): sono usciti Claude Fable 5.2 e Mythos 5.2 - prezzi, accesso e benchmark nella mia guida a Claude Fable 5.2.
👁 113 letture
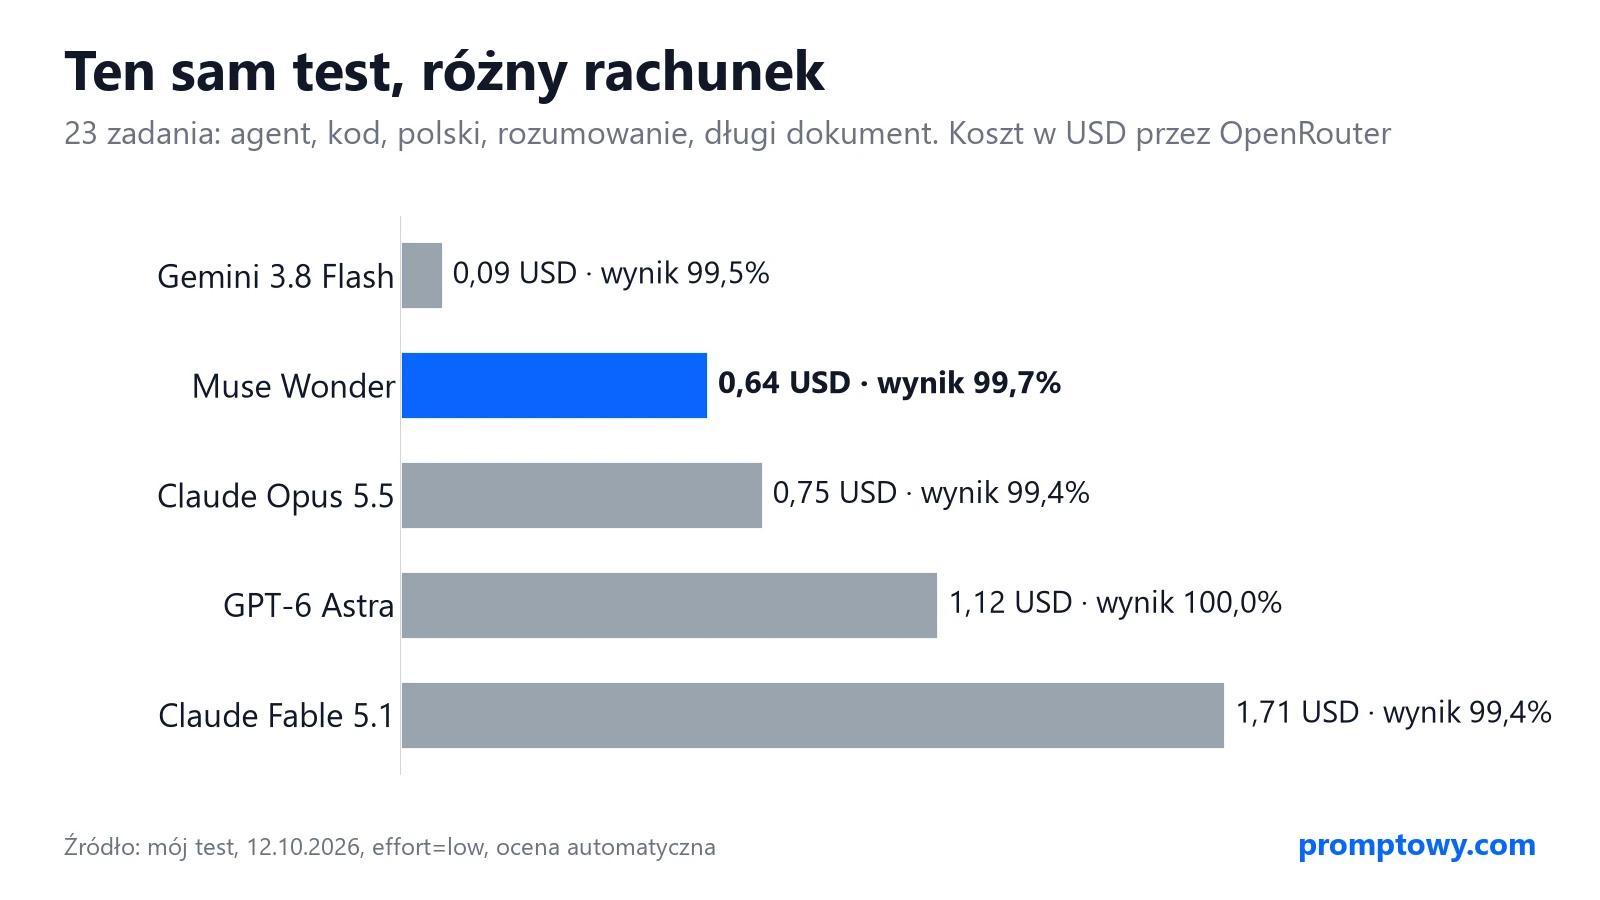
Abbiamo sottoposto Muse Wonder e quattro concorrenti diretti agli stessi 23 task pratici: workflow da agenti con tool, codice verificato da unit test, testi complessi, compiti di logica e l’analisi di un documento da 47-88 mila token. Il verdetto ci ha sorpreso piu dei benchmark diffusi da Meta: su compiti realistici tutti e cinque i modelli hanno ottenuto tra il 99% e il 100%. Le vere discrepanze emergono sui costi di calcolo, sui tempi di risposta e su piccoli incidenti di percorso. Muse Wonder si e piazzato come secondo piu economico e secondo piu rapido. Di seguito trovi tutti i dati, i grafici e gli errori rilevati, mentre l’analisi del modello e disponibile nella nostra guida Muse Wonder.
Gli importi in EUR sono conversioni indicative dei prezzi pubblicati in USD, calcolate al cambio di riferimento BCE del 2026-10-12: 1 EUR = 1.1181 USD. Non sono prezzi locali confermati né importi finali comprensivi di imposte. Il fornitore e la banca possono applicare altri cambi o commissioni. ECB.
I dettagli del test: sessione serale del 12 ottobre 2026
- Modelli esaminati: Muse Wonder, Claude Opus 5.5, Claude Fable 5.1, GPT-6 Astra, Gemini 3.8 Flash. Tutti interrogati via OpenRouter, con livello di reasoning impostato su low.
- 23 task distribuiti su due sessioni, con valutazione interamente automatizzata (unit test, verifica formale dei tool call, confronto esatto dei dati estratti), senza l’uso di un LLM come giudice.
- Benchmark aggiuntivo sulle allucinazioni bibliografiche (16 citazioni accademiche richieste a ciascun modello, verificate su Crossref e OpenAlex).
- Costo totale dell’esperimento: 5,04 USD. Log completi e risposte grezze archiviati nei log di test.
I risultati del confronto in sintesi
| Modello | Punteggio (23 task) | Costo | Tempo totale | Fonti autentiche | Errori rilevati |
|---|---|---|---|---|---|
| Muse Wonder | 99,7% | 0,5724 EUR (0,64 USD) | 165 s | 16/16 | refuso nel codice numerico („trzynadzieście”) |
| Claude Opus 5.5 | 99,4% | 0,6708 EUR (0,75 USD) | 222 s | 16/16 | sintesi oltre il limite di parole |
| Claude Fable 5.1 | 99,4% | 1,53 EUR (1,71 USD) | 263 s | 16/16 | sintesi oltre il limite di parole |
| GPT-6 Astra | 100% | 1,00 EUR (1,12 USD) | 200 s | 16/16 | nessuno |
| Gemini 3.8 Flash | 99,5% | 0,0805 EUR (0,09 USD) | 139 s | 7/16* | festivita applicata retroattivamente anche al 2024 |
Il punteggio finale rappresenta la media su 23 task, ciascuno con identico peso (per gli esercizi articolati su piu requisiti si calcola la percentuale dei criteri soddisfatti). * Il dato sulle fonti per Gemini 3.8 Flash deriva da una nostra rilevazione precedente condotta il 12 ottobre con il medesimo prompt.
Cosa abbiamo testato nello specifico
| Categoria | Task assegnati | Metodo di valutazione |
|---|---|---|
| Agenti e function calling | organizzazione viaggio (3 tool, 4 vincoli di budget e orario), gestione resi e-commerce (blocco richieste fuori termine), calcolo fatture in valuta con simulazione di timeout alla prima chiamata API | validita delle chiamate, coerenza delle scelte, precisione numerica |
| Generazione codice | validazione codice fiscale aziendale, unione di intervalli temporali, calcolo giorni lavorativi con nuove normative festive, conversione di cifre in parole | suite di unit test locali (da 8 a 19 asserzioni per task) |
| Elaborazione linguistica | correzione di 10 errori ortografici, sintesi in 3 punti entro 60 parole, ricorso formale verso un ente previdenziale, declinazione di toponimi e cognomi complessi (abbiamo testato la lingua polacca) | checklist formale dei punti chiave e forme grammaticali esatte |
| Ragionamento logico | 11 quesiti con esito deterministico (calcolo combinatorio, quesiti di calendario, enigmi di logica pura) | corrispondenza esatta della soluzione finale |
| Contesto lungo | fascicolo da 80 verbali societari con 5 domande mirate, incluse delibere modificate nel tempo e richieste su dettagli del tutto assenti | accuratezza puntuale delle risposte estratte |
Task reali: i modelli top di gamma ormai si equivalgono
Nella pianificazione del viaggio tutti e cinque i modelli hanno gestito le chiamate ai tool in parallelo (4 chiamate suddivise in 2 turni), scartato il volo economico delle 06:05 perche incompatibile con i vincoli, evitato l’hotel con punteggio 7,4 e calcolato la stessa spesa complessiva. Nel flusso dei resi nessuno ha autorizzato la pratica scaduta da 32 giorni. Nel recupero dei tassi di cambio hanno gestito il retry dopo l’errore del server, ignorato la fattura gia saldata e restituito la cifra esatta. Tutti hanno inoltre rilevato che l’informazione su una campagna TikTok non compariva nell’archivio e che i metri quadri del magazzino erano stati rettificati in un verbale successivo. E un ottimo segnale per chi sviluppa: su task di questo tipo il sovrapprezzo dei modelli piu blasonati compra spesso solo il marchio, non una reale efficacia superiore.
Dove emergono le differenze
I consumi: Muse Wonder costa meno di Opus a parita di tariffa per token
Sulla carta Muse Wonder e Claude Opus 5.5 presentano lo stesso costo nominale: 3,58 EUR (4 USD) per milione di token in input e 17,89 EUR (20 USD) per milione in output. Nonostante questo, l’esecuzione su Opus e risultata piu onerosa del 18%. La ragione risiede nel tokenizer: analizzando un testo lungo di prova, Meta ha impiegato 46.929 token, Gemini 53.511, GPT-6 Astra 55.371, mentre le architetture Anthropic ne hanno conteggiati ben 87.675. Il tokenizer di Claude mappa le lingue diverse dall’inglese con un’efficienza sensibilmente inferiore rispetto a Meta. Su documenti lunghi questo gap pesa sul bilancio: una singola interrogazione sugli 80 verbali e costata 0,1699 EUR (0,19 USD) con Muse Wonder, 0,3130 EUR (0,35 USD) con Opus 5.5 e 0,7870 EUR (0,88 USD) con Fable 5.1.
| Modello | Token necessari per lo stesso testo | Costo per singola domanda sul documento |
|---|---|---|
| Muse Wonder | 46 929 | 0,1699 EUR (0,19 USD) |
| Gemini 3.8 Flash | 53 511 | 0,0358 EUR (0,04 USD) |
| GPT-6 Astra | 55 371 | 0,6171 EUR (0,69 USD) |
| Claude Opus 5.5 | 87 675 | 0,3130 EUR (0,35 USD) |
| Claude Fable 5.1 | 87 675 | 0,7870 EUR (0,88 USD) |
Sui prompt brevi accade l’opposto: Muse Wonder genera una quantita consistente di token di ragionamento anche con il parametro impostato su low (nella pianificazione del viaggio ha consumato 636 token interni contro i soli 46 di Opus), risultando a tratti leggermente piu caro sulle richieste secche.
Velocita di risposta
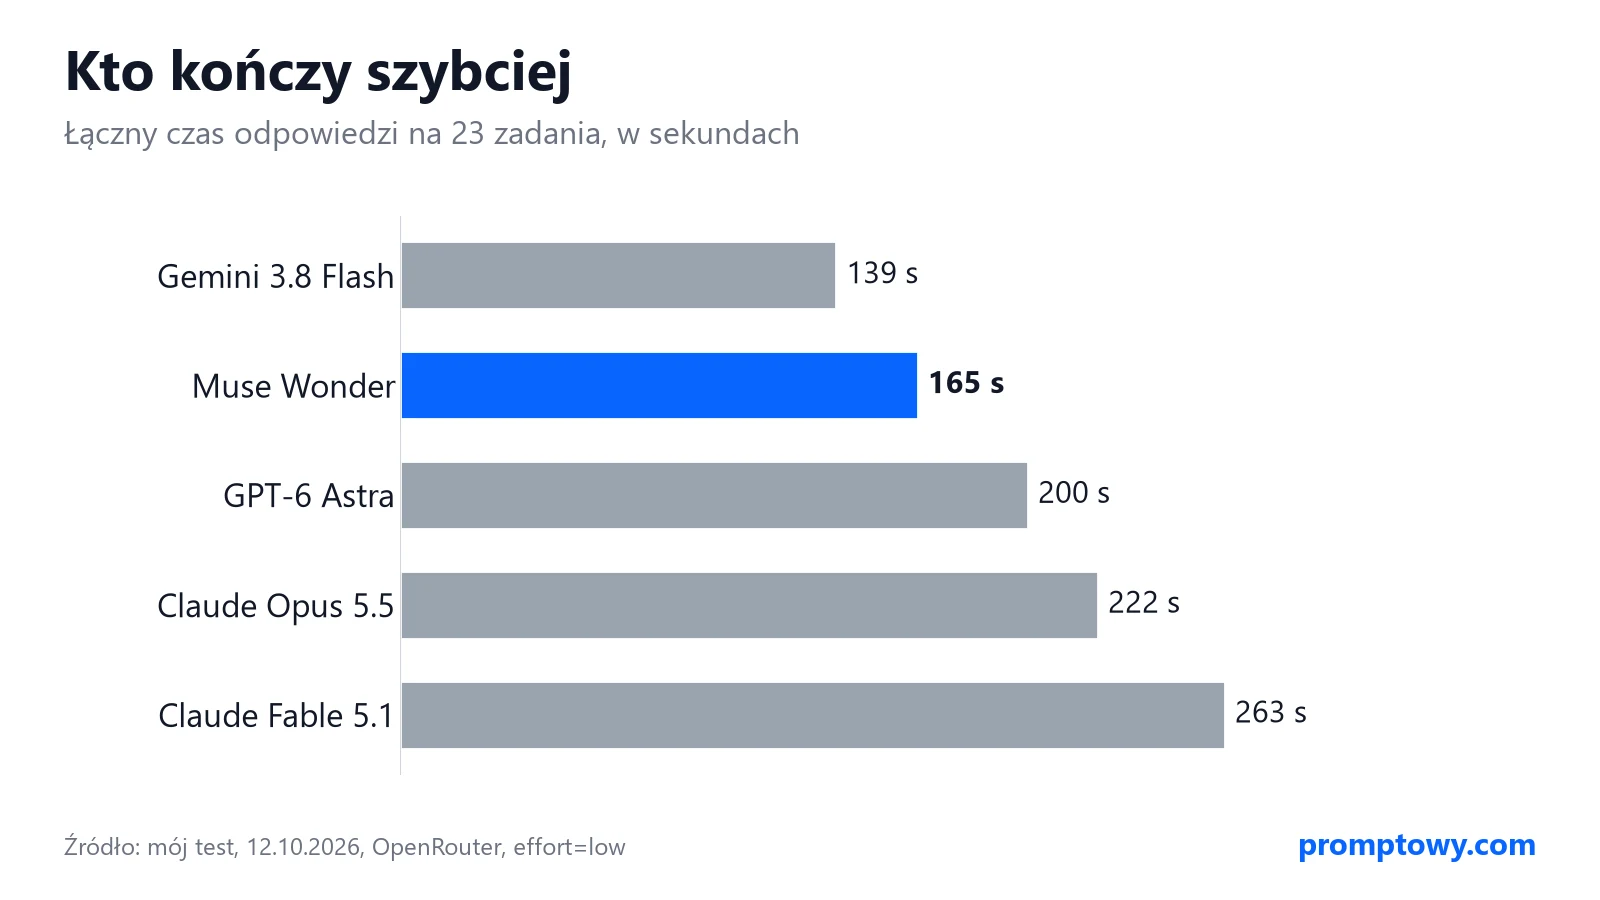
Il modello piu lento e stato Fable 5.1: per redigere il ricorso previdenziale ha impiegato 80 secondi con un costo di 0,2504 EUR (0,28 USD); Muse Wonder ha prodotto l’atto in appena 12 secondi con una spesa di 0,03 USD.
Gli errori emersi durante i controlli
- Muse Wonder e il refuso nella logica numerica. Nella funzione per convertire importi numerici in lettere, il modello ha inserito un termine errato nell’array delle unita (abbiamo condotto il test in polacco: „trzynadzieście”, un neologismo inesistente). 15 test su 16 sono passati, ma un importo e uscito scorretto. In un documento contabile ufficiale sarebbe stato un errore critico.
- Muse Wonder e la data inventata nell’atto. Nel testo legale per il ricorso ha indicato autonomamente una data esatta non fornita nel prompt („14 października 2026 r.”, ossia il 14 ottobre 2026). Gli altri modelli hanno lasciato un campo vuoto tra parentesi quadre. Pur non avendo penalizzato il punteggio, e un’abitudine da monitorare nei flussi automatizzati.
- Claude Opus 5.5 e Fable 5.1 fuori vincolo di lunghezza. La sintesi imponeva un tetto massimo di 60 parole: i modelli Anthropic ne hanno generate rispettivamente 62 e 66. Muse Wonder ha rispettato esattamente quota 60 parole, mentre GPT-6 Astra si e fermato a 59.
- Gemini 3.8 Flash e l’anacronismo sui giorni festivi. Ha applicato una legge sull’estensione dei giorni non lavorativi a ritroso su tutti gli anni, sebbene la norma decorresse solo a partire dal 2025. Il test relativo al mese di dicembre 2024 e dunque fallito.
Allucinazioni nei riferimenti bibliografici
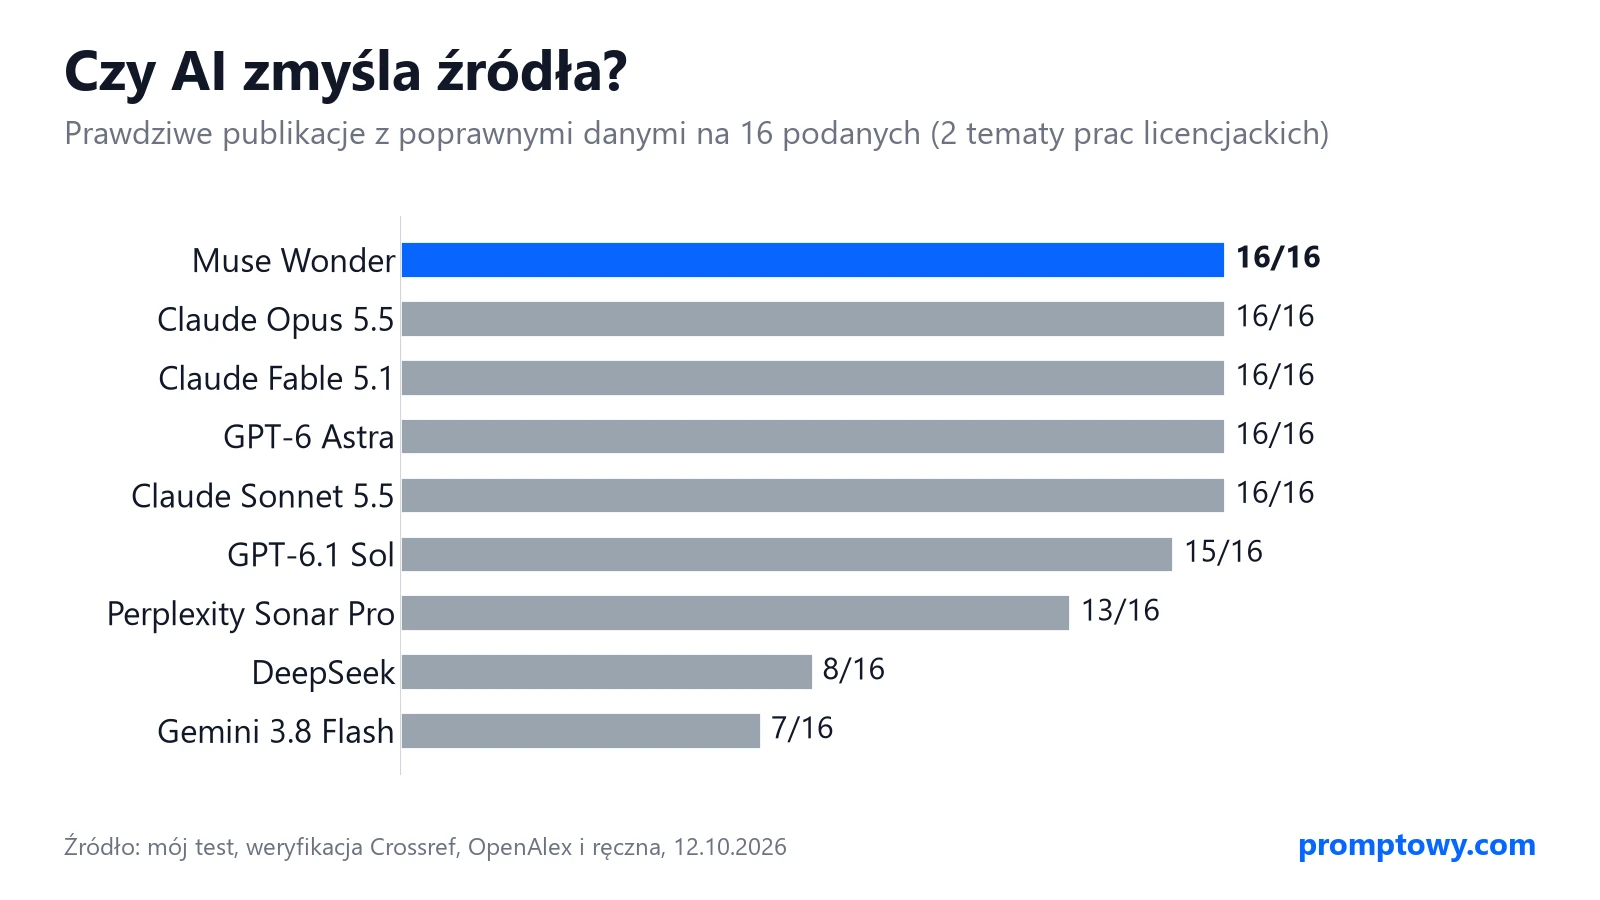
Abbiamo richiesto 8 riferimenti accademici per tesi di laurea su due ambiti: l’impatto dei social network sugli adolescenti e i modelli di bilancio partecipativo. Abbiamo controllato ogni voce su Crossref e OpenAlex, verificando manualmente le quattro pubblicazioni locali non indicizzate (rapporti istituzionali di centri studi e una rivista accademica francese, Métropoles). Tutte le pubblicazioni sono risultate autentiche ed esistenti. Muse Wonder, Opus 5.5, Fable 5.1 e GPT-6 Astra hanno ottenuto un perfetto 16 su 16. Nelle nostre verifiche precedenti Gemini 3.8 Flash si era fermato a 7 fonti reali su 16 con il medesimo prompt, inventando completamente i riferimenti locali. I modelli ultra-economici sono ideali per flussi operativi, ma inaffidabili nella ricerca bibliografica.
Confronto con i benchmark di Meta e i test di scrittura
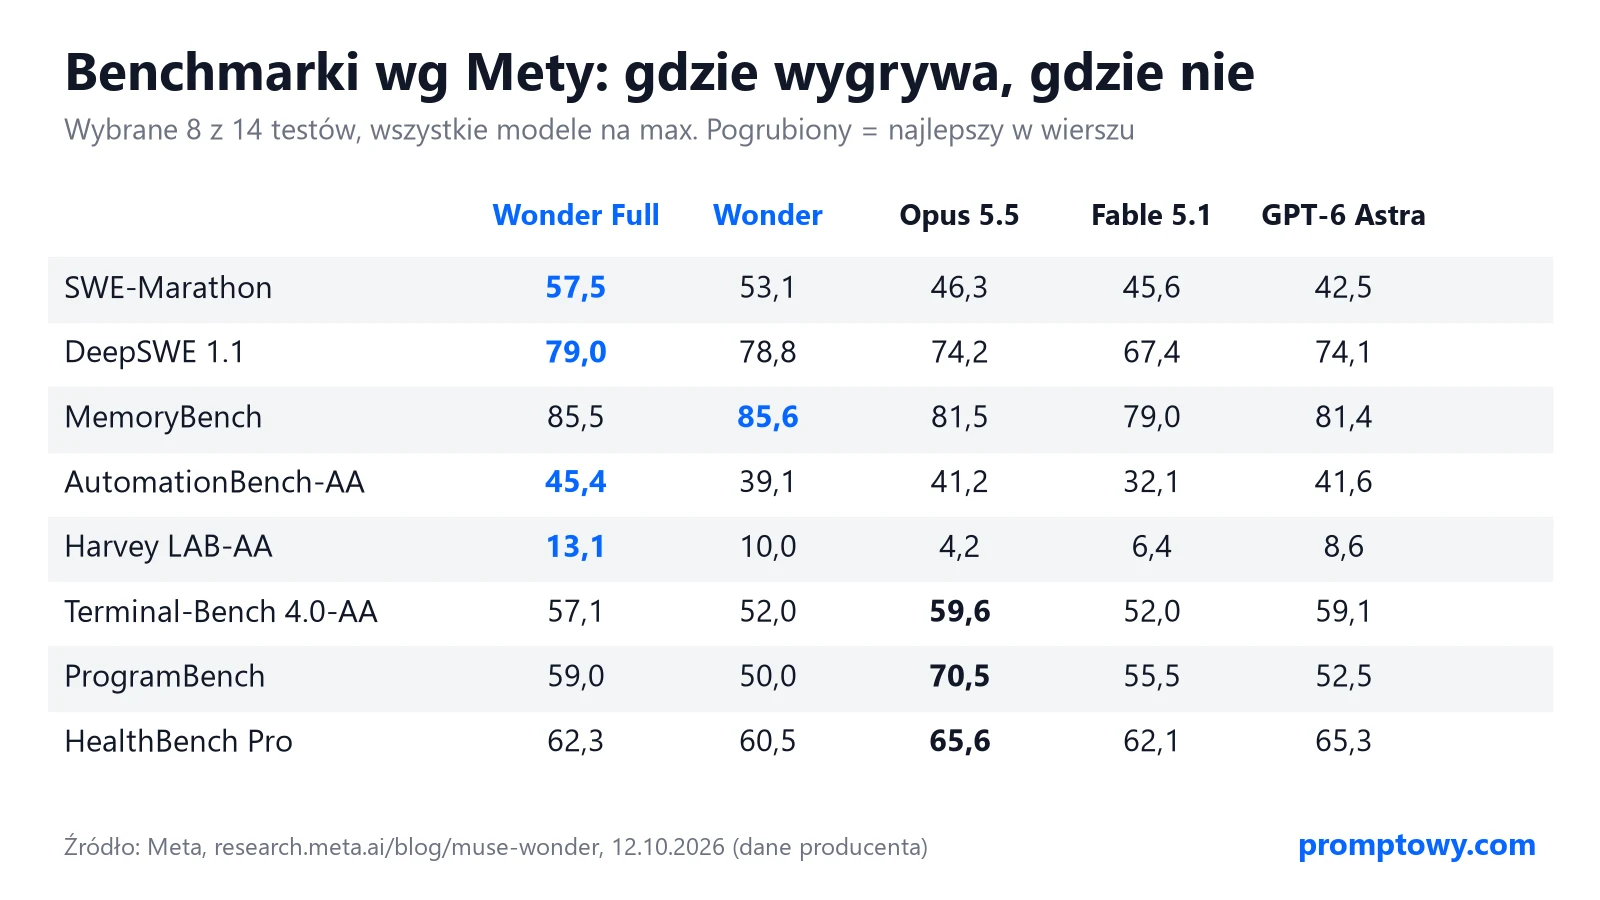
Nelle tabelle ufficiali Meta evidenzia un vantaggio di Muse Wonder Full nei compiti di programmazione estesa e nei workflow agenziali complessi, registrando invece punteggi inferiori a Opus 5.5 su ProgramBench, Terminal-Bench e HealthBench Pro. Le nostre sessioni hanno valutato la versione standard di Muse Wonder distribuita via API: su progetti di questa dimensione pratica i due modelli marciano affiancati. Nei test di scrittura pura con valutazione cieca (testati in polacco), le distanze si ampliano: Muse Wonder ha ottenuto 87,0 punti, Opus 5.5 90,1, Astra 85,3 e Fable 5.1 83,9; i dati dettagliati si trovano nella guida Muse Wonder po polsku.
I limiti metodologici del nostro test
- Ogni prova e stata eseguita con una singola esecuzione per task. Quando i modelli si attestano tra il 99% e il 100%, l’errore su un singolo caso e statistica occasionale, non un gap strutturale.
- Livello di reasoning impostato su low per tutti i modelli, per garantire parita di condizioni e limitare i costi. Portando il reasoning al livello massimo i consumi e le prestazioni muterebbero sensibilmente.
- I task riflettono esigenze operative quotidiane, non problemi di frontiera. Per testare i limiti architetturali (sessioni di programmazione su repository complesse, matematica avanzata) occorrono batterie di test dedicate, come quelle pubblicate da Artificial Analysis.
- Valutazione puramente deterministica: abbiamo verificato la correttezza dei dati e la forma logica, non la piacevolezza dello stile di scrittura.
Il nostro giudizio
Se utilizzi le API per integrare workflow agenziali, manipolazione di dati e analisi di testi, Muse Wonder offre le medesime garanzie operative di Opus 5.5, Fable 5.1 o GPT-6 Astra. Su testi lunghi in lingue diverse dall’inglese risulta molto piu economico grazie all’efficienza del suo tokenizer. Sul piano del puro rapporto qualita-prezzo Gemini 3.8 Flash resta imbattibile, a patto di non delegargli la ricerca di citazioni o fonti bibliografiche. Questo quadro fotografa lo stato delle API rilevato nella nostra sessione di test del 12 ottobre 2026.
Domande frequenti
Quale modello ha ottenuto il punteggio piu alto?
GPT-6 Astra ha raggiunto il 100%, Muse Wonder il 99,7%, Gemini 3.8 Flash il 99,5%, seguiti da Claude Opus 5.5 e Fable 5.1 con il 99,4%. Le distanze sono minime e legate a singoli dettagli operativi.
Muse Wonder e davvero piu economico di Claude Opus 5.5?
Il prezzo di listino per token e identico, ma Muse Wonder tokenizza i testi non inglesi in un numero inferiore di token. Nei nostri 23 task la spesa e stata di 0,5724 EUR (0,64 USD) contro 0,6708 EUR (0,75 USD) di Opus, e per l’analisi del documento lungo il conto e stato di 0,1699 EUR (0,19 USD) contro 0,35 USD.
Muse Wonder inventa le fonti accademiche?
Nel nostro benchmark ha ottenuto 16 riscontri positivi su 16, senza produrre alcuna allucinazione bibliografica.
Fonti e metodologia
- Nostra sessione di benchmark via OpenRouter, 12 ottobre 2026: 23 task, reasoning impostato su low, verifica deterministica tramite unit test e controllo del function calling
- Verifica delle citazioni bibliografiche: controlli incrociati su Crossref e OpenAlex, con riscontri manuali sulle pubblicazioni locali
- OpenRouter: tariffario ufficiale dei modelli
- Meta AI Research: documentazione ufficiale e benchmark di Muse Wonder
- Artificial Analysis: classifiche indipendenti dei modelli
More on this from NITIDO

 magazine·Muse Wonder prezzo: costi API, piani e confrontiAnalisi dettagliata del prezzo di Muse Wonder tra tariffe API per token e piani Muse Code, a confronto con le alternative di mercato.