// modelli di frontiera
Muse Wonder: scheda tecnica, prezzi e benchmark
Muse Wonder è un modello di frontiera sviluppato da Meta per compiti agentici personali e professionali, successore di Muse Spark. Accetta input di testo, immagini, video, audio e PDF con una finestra di contesto pari a 1.048.576 token. È accessibile a sviluppatori e professionisti tramite API e nell'ambiente Muse Code.
Prezzi dell'API di Muse Wonder
| model | input / 1M | output / 1M | context |
|---|---|---|---|
| Muse Wonder | $4 | $20 | 1,048,576 |
Le tariffe derivano da un'istantanea di OpenRouter e possono cambiare nel tempo. (2026-10-12 19:54:27)
Confronto con i modelli concorrenti
| model | input / 1M | output / 1M | context |
|---|---|---|---|
| Muse Wonder | $4 | $20 | 1,048,576 |
| Claude Opus 5.5 | $4 | $20 | 1,000,000 |
| Claude Fable 5.1 | $10 | $50 | 1,000,000 |
| GPT-6 Astra | $10 | $50 | 1,050,000 |
| Gemini 4 Argon | $2 | $10 | 1,000,000 |
Per quanto riguarda il prezzo di output per milione di token, Gemini 4 Argon rappresenta l'opzione più economica con 10 USD, mentre Claude Fable 5.1 e GPT-6 Astra sono le più costose a 50 USD.
Muse Wonder vs Muse Wonder Full
- Muse Wonder - disponibile tramite la Meta Model API (ID modello muse-wonder-1.0), in Muse Code e su OpenRouter (meta/muse-wonder). Prezzo: 4 USD per 1 milione di token in input, 20 USD per 1 milione in output.
- Muse Wonder Full - la variante più potente, senza API. Disponibile solo in Muse Code con i piani Power Usage (50 USD al mese) e Maximum Usage (200 USD al mese).
- Impostare il livello di ragionamento su "max" non trasforma Muse Wonder in Muse Wonder Full - sono modelli distinti.
- Finestra di contesto: 1.048.576 token. Input: testo, immagini, video, audio e PDF. Output: testo.
Benchmark secondo Meta
Dati pubblicati da Meta il 12 ottobre 2026, tutti i modelli al livello massimo di ragionamento. Sono misurazioni del produttore, non test indipendenti.
| benchmark | Muse Wonder Full | Muse Wonder | Claude Fable 5.1 | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|---|---|---|
| Personal Superintelligence Index | 59.1 | 54.3 | 49.9 | 54.5 | 55.2 |
| Harvey LAB-AA | 13.1 | 10.0 | 6.4 | 8.6 | 4.2 |
| Vals Finance Agent V2 | 59.1 | 56.6 | 58.9 | 53.5 | 58.6 |
| HealthBench Pro | 62.3 | 60.5 | 62.1 | 65.3 | 65.6 |
| AutomationBench-AA | 45.4 | 39.1 | 32.1 | 41.6 | 41.2 |
| GDP.pdf | 33.2 | 30.8 | 27.6 | 34.2 | 30.6 |
| JobBench | 75.3 | 70.5 | 73.1 | 66.1 | 75.4 |
| OSWorld V2.1 (partial) | 78.4 | 72.6 | 80.7 | 75.8 | 81.8 |
| OSWorld V2.1 (binary) | 39.4 | 34.3 | 43.1 | 34.3 | - |
| MemoryBench | 85.5 | 85.6 | 79.0 | 81.4 | 81.5 |
| Terminal-Bench 4.0-AA | 57.1 | 52.0 | 52.0 | 59.1 | 59.6 |
| DeepSWE 1.1 | 79.0 | 78.8 | 67.4 | 74.1 | 74.2 |
| SWE-Marathon | 57.5 | 53.1 | 45.6 | 42.5 | 46.3 |
| ProgramBench | 59.0 | 50.0 | 55.5 | 52.5 | 70.5 |
Classifica indipendente: Artificial Analysis Intelligence Index
- Claude Opus 5.5 - 58
- Muse Wonder Full - 56
- Claude Fable 5.1 - 53
- GPT-6 Astra - 53
- Gemini 4 Argon - 53
- Muse Wonder - 52
Classifica al 12 ottobre 2026. Lo stesso giorno Muse Wonder non aveva ancora una posizione su LMArena.
Il nostro test
Abbiamo fatto un nostro test il giorno del lancio, il 12 ottobre 2026: 23 compiti inviati tramite OpenRouter con livello di ragionamento low per tutti i modelli, valutazione automatica (unit test eseguiti in locale, controllo delle chiamate agli strumenti, risposte esatte), una sola esecuzione per compito e nessun giudice IA. Il set comprendeva 3 compiti da agente con strumenti, 4 compiti di programmazione con unit test, 4 compiti di scrittura in polacco, 11 problemi di ragionamento a risposta esatta e 1 compito su un documento lungo.
| Modello | Punteggio | Costo (USD) | Tempo (s) |
|---|---|---|---|
| Muse Wonder | 99,7% | 0,64 | 165 |
| Claude Opus 5.5 | 99,4% | 0,75 | 222 |
| GPT-6 Astra | 100,0% | 1,12 | 200 |
| Claude Fable 5.1 | 99,4% | 1,71 | 263 |
| Gemini 3.8 Flash | 99,5% | 0,09 | 139 |
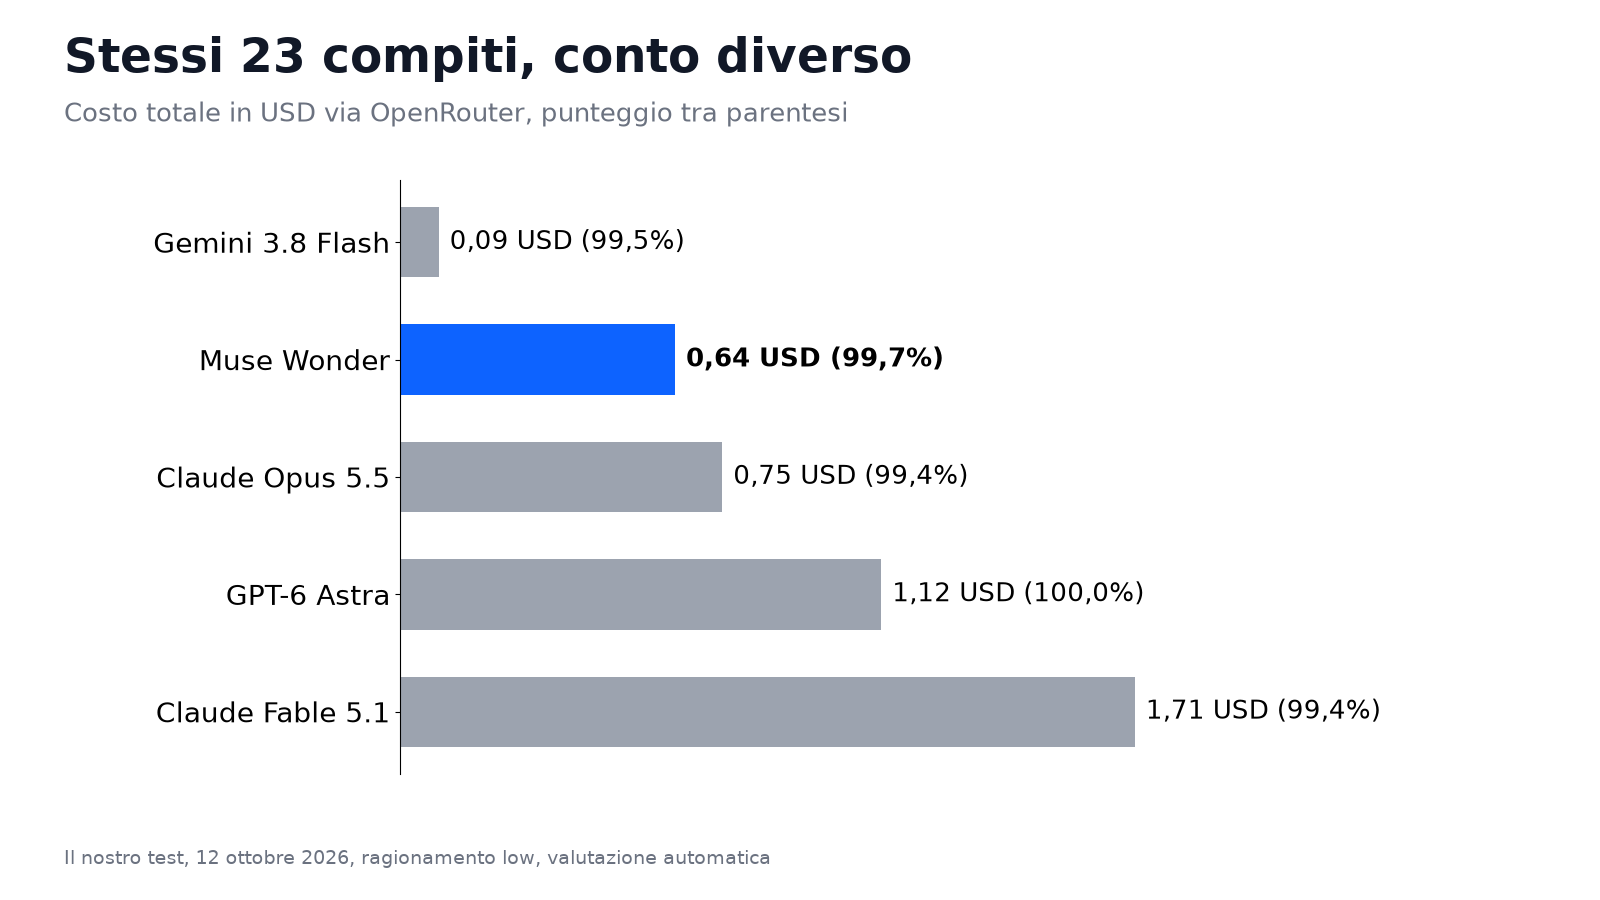
- Muse Wonder ottiene il 99,7% con 0,64 USD, poco sopra Claude Opus 5.5 (99,4%, 0,75 USD) allo stesso prezzo di listino, ed è più veloce: 165 s contro 222 s.
- GPT-6 Astra è l'unico al 100%, ma costa 1,12 USD; Claude Fable 5.1 costa 1,71 USD per il 99,4%.
- Gemini 3.8 Flash arriva al 99,5% con appena 0,09 USD.
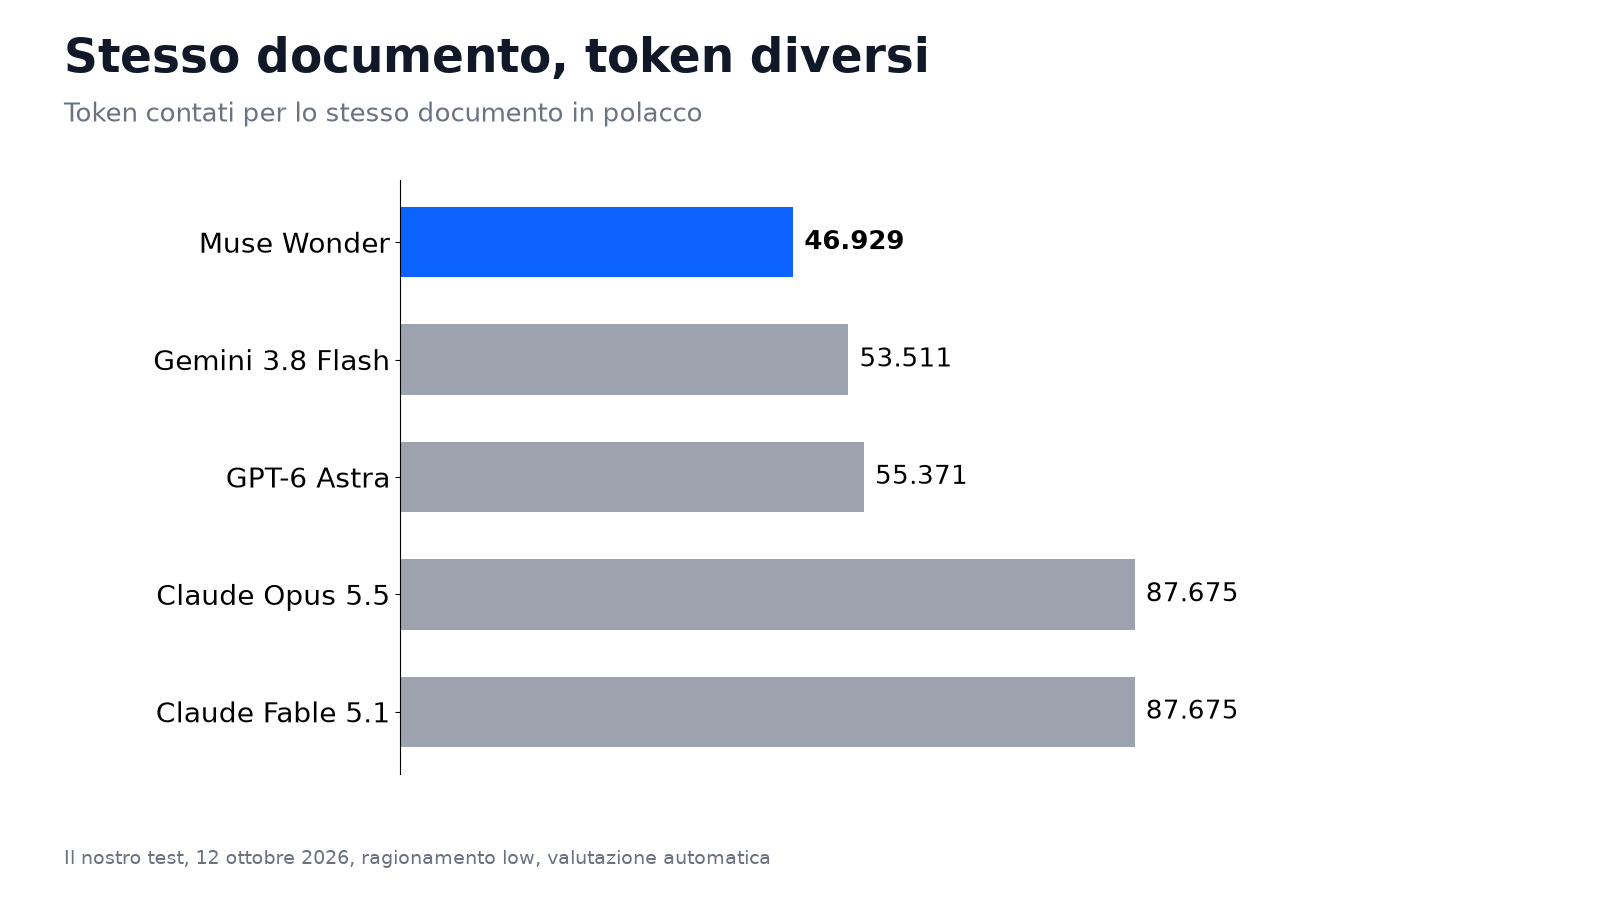
- Lo stesso documento in polacco vale 46.929 token per Muse Wonder e 87.675 per Claude: una domanda su di esso costa 0,193 USD con Muse Wonder e 0,355 USD con Opus 5.5.
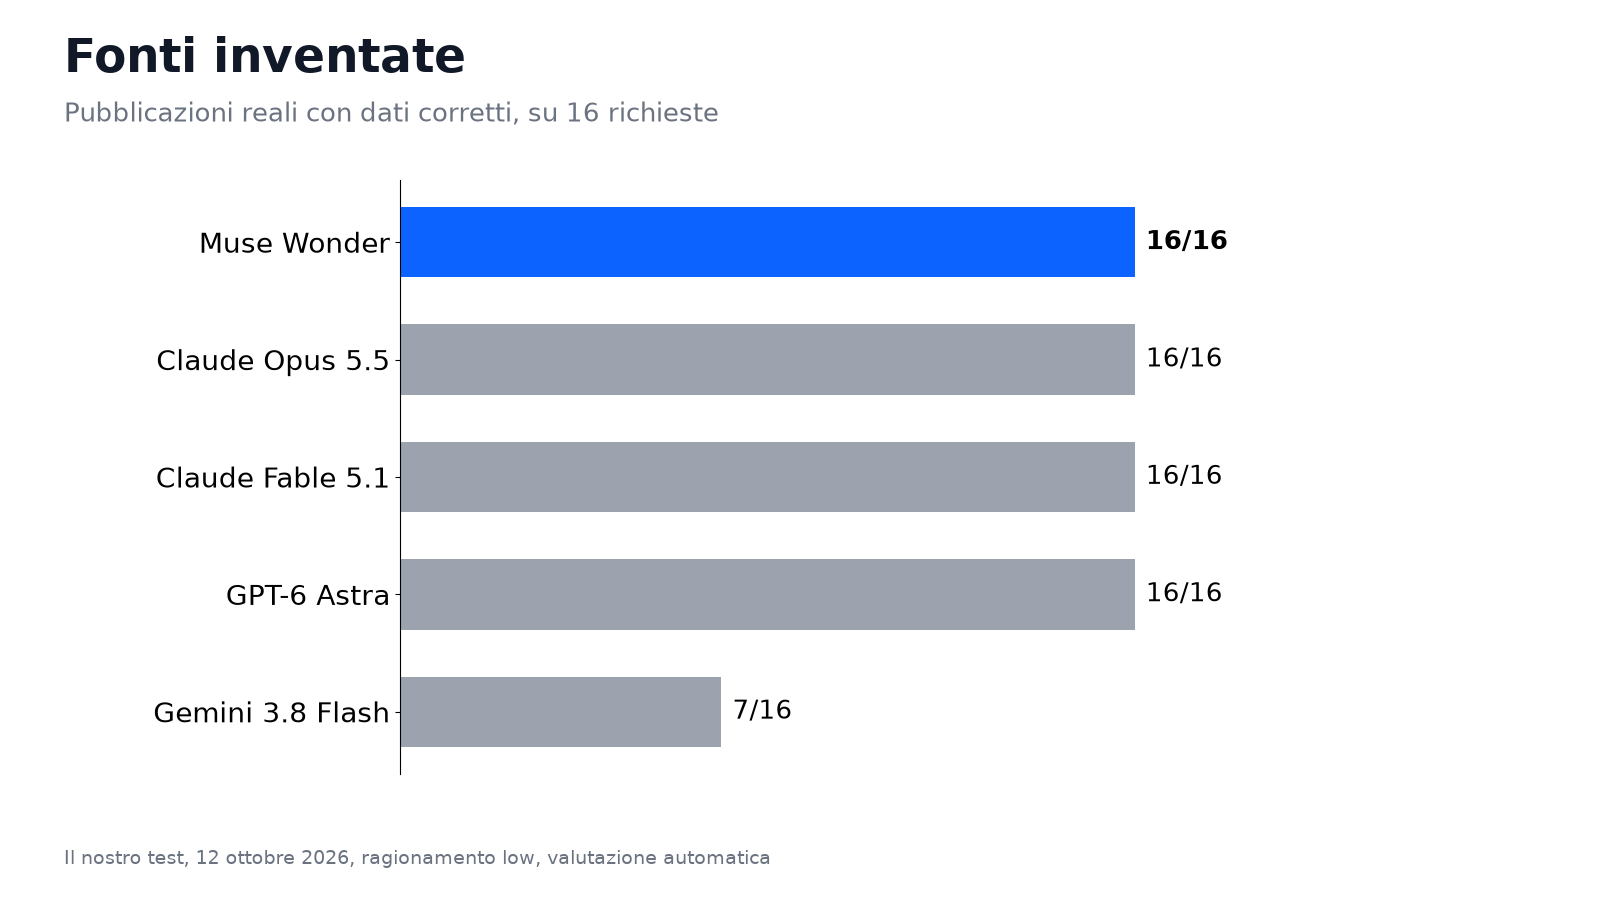
- Fonti inventate: su 8 pubblicazioni reali richieste su 2 temi, Muse Wonder, Opus 5.5, Fable 5.1 e GPT-6 Astra ne danno 16 su 16 reali con dati corretti; Gemini 3.8 Flash solo 7 su 16 (esecuzione precedente, stesso prompt). Verifica su Crossref e OpenAlex.
- L'unico vero errore di Muse Wonder: un numerale inesistente nel codice che scrive gli importi in lettere (superati 15 unit test su 16).
Una sola esecuzione per compito a livello low: differenze sotto 1 punto rientrano nel rumore.
Articoli su questo modello
- Muse Wonder: prezzi API, abbonamenti e costi reali 2026-10-17
- Benchmark Muse Wonder: i 14 test di Meta spiegati 2026-10-14
- Muse Wonder: le migliori alternative a confronto 2026-10-13
- Muse Wonder di Meta: prezzo, benchmark e test 2026-10-12
- Meta presenta Muse Wonder: benchmark e prezzi delle API 2026-10-12
- Muse Wonder vs Claude Opus 5.5, Fable 5.1 e GPT-6 Astra 2026-10-12
- Come usare Muse Wonder: OpenRouter, API e Muse Code 2026-10-12
- Muse Wonder vs Claude Opus 5.5: quale scegliere 2026-10-12
- Muse Wonder vs Opus 5.5 e GPT-6 Astra: test su 23 task 2026-10-12
- Muse Wonder prezzo: costi API, piani e confronti 2026-10-12
Domande frequenti
- Quanto costa utilizzare Muse Wonder via API?
- L'accesso tramite API a Muse Wonder prevede una tariffa di 4 USD per milione di token di input e di 20 USD per milione di token di output, con i token di ragionamento conteggiati come output. L'input in cache costa 0,20 USD per milione di token. Muse Wonder è inoltre compreso in tutti i piani di abbonamento a Muse Code, che partono da 5 USD al mese.
- Come si confronta Muse Wonder con Claude Opus 5.5?
- Entrambi i modelli hanno il medesimo prezzo API di 4 USD in input e 20 USD in output per milione di token. Nei dati comunicati da Meta a massimo sforzo di ragionamento, Muse Wonder supera Claude Opus 5.5 su DeepSWE 1.1 (78,8 contro 74,2) e SWE-Marathon (53,1 contro 46,3), ma ottiene punteggi inferiori su Terminal-Bench 4.0-AA (52,0 contro 59,6) e ProgramBench (50,0 contro 70,5). Sull'Artificial Analysis Intelligence Index, Claude Opus 5.5 raggiunge 58 punti rispetto ai 52 della versione API di Muse Wonder.
- Qual è la differenza tra Muse Wonder e Muse Wonder Full?
- Muse Wonder Full è la variante a capacità più elevate e non dispone di un'interfaccia API, essendo disponibile esclusivamente in Muse Code nei piani Power Usage da 50 USD al mese e Maximum Usage da 200 USD al mese. La documentazione di Meta precisa che impostare il livello di ragionamento su max su Muse Wonder non lo converte nella variante Full. Si tratta infatti di due modelli separati.
- Cosa sono le funzionalità Active Memory e Active Focus?
- Active Memory consente di mantenere le informazioni di contesto sull'utente attraverso sessioni diverse, richiamandole quando sono pertinenti. Active Focus guida il modello verso un obiettivo complesso, provando percorsi alternativi e verificando le azioni importanti prima di eseguirle. Entrambe le capacità sono state presentate da Meta come elementi chiave della nuova serie.
- I prompt inviati tramite API vengono usati per l'addestramento?
- Meta dichiara che nella modalità Standard dell'API i prompt e le risposte non vengono impiegati per addestrare i propri modelli. Al 12 ottobre 2026, l'azienda non ha diffuso un elenco dei paesi in cui il servizio è ufficialmente disponibile. Muse Wonder non disponeva inoltre di una posizione su LMArena alla medesima data.